•14 phút đọc
Tìm hiểu về Tạo sinh tăng cường truy xuất (RAG)

Locionic(@Locionic)
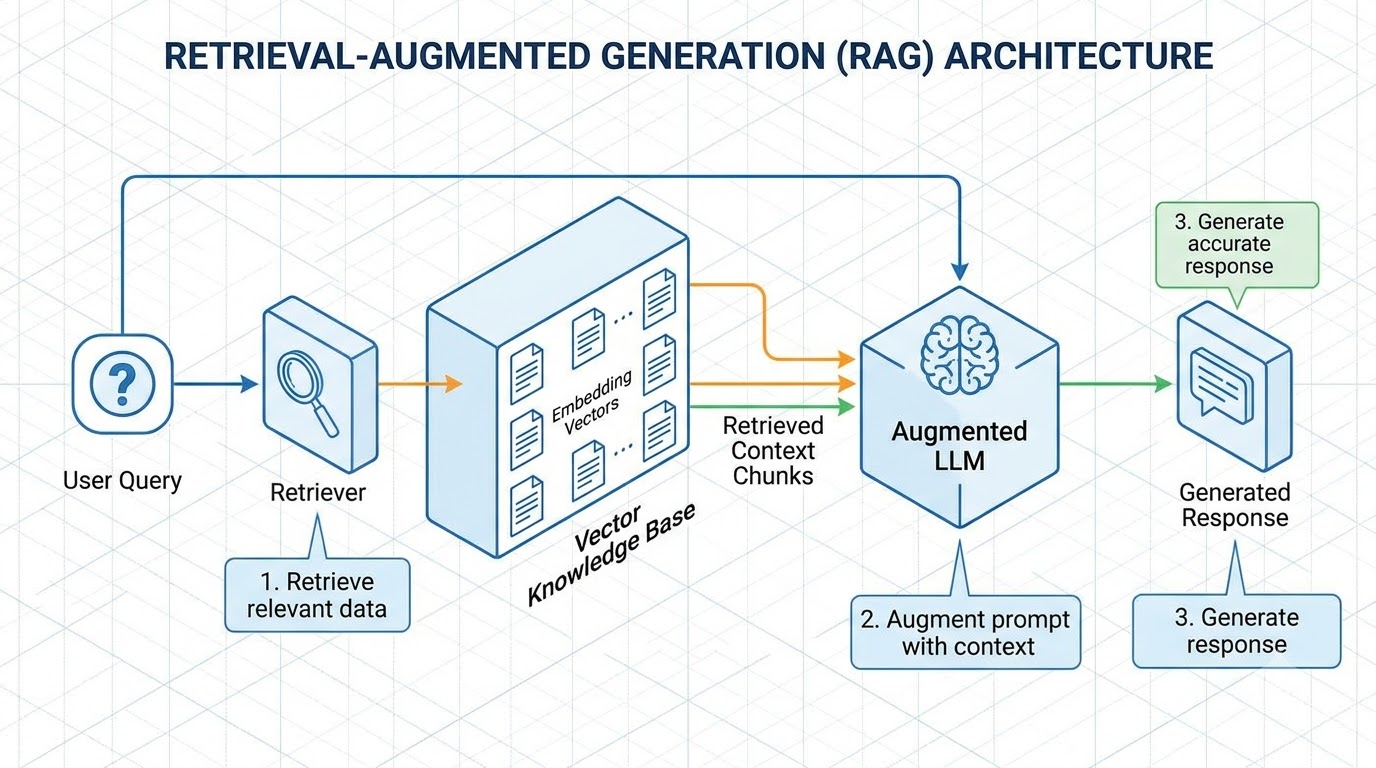
Các Mô hình Ngôn ngữ Lớn (LLM) như Claude, GPT-4 và Llama đã định hình lại nền tảng điện toán hiện đại với khả năng suy luận ngôn ngữ tự nhiên và tổng hợp mã đáng kinh ngạc.
Tuy nhiên, mặc dù có hàng tỷ tham số, LLM vẫn mắc phải hai lỗ hổng chết người khi triển khai trong môi trường doanh nghiệp sản xuất:
- Ảo giác: Xu hướng tạo ra các tuyên bố có vẻ đáng tin cậy, trôi chảy nhưng thực tế lại bịa đặt.
- Giới hạn kiến thức: Không thể truy cập tài liệu nội bộ của công ty, hồ sơ khách hàng trực tiếp hoặc các sự kiện xảy ra sau ngày đào tạo của mô hình.
Trong lịch sử, các tổ chức đã cố gắng giải quyết vấn đề này thông qua tinh chỉnh (fine-tuning). Tuy nhiên, tinh chỉnh tốn kém về mặt tính toán, khó khăn trong việc loại bỏ các sự kiện lỗi thời và không thể cung cấp các trích dẫn nguồn có thể kiểm chứng.
Giải pháp kiến trúc phổ quát là Tạo sinh tăng cường truy xuất (RAG).
RAG thu hẹp khoảng cách giữa khả năng suy luận tham số của LLM và các cơ sở tri thức doanh nghiệp phi tham số, động, đảm bảo tính xác thực và khả năng kiểm toán.
Audio Briefing• Voice: Google Cloud vi-VN-Neural2-A
0:00 / --:--
Khái niệm cốt lõi: Bộ nhớ tham số so với bộ nhớ phi tham số
Để hiểu RAG, chúng ta phải phân biệt giữa hai loại biểu diễn kiến thức trong hệ thống AI:
- Bộ nhớ tham số: Các trọng số tĩnh và hàng tỷ tham số dấu phẩy động được cố định bên trong mạng nơ-ron trong quá trình tiền đào tạo. Nó lưu trữ các mẫu suy luận rộng, quy tắc ngữ pháp và kiến thức thế giới.
- Bộ nhớ phi tham số: Một kho kiến thức bên ngoài, có thể cập nhật động - thường là Cơ sở dữ liệu Vector hoặc công cụ tìm kiếm toàn văn bản chứa các tệp PDF độc quyền, lược đồ cơ sở dữ liệu và tài liệu.
Trong một pipeline RAG, LLM không được coi là một bách khoa toàn thư, mà là một công cụ suy luận phân tích. Khi người dùng đặt câu hỏi, hệ thống truy vấn bộ nhớ phi tham số của nó, truy xuất các đoạn văn bản thực tế liên quan nhất, đưa chúng vào cửa sổ ngữ cảnh của lời nhắc và hướng dẫn LLM: "Trả lời câu hỏi của người dùng CHỈ bằng cách sử dụng các tài liệu tham khảo được cung cấp. Trích dẫn nguồn của bạn."
Kiến trúc RAG sản xuất 3 giai đoạn
Một pipeline RAG cấp sản xuất bao gồm ba giai đoạn tuần tự: Thu nạp, Truy xuất và Tạo sinh.
[ INGESTION ]
Raw Docs ──> Chunking ──> Embedding Model ──> Vector Database (pgvector / Qdrant)

[ RETRIEVAL & RERANKING ]
User Query ──> Hybrid Search (Dense Vector + BM25) ──> Cross-Encoder Reranker ──> Top-K Chunks

[ GENERATION ]
Prompt = Context Chunks + User Query ──> LLM (Claude / GPT-4) ──> Factual Cited Answer
Giai đoạn 1: Thu nạp & Phân đoạn ngữ nghĩa
Bạn không thể chỉ đơn giản đưa một tệp PDF 200 trang vào cơ sở dữ liệu vector dưới dạng một bản ghi duy nhất. Giai đoạn thu nạp chuẩn bị dữ liệu thô để truy xuất độ phân giải cao:
- Trích xuất văn bản: Loại bỏ tiêu đề, chân trang và làm sạch OCR các tài liệu được quét.
- Chiến lược phân đoạn: Chia văn bản thành các phân đoạn riêng biệt. Các chiến lược phổ biến bao gồm:
- Phân đoạn kích thước cố định: Các đoạn 512 token với độ chồng chéo 10% (đơn giản, nhưng có thể cắt đứt ngữ cảnh giữa câu).
- Phân đoạn ngữ nghĩa / đoạn văn: Chia văn bản theo các tiêu đề markdown tự nhiên, đoạn văn hoặc ranh giới câu.
- Phân đoạn phân cấp (Cha-Con): Lưu trữ các đoạn nhỏ (128 token) để khớp vector chi tiết, nhưng trả về đoạn cha lớn hơn bao quanh (1.024 token) cho LLM để bảo toàn ngữ cảnh tường thuật.
- Nhúng vector: Đưa các đoạn qua một mô hình nhúng (như
text-embedding-3-smallhoặcbge-large-en-v1.5) để ánh xạ văn bản vào không gian tọa độ ngữ nghĩa 1.536 chiều.
Giai đoạn 2: Tìm kiếm lai nâng cao & Xếp hạng lại
Các hệ thống RAG đơn giản chỉ dựa vào tìm kiếm tương tự cosine trong cơ sở dữ liệu vector. Trong sản xuất, tìm kiếm vector thuần túy thường thất bại với:
- Số sê-ri sản phẩm hoặc SKU chính xác (
ERR_TIMEOUT_502). - Từ viết tắt và tên cụ thể (
Dr. Loc Nguyen). - Các định danh kỹ thuật hiếm.
Để giải quyết vấn đề này, RAG hiện đại triển khai Tìm kiếm lai, kết hợp Tìm kiếm vector dày đặc (hiểu biết khái niệm ngữ nghĩa) với Tìm kiếm từ khóa thưa thớt (độ chính xác từ vựng BM25) bằng cách sử dụng Hợp nhất thứ hạng đối ứng (RRF):
python
# hybrid_retrieval.py
from collections import defaultdict
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[tuple[str, float]]:
    """
    Fuses ranked lists from vector search and BM25 keyword search.
    RRF Score = sum(1 / (k + rank))
    """
    rrf_scores = defaultdict(float)

    for rank, doc_id in enumerate(dense_results):
        rrf_scores[doc_id] += 1.0 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        rrf_scores[doc_id] += 1.0 / (k + rank + 1)

    # Sort documents by descending fusion score
    sorted_docs = sorted(rrf_scores.items(), key=lambda x: x[1], reverse=True)
    return sorted_docs

# Top-ranked chunks are subsequently passed to a Cross-Encoder Reranker
# (such as Cohere Rerank v3) to compute exact query-to-passage relevance scores.
Bằng cách áp dụng Bộ xếp hạng lại Cross-Encoder (như Cohere Rerank hoặc BGE-Reranker) cho 25 kết quả lai hàng đầu, hệ thống sẽ chấm điểm lại các đoạn dựa trên sự chú ý chéo đầy đủ, đưa ra 3-5 đoạn ngữ cảnh phù hợp nhất cho LLM.
Giai đoạn 3: Tạo sinh & Nhắc nhở có căn cứ
Giai đoạn cuối cùng tổng hợp các đoạn đã truy xuất thành một câu trả lời mạch lạc. Mẫu lời nhắc phải thực thi tính khiêm tốn về mặt nhận thức nghiêm ngặt để ngăn chặn ảo giác:
text
You are an enterprise AI assistant for Loc Corp.
Answer the user's question using ONLY the provided context blocks below.
If the answer cannot be deduced from the context, state clearly: "I cannot answer this based on the available records."
Do not invent information. Always cite chunk references (e.g., [Doc 1]).

--- CONTEXT BLOCKS ---
[Doc 1]: Loc Corp standard SLA provides 99.95% uptime for Enterprise tier customers.
[Doc 2]: Enterprise customer tickets receive a 1-hour initial response window.

--- USER QUESTION ---
What is the SLA uptime guarantee for Enterprise clients?

--- ANSWER ---
Advertisement
Bảng so sánh cơ sở dữ liệu Vector: 2026
| Cơ sở dữ liệu | Loại kiến trúc | Điểm mạnh | Kịch bản lý tưởng |
|---|---|---|---|
| pgvector (PostgreSQL) | Mở rộng quan hệ | Giao dịch ACID, kết nối SQL, không cần hạ tầng mới | Đã chạy Postgres trong sản xuất |
| Qdrant | Công cụ Vector chuyên dụng (Rust) | Lọc tải trọng, HNSW cực nhanh, vector trên đĩa | Các dịch vụ vi mô AI thông lượng cao |
| Pinecone | Máy chủ đám mây được quản lý | Không cần vận hành, tự động mở rộng quy mô | Tạo mẫu nhanh, nhóm không máy chủ |
| Chroma | Nhúng nhẹ / Cục bộ | Thiết lập cục bộ dễ dàng, Python-native | Thiết bị biên, công cụ CLI, kiểm thử đơn vị |
Đánh giá chất lượng RAG: Bộ ba RAG
Bạn không thể tối ưu hóa một pipeline RAG bằng cách kiểm tra thủ công các đầu ra ngẫu nhiên. Các hệ thống sản xuất giám sát Bộ ba RAG (được chính thức hóa bởi các framework như Ragas và TruLens):
- Mức độ liên quan của ngữ cảnh: Công cụ truy xuất có tìm nạp các đoạn văn bản thực sự liên quan đến truy vấn của người dùng không? (Điểm thấp cho thấy phân đoạn kém hoặc không khớp nhúng).
- Tính có căn cứ (Tính trung thực): Mọi tuyên bố thực tế trong phản hồi của LLM có được hỗ trợ chặt chẽ bởi ngữ cảnh đã truy xuất không? (Điểm thấp cho thấy mô hình bị ảo giác).
- Mức độ liên quan của câu trả lời: Phản hồi được tạo ra có trực tiếp trả lời những gì người dùng đã hỏi không? (Điểm thấp cho thấy lời nhắc bị trôi hoặc sự né tránh dài dòng).
Các câu hỏi thường gặp
Tinh chỉnh điều chỉnh các trọng số thần kinh bên trong của mô hình để dạy nó một giọng điệu, phong cách hoặc cú pháp đầu ra cụ thể (như tạo SQL từ ngôn ngữ tự nhiên). RAG cung cấp các dữ kiện bên ngoài, thời gian thực trong ngữ cảnh lời nhắc. Đối với việc truy xuất kiến thức doanh nghiệp, RAG vượt trội hơn nhiều vì việc cập nhật dữ kiện chỉ yêu cầu sửa đổi các hàng cơ sở dữ liệu thay vì chạy hàng ngày đào tạo lại GPU.
Không có con số chung. Đối với tài liệu kỹ thuật dày đặc, 256 đến 512 token với độ chồng chéo 50 token cân bằng tính đặc thù ngữ nghĩa với ngữ cảnh xung quanh đầy đủ. Đối với các hợp đồng pháp lý hoặc các chính sách tường thuật dài, phân đoạn phân cấp (các đoạn tìm kiếm nhỏ 128 token trỏ đến các khối cha 1.024 token) mang lại độ chính xác cao nhất.
Mặc dù RAG giảm ảo giác hơn 90% so với việc tạo sinh LLM thô, nhưng nó không giảm chúng xuống mức tuyệt đối bằng không. Nếu các đoạn được truy xuất chứa các dữ kiện mâu thuẫn, hoặc nếu mô hình bỏ qua các hướng dẫn lời nhắc hệ thống, ảo giác vẫn có thể xảy ra. Sử dụng lời nhắc phủ định nghiêm ngặt ("Chỉ trả lời nếu có trong văn bản") và các hàng rào xác minh tự động là điều cần thiết.
Kiểm tra kiến thức
Interactive Quiz
Question 1 of 2
Một công ty đang xây dựng hệ thống RAG cho tài liệu nội bộ, bao gồm nhiều tài liệu đặc tả kỹ thuật dài và phức tạp. Họ lo ngại LLM sẽ mất ngữ cảnh quan trọng nếu các chunk quá nhỏ, nhưng cũng lo ngại vượt quá context window của LLM nếu các chunk quá lớn. Chiến lược chunking nào sẽ giải quyết tốt nhất những lo ngại này bằng cách cân bằng giữa truy xuất chi tiết và ngữ cảnh toàn diện cho LLM?
Đúc kết kiến trúc & Điểm cốt lõi
Tạo sinh tăng cường truy xuất đã phát triển từ một thủ thuật thử nghiệm thành kiến trúc nền tảng của kỹ thuật AI doanh nghiệp.
Bằng cách kết hợp phân đoạn phân cấp, tìm kiếm lai dày đặc/thưa thớt với Hợp nhất thứ hạng đối ứng, xếp hạng lại cross-encoder và khả năng quan sát Bộ ba RAG, các nhóm kỹ thuật có thể xây dựng các ứng dụng AI đáng tin cậy, sẵn sàng kiểm toán, khai thác toàn bộ giá trị của kiến thức độc quyền của công ty.
Bạn cũng có thể thích
Chia sẻ bài viết:
Tiện ích lập trình viên
Công cụ lập trình trực tiếp trên trình duyệt
Làm sạch log AI CLI, tạo biểu thức cron, giải mã JWT và tính quyền chmod offline.
Advertisement
Bài viết liên quan
ai
Cơ sở dữ liệu Vector cho RAG sản xuất (2026): Pinecone vs Qdrant vs Milvus vs pgvector
Đánh giá kiến trúc của Pinecone, Qdrant, Milvus và pgvector cho các pipeline RAG sản xuất: lập chỉ mục HNSW vs IVFFlat, tìm kiếm được lọc một giai đoạn, độ trễ p95 và mức sử dụng bộ nhớ.
Đọc tiếp
ai
LangChain vs LlamaIndex (2026): Hướng dẫn xây dựng pipeline RAG sản xuất
So sánh kiến trúc của LangChain và LlamaIndex cho các pipeline RAG sản xuất: phân tích tài liệu, lập chỉ mục vector, định tuyến truy vấn và điểm chuẩn độ trễ.
Đọc tiếp
ai
RAG tác nhân có trạng thái: Máy trạng thái đồ thị, vòng lặp tự sửa lỗi & định tuyến dự phòng
Hướng dẫn toàn diện về RAG tác nhân có trạng thái: máy trạng thái đồ thị, vòng lặp tự sửa lỗi & định tuyến dự phòng với kiến trúc cấp độ sản xuất và ví dụ code.
Đọc tiếp