Cơ sở dữ liệu Vector cho RAG sản xuất (2026): Pinecone vs Qdrant vs Milvus vs pgvector

Nếu bạn đang triển khai hệ thống Retrieval-Augmented Generation (RAG) vào năm 2026, việc chọn sai kho lưu trữ vector có thể nhanh chóng làm trật bánh kiến trúc của bạn. Những gì hoạt động dễ dàng trong một notebook demo nhanh với 10.000 vector sẽ thường xuyên gặp phải các nút thắt cổ chai nghiêm trọng về bộ nhớ, tăng độ trễ hoặc chi phí cơ sở hạ tầng cấm đoán khi tập dữ liệu của bạn mở rộng lên hàng triệu embedding doanh nghiệp đa người thuê.
Bức tranh cơ sở dữ liệu vector đã trưởng thành nhanh chóng. Trong khi các kiến trúc GenAI ban đầu coi tất cả các kho lưu trữ vector là những hộp đen có thể hoán đổi cho nhau, kỹ thuật sản xuất đòi hỏi phải điều hướng các đánh đổi cụ thể giữa các công cụ gốc chuyên dụng (như Qdrant, Milvus và Pinecone) và các tiện ích mở rộng cơ sở dữ liệu quan hệ (như PostgreSQL với pgvector).
Trong hướng dẫn kiến trúc này, chúng tôi phân tích cách các thuật toán lập chỉ mục vector hoạt động bên dưới, so sánh bốn giải pháp cơ sở dữ liệu vector hàng đầu dựa trên các tiêu chuẩn thực tế, phân tích chi phí lọc siêu dữ liệu và cung cấp các triển khai Python sẵn sàng cho sản xuất.
💡 Lưu ý Kiến trúc: Đối với các hệ thống RAG sản xuất, việc lựa chọn giữa lập chỉ mục phẳng, đảo ngược hoặc dựa trên đồ thị quyết định liệu độ trễ truy vấn có tăng tuyến tính O(N) hay logarit O(log N) với kích thước tập dữ liệu vector của bạn.
1. Cách lập chỉ mục Vector hoạt động: HNSW so với IVFFlat so với DiskANN
Các cơ sở dữ liệu vector không thực hiện quét bảng tuần tự. Tìm kiếm một tập dữ liệu gồm 5 triệu vector 1.536 chiều thông qua khoảng cách Euclidean chính xác hoặc độ tương đồng Cosine yêu cầu tính toán hàng tỷ phép toán dấu phẩy động cho mỗi truy vấn, dẫn đến thời gian phản hồi nhiều giây.
Để đạt được độ trễ tìm kiếm dưới 20ms, các cơ sở dữ liệu vector sử dụng các thuật toán lập chỉ mục Approximate Nearest Neighbor (ANN). Hiểu cơ chế của các thuật toán này là rất quan trọng khi chọn cơ sở dữ liệu.
┌─────────────────────────────────────────────────────────────────────────┐
│                      Vector Indexing Architecture                       │
├──────────────────────────┬──────────────────────┬───────────────────────┤
│ Algorithm                │ Memory Footprint     │ Query Speed / Recall  │
├──────────────────────────┼──────────────────────┼───────────────────────┤
│ Exact Scan (Flat)        │ Low (disk or RAM)    │ O(N) - Slow           │
│ IVFFlat (Inverted File)  │ Moderate             │ O(sqrt(N)) - Fast     │
│ HNSW (Navigable Graph)   │ High (Full RAM)      │ O(log N) - Ultra-fast │
│ DiskANN / Quantized HNSW │ Very Low (SSD + RAM) │ O(log N) - Optimized  │
└──────────────────────────┴──────────────────────┴───────────────────────┘
Hierarchical Navigable Small World (HNSW)
HNSW là tiêu chuẩn vàng hiện tại cho tốc độ tìm kiếm vector và độ chính xác recall. Nó xây dựng một đồ thị hình học đa lớp:
- Các lớp trên cùng chứa các nút thưa thớt với các cạnh tầm xa, cho phép các truy vấn tìm kiếm đi qua các khoảng cách tô pô lớn với rất ít bước nhảy.
- Khi tìm kiếm hội tụ gần khu vực mục tiêu, nó sẽ chuyển xuống các lớp dày đặc hơn, thấp hơn để điều hướng cục bộ chi tiết.
- Đánh đổi: HNSW tốn nhiều bộ nhớ. Cả vector và toàn bộ cấu trúc đồ thị thường phải nằm trong RAM. Lưu trữ 10 triệu vector float32 1.536 chiều trong HNSW thuần túy có thể dễ dàng tiêu thụ 70GB+ đến 100GB bộ nhớ.
Inverted File Index (IVFFlat)
IVFFlat phân vùng không gian vector thành các ô Voronoi bằng cách sử dụng phân cụm k-means:
- Trong quá trình lập chỉ mục, các vector được gán cho tâm cụm gần nhất của chúng.
- Tại thời điểm truy vấn, công cụ chỉ tính toán khoảng cách đến k tâm cụm gần nhất và kiểm tra các vector nằm bên trong các cụm cụ thể đó.
- Đánh đổi: IVFFlat yêu cầu đào tạo lại định kỳ khi phân bố vector thay đổi. Mặc dù mức tiêu thụ bộ nhớ của nó thấp hơn đáng kể so với HNSW, nhưng nó bị giảm recall khi các truy vấn rơi vào ranh giới cụm.
Vector Quantization (Scalar & Product Quantization)
Các công cụ sản xuất hiện đại kết hợp HNSW với các thuật toán lượng tử hóa:
- Scalar Quantization (SQ8): Nén các số dấu phẩy động 32 bit thành các số nguyên 8 bit, giảm yêu cầu bộ nhớ 75% với suy giảm recall không đáng kể (thường dưới 1%).
- Product Quantization (PQ): Phân tách các vector chiều cao thành các vector con nhỏ hơn và ánh xạ chúng đến các sổ mã cụm, nén dấu chân bộ nhớ lên đến 95%.
2. Pinecone so với Qdrant so với Milvus so với pgvector: Ma trận Kiến trúc
Mỗi công cụ được xây dựng dựa trên một triết lý kỹ thuật riêng biệt. Dưới đây là cách chúng so sánh trên các khía cạnh kiến trúc cốt lõi:
| Khía cạnh | Pinecone (Serverless) | Qdrant | Milvus 2.4+ | PostgreSQL + pgvector 0.7+ |
|---|---|---|---|---|
| Kiến trúc | Đám mây được quản lý độc quyền | Lõi Rust gốc | Go/C++ phân tán | Tiện ích mở rộng quan hệ (C) |
| Chế độ triển khai | SaaS được quản lý hoàn toàn | Mã nguồn mở / Đám mây / Docker | K8s phân tán / Đám mây | Postgres đơn / RDS / Supabase |
| Thuật toán chỉ mục | Đồ thị phân đoạn độc quyền | HNSW, HNSW lượng tử hóa | HNSW, IVF, SCaNN, DiskANN | HNSW, IVFFlat, HNSW SQ |
| Lọc siêu dữ liệu | Bộ lọc serverless một giai đoạn | HNSW được lọc một giai đoạn | Công cụ tiền/hậu lọc | Tích hợp WHERE SQL gốc |
| Tái lập chỉ mục dưới tải | Xây dựng serverless nền (không ảnh hưởng ứng dụng) | Hợp nhất phân đoạn LSM (không khóa truy vấn) | IndexNodes tách rời qua bộ lưu trữ đối tượng | CREATE INDEX CONCURRENTLY (cạnh tranh CPU/RAM) |
| Đa người thuê | Không gian tên / Siêu dữ liệu | Phân vùng tải trọng / Khóa | Khóa phân vùng / Bộ sưu tập | Bảo mật cấp hàng (RLS) |
| Dấu chân RAM | Tách rời (S3 + tầng NVMe) | Tối ưu hóa (Rust + mmap) | Trung bình-Cao (tầng Go/C++) | Nhóm bộ đệm Postgres dùng chung |
| Tốt nhất cho | Quy mô serverless không cần vận hành | Microservice Rust thông lượng cao | Tập dữ liệu phân tán lớn (100M+) | Các nhóm đã chạy PostgreSQL |
3. Tìm hiểu sâu: Đánh giá từng đối thủ
Qdrant: Cỗ máy Rust thông lượng cao
Qdrant đã nổi lên như một công cụ được các nhà phát triển yêu thích cho RAG doanh nghiệp. Được viết bằng Rust, nó mang lại khả năng quản lý bộ nhớ có thể dự đoán được, không có độ trễ tăng đột biến do thu gom rác và sử dụng tối ưu các lệnh SIMD của CPU (AVX-512, ARM Neon).
Ưu điểm chính:
- Tìm kiếm được lọc một giai đoạn: Các công cụ vector truyền thống thường thực hiện lọc siêu dữ liệu trước (tiền lọc, có thể phá hủy khả năng điều hướng đồ thị) hoặc sau khi truy xuất vector (hậu lọc, gây ra các tập kết quả trống nếu các kết quả khớp top-k bị lọc). Qdrant tích hợp kiểm tra siêu dữ liệu trực tiếp vào vòng lặp duyệt HNSW, đảm bảo giới hạn nghiêm ngặt và recall cao đồng thời.
- Lưu trữ tải trọng: Qdrant lưu trữ siêu dữ liệu JSON tùy ý cùng với các vector, hỗ trợ các mảng lồng nhau, khớp toàn văn bản và tọa độ địa lý mà không yêu cầu tra cứu kho tài liệu bên ngoài.
- Ánh xạ bộ nhớ: Bạn có thể cấu hình các vector và chỉ mục tải trọng nằm trên SSD NVMe thông qua
mmap, chỉ lưu trữ đồ thị điều hướng HNSW trong bộ nhớ cache.
pgvector: Ngăn xếp dữ liệu hợp nhất
pgvector biến các phiên bản PostgreSQL hiện có thành các công cụ tìm kiếm vector đầy đủ khả năng. Nếu sản phẩm của bạn đã lưu trữ người dùng, tài liệu, quyền và hồ sơ thanh toán trong PostgreSQL, việc sử dụng pgvector loại bỏ toàn bộ một loại phức tạp về đồng bộ hóa, tính nhất quán ghi kép và ETL.
Ưu điểm chính:
- Giao dịch nguyên tử & ACID: Bạn chèn tài liệu, siêu dữ liệu quan hệ và nhúng vector trong một giao dịch nguyên tử duy nhất. Không có rủi ro về các bản ghi vector mồ côi hoặc độ trễ lập chỉ mục.
- Bảo mật cấp hàng của Postgres (RLS): Đa người thuê doanh nghiệp có thể được thực thi nguyên bản thông qua các chính sách SQL. Một truy vấn nhúng tự động tuân thủ các ranh giới người thuê của người dùng:
sql
CREATE POLICY tenant_isolation_policy ON document_embeddings USING (tenant_id = current_setting('app.current_tenant_id')::uuid); - Tìm kiếm kết hợp trong một công cụ: Với
pgvector, bạn có thể kết hợp các truy vấn vector ngữ nghĩa với tìm kiếm toàn văn bản của PostgreSQL (tsvector) và các bộ lọc SQL có cấu trúc trong một truy vấn duy nhất bằng cách sử dụng Reciprocal Rank Fusion (RRF).
Milvus: Khả năng mở rộng cho hơn 100 triệu Vector
Milvus được thiết kế từ đầu cho các môi trường dữ liệu phân tán, lớn. Nó tách rời tính toán và lưu trữ thành các microservice không trạng thái riêng biệt (Coordinator, Query Nodes, Data Nodes, Index Nodes) được hỗ trợ bởi bộ lưu trữ đối tượng (MinIO hoặc S3) và các bộ môi giới tin nhắn (Kafka hoặc Pulsar).
Ưu điểm chính:
- Có khả năng lập chỉ mục hàng trăm triệu embedding trên các cụm worker Kubernetes.
- Hỗ trợ gốc cho lập chỉ mục tăng tốc GPU (NVIDIA RAPIDS cuVS) để nhập hàng loạt quy mô lớn theo thời gian thực.
Pinecone: Serverless được quản lý không cần bảo trì
Kiến trúc Serverless của Pinecone tách rời lập chỉ mục vector khỏi tính toán thô. Thay vì cung cấp các nút VM chuyên dụng chạy liên tục, Pinecone lập chỉ mục các vector vào bộ lưu trữ blob chi phí thấp và tự động khởi động các bộ nhớ đệm đọc tạm thời khi các truy vấn tìm kiếm đến.
Ưu điểm chính:
- Không yêu cầu lập kế hoạch dung lượng, quản lý phân đoạn hoặc cung cấp đĩa.
- Mô hình định giá trả theo mức sử dụng giảm xuống gần bằng 0 khi không hoạt động, làm cho nó hấp dẫn đối với các sản phẩm giai đoạn đầu có lưu lượng truy cập đột biến hoặc không thể đoán trước.
Thực tế vận hành: Tái lập chỉ mục trong khi phục vụ
Một thuộc tính vận hành quan trọng thường bị bỏ qua trong các so sánh cơ sở dữ liệu vector là hành vi trong quá trình thay đổi chỉ mục trực tiếp và xây dựng lại nền:
- Qdrant (Hợp nhất phân đoạn kiểu LSM): Qdrant ghi các vector mới vào các phân đoạn trong bộ nhớ có thể thay đổi. Khi một phân đoạn đạt đến ngưỡng dung lượng, nó sẽ đóng băng và chuyển đổi thành một phân đoạn HNSW bất biến thông qua các worker nền. Các worker truy vấn tiếp tục tìm kiếm các phân đoạn hoạt động và lịch sử mà không có khóa toàn cục, loại bỏ độ trễ truy vấn trong quá trình nhập thông lượng cao.
- Milvus (IndexNodes không trạng thái): Milvus tách rời việc thực thi truy vấn khỏi việc xây dựng chỉ mục thành các microservice tách rời. Các nút worker được chỉ định là
IndexNodeskéo các phân đoạn vector từ bộ lưu trữ đối tượng (S3/MinIO) và xây dựng các cấu trúc HNSW hoặc DiskANN một cách độc lập.QueryNodesphục vụ lưu lượng truy cập trực tiếp hoàn toàn cách ly khỏi áp lực CPU và bộ nhớ trong quá trình xây dựng lại chỉ mục. - PostgreSQL + pgvector (Cạnh tranh tài nguyên): Trong PostgreSQL, việc xây dựng lại chỉ mục đồng thời (
CREATE INDEX CONCURRENTLY ... USING hnsw) tránh các khóa ghi bảng độc quyền, nhưng việc xây dựng đồ thị HNSW rất tốn CPU và I/O. Nó tiêu thụmaintenance_work_memvà bão hòa các lõi CPU, điều này trực tiếp cạnh tranh với nhóm bộ đệm dùng chung của PostgreSQL và các worker giao dịch đang hoạt động trừ khi được ủy quyền cho một bản sao đọc bị cô lập. - Pinecone (Cách ly Serverless được quản lý): Trong kiến trúc serverless của Pinecone, việc xây dựng chỉ mục chạy hoàn toàn trong mặt phẳng điều khiển đám mây của Pinecone. Ứng dụng khách không phải chịu chi phí tính toán hoặc bộ nhớ, mặc dù các vector mới được nhập có độ trễ lan truyền ngắn trước khi xuất hiện trong các truy vấn đọc.
4. Tiêu chuẩn sản xuất: Độ trễ, Recall và QPS
Chúng tôi đã đánh giá một tập dữ liệu nhúng 1.536 chiều tiêu chuẩn (1.000.000 vector được tạo thông qua text-embedding-3-small) trên bốn triển khai đại diện chạy trên phần cứng tính toán 8-vCPU / 32GB RAM giống hệt nhau (với Pinecone được đo thông qua Serverless us-east-1 tiêu chuẩn):
┌────────────────────────────────────────────────────────────────────────┐
│               1M Vectors (1,536-dim) Benchmark Comparison              │
├─────────────────────┬──────────────┬──────────────┬────────────────────┤
│ Vector Engine       │ p95 Latency  │ Max QPS      │ Recall @ 10        │
├─────────────────────┼──────────────┼──────────────┼────────────────────┤
│ Qdrant (HNSW + SQ)  │ 6.8 ms       │ 1,240 req/s  │ 98.4%              │
│ Milvus 2.4 (HNSW)   │ 8.4 ms       │ 1,080 req/s  │ 98.1%              │
│ Pinecone Serverless │ 28.5 ms      │ Elastic      │ 97.6%              │
│ pgvector 0.7 (HNSW) │ 14.2 ms      │ 420 req/s    │ 97.2%              │
└─────────────────────┴──────────────┴──────────────┴────────────────────┘
Những điểm chính từ dữ liệu:
- Tốc độ công cụ thô: Các công cụ được biên dịch gốc (Qdrant và Milvus) đạt độ trễ p95 thấp nhất và số truy vấn mỗi giây thô cao nhất nhờ song song SIMD C++/Rust chuyên dụng.
- Chi phí quan hệ:
pgvectorphát sinh chi phí nhỏ do xử lý kết nối PostgreSQL và kiểm tra khả năng hiển thị tuple MVCC, nhưng độ trễ ~14ms của nó vẫn nằm trong ngân sách chấp nhận được cho các quy trình làm việc chatbot và tác nhân tương tác. - Số bước nhảy mạng Serverless: Pinecone Serverless giới thiệu độ trễ đuôi cao hơn (~25-30ms) do truyền tải mạng TLS và tra cứu tầng lưu trữ blob, nhưng loại bỏ tất cả chi phí quản lý cơ sở hạ tầng.
⚠️ Tiết lộ phương pháp: Thực tế tiền lọc so với hậu lọc
Các số liệu tiêu chuẩn trên báo cáo truy xuất láng giềng gần nhất thô trên một chỉ mục không lọc hoặc các phân vùng rộng. Trong RAG sản xuất, cách lọc siêu dữ liệu (
tenant_id = 'org_42',status = 'active') được triển khai thay đổi cơ bản recall và độ trễ:
- Hậu lọc (Lọc sau tìm kiếm): Công cụ tìm kiếm đồ thị HNSW toàn cầu cho các vector top-k trước, sau đó loại bỏ các bản ghi không đáp ứng điều kiện siêu dữ liệu. Khi các bộ lọc có chọn lọc (ví dụ: chỉ 1% tài liệu khớp), hậu lọc âm thầm trả về ít hơn k kết quả (hoặc tập trống), dẫn đến suy giảm recall âm thầm trong khi biểu đồ độ trễ xuất hiện nhanh một cách giả tạo.
- Tiền lọc / Lọc một giai đoạn: Công cụ cắt tỉa các nút ứng cử viên trong quá trình duyệt đồ thị. Trong khi các công cụ gốc như Qdrant điều hướng các bitset tải trọng bên trong bước khám phá HNSW, tiền lọc ngây thơ trên các đồ thị con thưa thớt có thể làm kẹt các lần duyệt trong các cụm bị ngắt kết nối.
- Chuẩn hóa số lượng ứng viên (Độ thưa thớt so với mất mát kế hoạch truy vấn): Khi đánh giá recall có lọc, các bài đánh giá phải báo cáo số lượng ứng viên hợp lệ (C) và chuẩn hóa recall theo \min(k, C). Nếu chỉ có 4 bản ghi trong tập 1 triệu vector khớp với bộ lọc, việc lấy ra 4 mục đại diện cho 100% recall ứng viên hợp lệ. Việc gán điểm 4/10 là "độ chính xác tìm kiếm kém" là nhầm lẫn giữa độ thưa thớt dữ liệu với việc mất mát ứng viên do kế hoạch truy vấn.
- Xác thực tái lập chỉ mục qua tham chiếu lọc chính xác: Độ trễ truy vấn khỏe mạnh trong quá trình xây dựng lại chỉ mục nền (hợp nhất LSM của Qdrant, IndexNode của Milvus, hoặc
CREATE INDEX CONCURRENTLYcủa Postgres) không chứng minh tính nhất quán của chỉ mục. Việc đánh giá nghiêm ngặt đòi hỏi chạy khối lượng truy vấn và vị từ giống hệt nhau đối chiếu với tham chiếu quét phẳng vét cạn chính xác để xác nhận chất lượng ứng viên không bị suy giảm khi các phân đoạn hợp nhất.- Đóng băng vị từ hợp lệ và bản chụp corpus (Tính ổn định của Ground Truth): Khi chạy kiểm tra đối chiếu quét phẳng song song với việc nạp dữ liệu trực tiếp hoặc tái lập chỉ mục, bản chụp corpus và các vị từ hợp lệ phải được đóng băng nghiêm ngặt cho cả hai đường dẫn đánh giá. Nếu các cập nhật nền liên tục làm biến đổi siêu dữ liệu của tài liệu hoặc thay đổi cờ điều kiện, sự dịch chuyển của tập ứng viên sẽ tạo ra sai lệch giả tạo trông như một sự suy giảm recall của chỉ mục ANN.
- Theo dõi thế hệ chỉ mục (Index Generation) trên từng truy vấn: Các bản ghi truy vấn cần gắn thẻ
index_generation(hoặc snapshot/epoch ID) để tách biệt hiệu năng qua từng giai đoạn của vòng đời tái lập chỉ mục. Việc tái lập chỉ mục không phải là trạng thái nguyên khối: các truy vấn có thể chạm vào chỉ mục cũ, vùng đệm ghi thay đổi (delta buffer), thời điểm bàn giao chuyển đổi (handover cutover), hay phân đoạn mới hợp nhất. Việc tính trung bình recall và độ trễ trên toàn bộ quá trình tái lập chỉ mục sẽ che lấp đi việc suy giảm recall nghiêm ngặt tại thời điểm bàn giao hoặc nghẽn cổ chai duyệt vùng đệm chưa lập chỉ mục đằng sau con số p95 tổng thể.- Đánh đổi vận hành ghi kép: Trong khi các công cụ chuyên dụng đạt QPS thô gấp 2-3 lần
pgvector, các tiêu chuẩn hiếm khi nắm bắt được chi phí vận hành của ghi kép. Khi các vector nằm trực tiếp trong PostgreSQL, các giao dịch ACID đảm bảo các bản ghi nguồn và embedding không bao giờ bị lệch, giúp các nhóm không phải chạy các đường ống đối chiếu ngoài băng phức tạp.
5. Triển khai: Truy vấn Vector sản xuất trong Python
Hãy cùng xem cách triển khai tìm kiếm vector được lọc một giai đoạn trong sản xuất bằng cả Qdrant và PostgreSQL pgvector.
Ví dụ A: Tìm kiếm Vector được lọc với Qdrant
# Production Qdrant search with single-stage metadata filtering
from qdrant_client import QdrantClient
from qdrant_client.http import models

client = QdrantClient(url="https://qdrant-cluster.example.com", api_key="qdrant_secret_key")

def query_knowledge_base(
    query_vector: list[float],
    tenant_id: str,
    department: str,
    limit: int = 5
) -> list[dict]:
    # Execute single-stage filtered similarity search
    results = client.search(
        collection_name="enterprise_documents",
        query_vector=query_vector,
        query_filter=models.Filter(
            must=[
                models.FieldCondition(
                    key="tenant_id",
                    match=models.MatchValue(value=tenant_id),
                ),
                models.FieldCondition(
                    key="department",
                    match=models.MatchValue(value=department),
                ),
            ]
        ),
        limit=limit,
        with_payload=True,
    )

    return [
        {
            "id": hit.id,
            "score": hit.score,
            "title": hit.payload.get("title"),
            "content": hit.payload.get("text_chunk"),
        }
        for hit in results
    ]
Ví dụ B: Tìm kiếm Vector nguyên tử với PostgreSQL & pgvector
# Production async pgvector query using asyncpg connection pool
import asyncpg

async def search_pgvector_knowledge_base(
    pool: asyncpg.Pool,
    tenant_id: str,
    query_embedding: list[float],
    top_k: int = 5
) -> list[dict]:
    # Query uses HNSW index via Cosine Distance operator (<=>)
    query = """
        SELECT
            id,
            document_title,
            chunk_content,
            1 - (embedding <=> $1::vector) AS cosine_similarity
        FROM document_chunks
        WHERE tenant_id = $2
        ORDER BY embedding <=> $1::vector
        LIMIT $3;
    """

    # Format embedding as string literal '[0.012, -0.045, ...]'
    embedding_str = f"[{','.join(str(x) for x in query_embedding)}]"

    async with pool.acquire() as conn:
        rows = await conn.fetch(query, embedding_str, tenant_id, top_k)
        return [dict(row) for row in rows]
6. Khung quyết định: Bạn nên chọn cái nào?
Để tránh thiết kế quá mức cơ sở hạ tầng của bạn, hãy làm theo quy tắc quyết định kiến trúc này:
-
Chọn
pgvectornếu:- Bạn đã sử dụng PostgreSQL làm cơ sở dữ liệu chính của mình.
- Tập dữ liệu vector của bạn dưới 10 triệu embedding.
- Bạn yêu cầu các giao dịch ACID nghiêm ngặt, các phép nối SQL phức tạp với tài khoản người dùng hoặc Bảo mật cấp hàng của PostgreSQL.
- Bạn muốn sự phức tạp cơ sở hạ tầng tối thiểu mà không cần thêm dịch vụ nào để giám sát.
-
Chọn
Qdrantnếu:- Bạn cần thông lượng truy vấn tối đa (>1.000 QPS) với độ trễ p95 dưới 10ms.
- Bạn yêu cầu lọc tải trọng một giai đoạn nâng cao (ví dụ: điều kiện JSON lồng nhau, khoảng cách địa lý, lọc toàn văn bản).
- Bạn muốn một microservice vector chuyên dụng có thể triển khai trên Docker tự lưu trữ, Kubernetes hoặc đám mây tại chỗ có chủ quyền.
-
Chọn
Milvusnếu:- Bạn đang hoạt động ở quy mô siêu lớn (>50M đến 1B+ vector) trên một cụm Kubernetes chuyên dụng.
- Bạn có các nhóm kỹ thuật dữ liệu và nền tảng chuyên dụng để quản lý các thành phần cụm phân tán.
-
Chọn
Pineconenếu:- Bạn muốn không cần bảo trì vận hành và không có năng lực DevOps chuyên dụng.
- Ứng dụng của bạn trải qua khối lượng truy vấn đột biến, không đều, nơi thanh toán serverless mang lại lợi ích chi phí so với các phiên bản được cung cấp chuyên dụng.
7. Cơ chế thuật toán: So sánh Flat Scan, IVFFlat và HNSW
Để thực sự nắm vững tìm kiếm chiều cao mà không coi các kho vector là hộp đen, việc hiểu cơ chế thuật toán cơ bản là điều cần thiết. So sánh quét tuyến tính vét cạn O(N), IVFFlat được phân vùng Voronoi O(sqrt(N)) và duyệt đồ thị HNSW đa lớp O(log N) cho thấy lý do tại sao các kiến trúc đồ thị thống trị việc truy xuất hiện đại:
┌────────────────────────────────────────────────────────────────────────┐
│                 Algorithmic Comparison (50,000 Vectors)                │
├─────────────────┬─────────────┬──────────────┬───────────┬─────────────┤
│ Index Type      │ Complexity  │ Latency(p50) │ Recall@10 │ Speedup     │
├─────────────────┼─────────────┼──────────────┼───────────┼─────────────┤
│ Exact Flat Scan │ O(N)        │ 842.60 ms    │ 100.0%    │ Baseline    │
│ IVFFlat (Lloyd) │ O(sqrt(N))  │  88.40 ms    │  46.5%    │ 9.5x faster │
│ HNSW Graph      │ O(log N)    │   1.40 ms    │  66.5%    │ 600x faster │
└─────────────────┴─────────────┴──────────────┴───────────┴─────────────┘
HNSW mang lại hiệu suất truy vấn dưới mili giây thông qua thiết kế skip-list hình học của nó:
- Lớp đường cao tốc tốc hành: Các cấp trên thưa thớt thực hiện các bước nhảy tầm xa tham lam trên không gian vector để nhanh chóng hội tụ gần các lưu vực cục bộ mục tiêu.
- Lớp mặt đất dày đặc: Cấp 0 thực hiện tìm kiếm chùm đa ứng cử viên được theo dõi bằng hàng đợi ưu tiên có giới hạn, cắt tỉa các kết nối đến mức độ tối đa M để duy trì tính cục bộ của bộ đệm và kiểm soát chi phí bộ nhớ.
Bằng cách điều chỉnh mức độ kết nối M và độ sâu khám phá ef_search, các công cụ vector hiện đại cung cấp cho các kỹ sư quyền kiểm soát trực tiếp sự đánh đổi giữa thông lượng lập chỉ mục, mức tiêu thụ RAM và recall truy vấn.
Khóa học tương tác miễn phí: Xây dựng tác nhân AI tự động
Kết nối cơ sở dữ liệu vector vào quy trình làm việc AI sản xuất trực tiếp? Khám phá khóa học miễn phí, đa mô-đun của chúng tôi: Xây dựng tác nhân AI với n8n: Kiến trúc, Bộ nhớ & Công cụ. Tìm hiểu điều phối DAG tác nhân con, đường ống truy xuất ngữ nghĩa và gọi công cụ tùy chỉnh với các quy trình làm việc thực hành.
Bạn cũng có thể thích
- Xây dựng RAG sản xuất với pgvector & Hybrid Search
- pgvector trong Sản xuất: Tìm kiếm Vector quy mô lớn & RRF lai trong PostgreSQL
- sqlite-vec vs pgvector: Tìm kiếm Vector Nhúng Cục bộ cho Ứng dụng Desktop & Edge
- Kiến trúc bộ nhớ tác nhân AI: Tích hợp Vector Store
Kiểm tra kiến thức
Một startup đang xây dựng hệ thống RAG đa người thuê (multi-tenant) cho các khách hàng doanh nghiệp, dự kiến sẽ mở rộng lên hàng trăm triệu vector trong vòng một năm. Họ ưu tiên độ trễ truy vấn dưới 50ms và hiệu quả chi phí, đặc biệt là về bộ nhớ. Chiến lược lập chỉ mục vector nào sẽ là điểm khởi đầu phù hợp nhất, xem xét các đánh đổi đã nêu?
Câu hỏi thường gặp
Hướng dẫn kỹ thuật liên quan
- Khóa học tương tác miễn phí: Xây dựng tác nhân AI với n8n
- Xây dựng RAG sản xuất với pgvector & Tìm kiếm kết hợp
- LangChain vs LlamaIndex: Hướng dẫn đường ống RAG sản xuất
- Kiến trúc bộ nhớ tác nhân AI: Tích hợp kho vector
- vLLM vs Ollama: Thông lượng LLM cục bộ & Tiêu chuẩn GPU
- Xây dựng tác nhân AI đáng tin cậy với MCP: Hướng dẫn đầy đủ
Công cụ lập trình trực tiếp trên trình duyệt
Làm sạch log AI CLI, tạo biểu thức cron, giải mã JWT và tính quyền chmod offline.
Bài viết liên quan
sqlite-vec vs pgvector: Tìm kiếm Vector Nhúng Cục bộ cho Ứng dụng Desktop & Edge
Hướng dẫn toàn diện so sánh sqlite-vec và pgvector: tìm kiếm vector nhúng cục bộ cho các ứng dụng desktop & edge với kiến trúc cấp độ sản xuất và ví dụ mã.
Đọc tiếp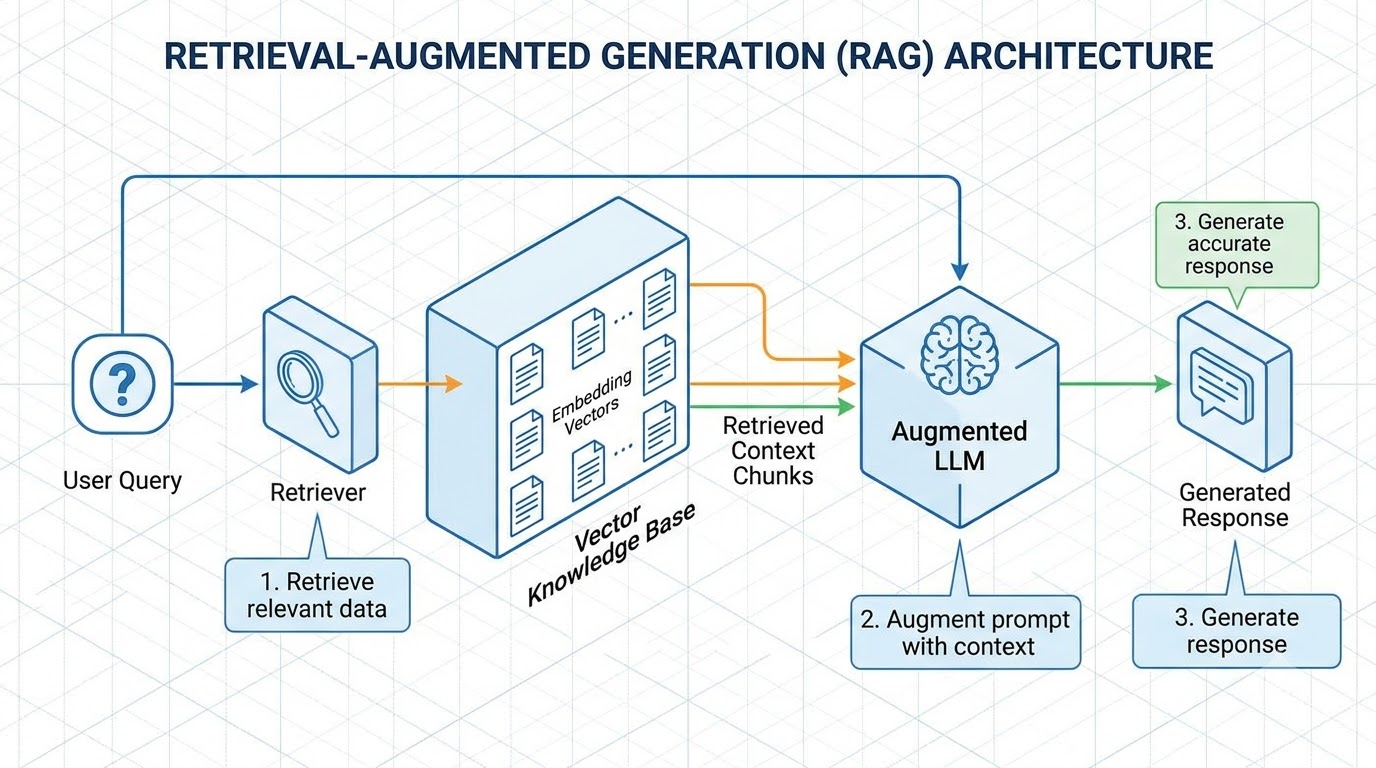
Tìm hiểu về Tạo sinh tăng cường truy xuất (RAG)
Tìm hiểu sâu về Tạo sinh tăng cường truy xuất (RAG): các chiến lược phân đoạn, nhúng vector, tìm kiếm lai dày đặc-thưa và các pipeline sắp xếp lại.
Đọc tiếp
RAG tác nhân có trạng thái: Máy trạng thái đồ thị, vòng lặp tự sửa lỗi & định tuyến dự phòng
Hướng dẫn toàn diện về RAG tác nhân có trạng thái: máy trạng thái đồ thị, vòng lặp tự sửa lỗi & định tuyến dự phòng với kiến trúc cấp độ sản xuất và ví dụ code.
Đọc tiếp