BigQuery + Cloud Run: Xây Dựng Pipeline Nhập Dữ Liệu Serverless Cho Production

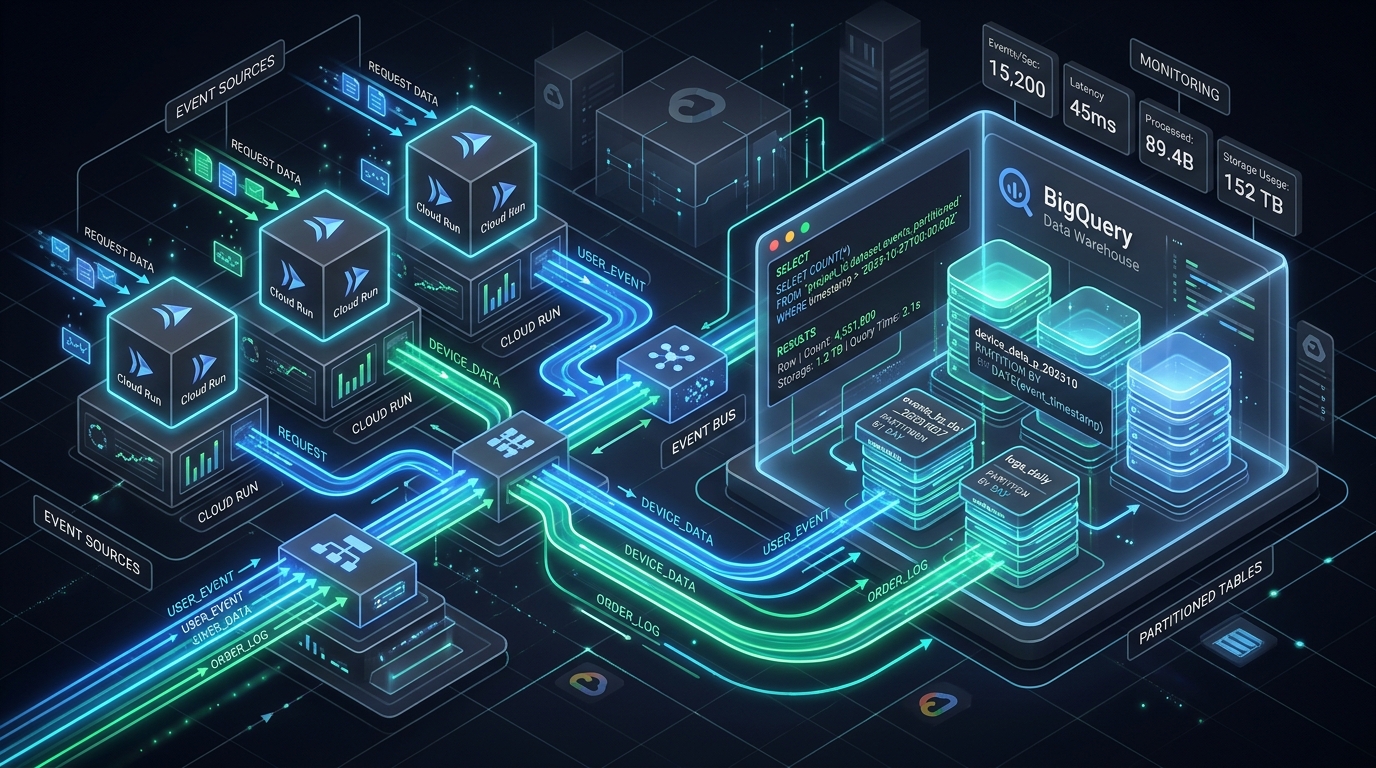
Là một kỹ sư nền tảng chính, tôi đã thấy vô số pipeline nhập dữ liệu, từ chỗ vá víu cho tới chỗ vững vàng. Xây dựng một hệ thống cấp production xử lý luồng dữ liệu khối lượng lớn, độ trễ thấp một cách đáng tin cậy và tiết kiệm chi phí là một thách thức không hề dễ dàng. Bài viết này trình bày chi tiết cách tiếp cận serverless sử dụng BigQuery và Cloud Run của Google Cloud, tận dụng BigQuery Storage Write API để đạt được một pipeline nhập dữ liệu có khả năng mở rộng, bền bỉ, và được tối ưu cho cả hiệu năng lẫn chi phí.
Cẩm nang này dành cho các kỹ sư backend và dữ liệu cao cấp cần hiểu những tinh tế của việc xây dựng hệ thống như vậy, từ các quyết định kiến trúc cho tới chi tiết triển khai, các hệ quả về chi phí, và việc gia cố vận hành.
1. Tổng Quan Kiến Trúc: Nhập Dữ Liệu Serverless
Pipeline nhập dữ liệu serverless của chúng tôi được thiết kế cho việc xử lý sự kiện thông lượng cao, độ trễ thấp, đưa dữ liệu một cách đáng tin cậy vào BigQuery để phân tích. Nguyên tắc cốt lõi là tận dụng các dịch vụ được quản lý để giảm thiểu chi phí vận hành và tối đa hóa khả năng mở rộng.
Đây là luồng từ đầu đến cuối:
- Nguồn Sự Kiện: Bất kỳ ứng dụng hay dịch vụ nào sinh ra dữ liệu (ví dụ: webhook, thiết bị IoT, microservice nội bộ).
- Publisher (Tùy chọn nhưng Nên dùng): Sự kiện được phát hành tới một topic Pub/Sub. Điều này mang lại sự tách rời, đệm lưu, và cơ chế retry tích hợp, nâng cao độ tin cậy và khả năng xử lý các đợt bùng nổ lưu lượng. Với luồng nhập dữ liệu trực tiếp qua HTTP, tầng này được bỏ qua.
- Cloud Run Receiver: Một dịch vụ HTTP không trạng thái (hiện thực bằng FastAPI) được triển khai trên Cloud Run. Nó nhận sự kiện (hoặc trực tiếp qua HTTP, hoặc kéo từ Pub/Sub qua một push subscription), kiểm tra chúng, rồi truyền chúng đi vào BigQuery.
- BigQuery Storage Write API: Dịch vụ Cloud Run sử dụng BigQuery Storage Write API để nhập dữ liệu vào BigQuery một cách hiệu quả, đáng tin cậy, và đúng một lần (exactly-once).
- Bảng BigQuery: Dữ liệu được ghi vào một bảng BigQuery, thường được phân vùng theo thời gian sự kiện và phân cụm theo các chiều liên quan, tối ưu hiệu năng truy vấn và giảm chi phí.
- Người Tiêu Thụ Downstream: Khi đã vào BigQuery, dữ liệu sẵn sàng cho phân tích, bảng điều khiển (Looker Studio, Power BI), các mô hình học máy, hoặc các biến đổi tiếp (dbt, Dataflow).
+----------------+       +-----------+       +---------------+       +---------------------+       +----------------+       +-------------------+
|                |       |           |       |               |       |                     |       |                |       |                   |
| Nguồn Sự Kiện  +------>|  Pub/Sub  +------>|   Cloud Run   +------>|  BigQuery Storage   +------>|    BigQuery    +------>|     Hạ Nguồn      |
|   (Ứng dụng,   |       |  Chủ Đề   |       |   (FastAPI    |       |   Ghi (Write API)   |       |  Bảng Dữ Liệu  |       |    Người Dùng     |
| IoT, Webhook)  |       |           |       |   Bộ Nhận)    |       |                     |       |  (Phân Vùng,   |       |  (Phân Tích, ML,  |
|                |       |           |       |               |       |                     |       |   Phân Cụm)    |       | Bảng Điều Khiển)  |
+----------------+       +-----------+       +---------------+       +---------------------+       +----------------+       +-------------------+
        ^                                            |                                                      ^
        |                                            |                                                      |
        |                                            +------------------------------------------------------+
        |                                                    (Xử Lý Lỗi, DLQ, Giám Sát)
        |
        +-----------------------------------------------------------------------------------------------------
                                                              (Nhập Dữ Liệu Trực Tiếp Qua HTTP - Bỏ Qua Pub/Sub)
Kiến trúc này hoàn toàn serverless, nghĩa là không có máy chủ nào để cấp phát, vá lỗi hay quản lý. Việc mở rộng là tự động, dựa theo nhu cầu.
2. BigQuery Storage Write API: Làm Dòng Chữa Đúng Cách
Với việc nhập dữ liệu khối lượng lớn, thời gian thực vào BigQuery, Storage Write API là lựa chọn triệt để. Nó thay thế các phương pháp cũ hơn như legacy JSON streaming insert (vẫn còn khả dụng nhưng thường không được khuyến nghị cho pipeline mới, hiệu năng cao) và batch loading qua Cloud Storage.
Vì Sao Storage Write API Thắng Dòng Chữa Cũ
API streaming insert dạng JSON cũ (tabledata.insertAll) có một số hạn chế:
- Chi phí: Nó đắt hơn theo từng dòng.
- Thông lượng: Giới hạn thông lượng thấp hơn.
- Độ tin cậy: Ngữ nghĩa best-effort, đòi hỏi khử trùng lặp ở phía client để có xử lý đúng một lần.
- Tiến hóa Schema: Kém linh hoạt hơn, đòi hỏi xử lý cẩn thận các thay đổi schema.
BigQuery Storage Write API giải quyết những hạn chế này:
- Hiệu quả chi phí: Nhìn chung hiệu quả hơn về chi phí, đặc biệt ở quy mô lớn.
- Thông lượng cao hơn: Được thiết kế cho tốc độ nhập dữ liệu khổng lồ.
- Ngữ nghĩa đúng một lần: Điểm mấu chốt, nó hỗ trợ giao hàng exactly-once bên trong một stream, loại bỏ nhu cầu khử trùng lặp ở phía client.
- Tiến hóa Schema: Xử lý cập nhật schema tốt hơn (ví dụ thêm cột nullable).
- An toàn kiểu: Dùng Avro hoặc Protobuf để tuần tự hóa dữ liệu, mang lại kiểm tra kiểu chặt chẽ hơn JSON thô. Mặc dù API hỗ trợ payload JSON, dùng Avro/Protobuf được khuyến nghị để có hiệu năng và xác thực schema tối ưu. Để đơn giản, bài này tập trung vào định dạng stream JSON vì dễ tích hợp với các dịch vụ HTTP thông thường.
- Phát lại theo offset: Cho phép phục hồi đáng tin cậy sau các lỗi tạm thời.
Định Dạng Stream JSON
Khi dùng Storage Write API với JSON, dữ liệu được gửi dưới dạng một danh sách đối tượng JSON bên trong trường json_rows của một AppendRowsRequest. Mỗi đối tượng đại diện cho một dòng. API tự động ánh xạ các trường JSON này tới các cột của bảng BigQuery dựa trên tên của chúng.
Ví dụ về payload AppendRowsRequest (đơn giản hóa để minh họa khái niệm):
{
  "writeStream": "projects/my-project/datasets/my_dataset/tables/my_table/streams/my_stream_id",
  "offset": {
    "value": "123"
  },
  "jsonRows": {
    "rows": [
      {"event_id": "abc-123", "event_timestamp": "2023-10-27T10:00:00Z", "payload": {"user_id": 123, "action": "click"}},
      {"event_id": "def-456", "event_timestamp": "2023-10-27T10:00:01Z", "payload": {"user_id": 456, "action": "view"}}
    ]
  }
}
Quy Tắc Đặt Tên Stream Append-Rows
Storage Write API dùng các stream để quản lý việc nhập dữ liệu. Có hai loại stream chính, phân biệt bởi quy ước đặt tên và các bảo đảm của chúng:
- Stream
_default: Đây là stream mặc định, không đệm. Nó mang lại ngữ nghĩa at-most-once. MỗiAppendRowsRequestghi dữ liệu vào BigQuery ngay lập tức. Nếu một request thất bại, dữ liệu bị mất trừ khi client retry. Không có cơ chế khử trùng lặp tích hợp. Nhìn chung không nên dùng cho dữ liệu sống còn. - Stream
_append_(ví dụ_append_stream_id): Đây là các stream có đệm mang lại ngữ nghĩa exactly-once. Khi bạn tạo một stream với ID tùy chỉnh bắt đầu bằng_append_, API sẽ đệm dữ liệu bên trong. Bạn phải gọi tường minhWriteStream.Finalize()vàWriteStream.Commit()để dữ liệu trở nên hiển thị được. Lợi thế chính là bạn có thể chỉ định mộtoffsettrongAppendRowsRequestcủa mình. Nếu một request thất bại, bạn có thể retry với cùng offset đó, và API sẽ bảo đảm dữ liệu được ghi đúng một lần. Đây là cách tiếp cận được khuyến nghị cho việc nhập dữ liệu đáng tin cậy.
Với bài này, chúng tôi tập trung vào stream _append_ nhờ độ tin cậy và bảo đảm exactly-once vượt trội của chúng.
Phát Lại Theo Offset Và Ngữ Nghĩa Đúng Một Lần
Trường offset trong AppendRowsRequest là nền tảng của cơ chế giao hàng đúng một lần. Khi bạn append các dòng vào một stream _append_, bạn cung cấp một offset kỳ vọng. Dịch vụ BigQuery phản hồi lại với offset thực tế của dòng đầu tiên đã được ghi trong AppendRowsResponse.
- Trách nhiệm của Client: Client phải duy trì
offsethiện tại cho từng stream. Khi gửi một lô dòng,offsetnên là số dòng đã ghi thành công trước lô hiện tại. - Cơ Chế Retry: Nếu một
AppendRowsRequestthất bại (ví dụ lỗi mạng, lỗi BigQuery tạm thời), client có thể retry an toàn toàn bộ lô với cùng offset đó. Storage Write API sẽ phát hiện nếu dữ liệu cho offset đó đã được ghi và chỉ đơn giản xác nhận, ngăn chặn trùng lặp. - Hoàn Tất & Commit Stream: Với stream
_append_, dữ liệu chỉ hiển thị cho truy vấn sau khi stream được hoàn tất và commit. Điều này cho phép bạn gom nhiều lời gọiAppendRowsRequestthành một giao dịch nguyên tử duy nhất.
Thư Viện Client
Google Cloud cung cấp các thư viện client theo phong cách riêng cho Storage Write API bằng nhiều ngôn ngữ:
- Go:
cloud.google.com/go/bigquery/storage/apiv1 - Java:
com.google.cloud:google-cloud-bigquery-storage - Python:
google-cloud-bigquery-storage - Node.js:
@google-cloud/bigquery-storage
Những thư viện này che giấu phần lớn độ phức tạp của gRPC, cung cấp các API cấp cao hơn để quản lý stream và append dữ liệu.
Ví Dụ Code Thực Tế (Python)
Ví dụ Python này trình bày cách dùng BigQuery Storage Write API để tạo một stream _append_ và append các dòng.
import json
import time
from google.cloud import bigquery_storage_v1
from google.cloud.bigquery_storage_v1 import types
from google.cloud.bigquery_storage_v1 import writer

def append_rows_to_bq_stream(
    project_id: str,
    dataset_id: str,
    table_id: str,
    rows: list[dict] # List of dictionaries, each representing a row
):
    """Appends rows to a BigQuery table using the Storage Write API."""

    client = bigquery_storage_v1.BigQueryWriteClient()
    table_path = client.table_path(project_id, dataset_id, table_id)

    # Create a write stream.
    # Use the 'PENDING' type for exactly-once semantics and explicit commit.
    write_stream = types.WriteStream(type_=types.WriteStream.Type.PENDING)
    write_stream = client.create_write_stream(
        parent=table_path, write_stream=write_stream
    )
    stream_name = write_stream.name
    print(f"Created write stream: {stream_name}")

    # Create a JSON stream writer.
    # This writer manages the connection and sends batches.
    # The `offset` is managed internally by the writer for exactly-once delivery.
    json_stream_writer = writer.JsonStreamWriter(
        client,
        stream_name,
        # The schema of the table. The Storage Write API uses this to validate
        # and correctly parse JSON rows.
        # It's crucial to provide the correct schema.
        table_schema={
            "fields": [
                {"name": "event_id", "type": "STRING", "mode": "REQUIRED"},
                {"name": "event_timestamp", "type": "TIMESTAMP", "mode": "REQUIRED"},
                {"name": "user_id", "type": "INTEGER", "mode": "NULLABLE"},
                {"name": "action", "type": "STRING", "mode": "NULLABLE"},
                {"name": "payload", "type": "JSON", "mode": "NULLABLE"}
            ]
        }
    )

    # Append rows. The writer handles batching and sending.
    # It also manages the offset for exactly-once semantics.
    try:
        # The `append_rows` method returns a future.
        # We wait for it to complete to ensure the write is acknowledged.
        # In a real application, you might manage these futures asynchronously.
        append_future = json_stream_writer.append_rows(rows)
        response = append_future.result() # Blocks until response is received

        if response.row_errors:
            print(f"Row errors encountered: {response.row_errors}")
        else:
            print(f"Successfully appended {len(rows)} rows to stream {stream_name} at offset {response.append_result.offset.value}")

    except Exception as e:
        print(f"Error appending rows: {e}")
        # In a real system, you'd handle this more robustly,
        # potentially retrying or sending to a DLQ.
        client.batch_finalize_write_stream(names=[stream_name]) # Finalize to release resources
        raise

    finally:
        # Finalize the stream. This makes the buffered data visible.
        # For PENDING streams, data is only visible after commit.
        # For COMMITTED streams (not used here), data is visible immediately.
        client.finalize_write_stream(name=stream_name)
        print(f"Finalized write stream: {stream_name}")

        # Commit the stream. This is required for PENDING streams
        # to make the data permanent.
        batch_commit_write_streams_request = types.BatchCommitWriteStreamsRequest()
        batch_commit_write_streams_request.parent = table_path
        batch_commit_write_streams_request.write_streams.append(stream_name)
        client.batch_commit_write_streams(batch_commit_write_streams_request)
        print(f"Committed write stream: {stream_name}")

# Example usage:
if __name__ == "__main__":
    PROJECT_ID = "your-gcp-project-id"
    DATASET_ID = "your_dataset"
    TABLE_ID = "your_table"

    sample_rows = [
        {"event_id": "uuid-1", "event_timestamp": "2023-10-27T10:00:00.123456Z", "user_id": 1, "action": "login", "payload": {"ip": "1.1.1.1"}},
        {"event_id": "uuid-2", "event_timestamp": "2023-10-27T10:00:01.678901Z", "user_id": 2, "action": "logout", "payload": {"duration_s": 600}},
    ]

    # Ensure the table and dataset exist before running this.
    # The table schema should match the fields provided to JsonStreamWriter.
    append_rows_to_bq_stream(PROJECT_ID, DATASET_ID, TABLE_ID, sample_rows)
Những Điểm Chính Từ Code:
WriteStream.Type.PENDING: Điều này là then chốt cho ngữ nghĩa exactly-once. Dữ liệu được đệm và chỉ hiển thị sau khi gọi tường minhfinalize_write_streamvàbatch_commit_write_streams.JsonStreamWriter: Lớp trợ giúp này đơn giản hóa việc quản lý stream, gom lô các dòng, và xử lý offset.- Định Nghĩa Schema: Cung cấp
table_schemachoJsonStreamWriterlà điều thiết yếu để phân tích và xác thực các dòng JSON chính xác. - Xử Lý Lỗi: Khối
try...except...finallytrình bày cách xử lý các lỗi tiềm ẩn trong khi append và bảo đảm các stream được hoàn tất/commit. Trong production, bạn sẽ triển khai logic retry tinh vi hơn và có thể thêm một Dead Letter Queue (DLQ) cho các lỗi không thể phục hồi.
3. Phân Vùng Và Phân Cụm: Tối Ưu BigQuery
Sức mạnh của BigQuery nằm ở khả năng quét nhanh các tập dữ liệu khổng lồ. Phân vùng và phân cụm là những kỹ thuật nền tảng để tối ưu hiệu năng truy vấn và giảm chi phí bằng cách giảm thiểu lượng dữ liệu phải quét.
Phân Vùng: Cắt Nhỏ Dữ Liệu
Phân vùng chia một bảng thành các đoạn nhỏ hơn, dễ quản lý hơn, dựa trên giá trị của một cột cụ thể hoặc thời điểm nhập dữ liệu. Các truy vấn lọc trên cột phân vùng sẽ chỉ quét các partition liên quan, giảm đáng kể lượng dữ liệu được xử lý.
-
Phân Vùng Theo Thời Điểm Nhập:
- Cơ chế: BigQuery tự động phân vùng dữ liệu dựa trên thời điểm nó được nhập vào bảng.
- Cột giả: Dùng các cột giả
_PARTITIONTIME(TIMESTAMP) hoặc_PARTITIONDATE(DATE). - Trường Hợp Dùng: Lý tưởng khi không có thời gian sự kiện hoặc không đáng tin cậy, hoặc khi bạn chủ yếu truy vấn dữ liệu dựa trên thời điểm nó đến BigQuery.
- Ví dụ:
PARTITION BY _PARTITIONDATE
-
Phân Vùng Theo Thời Điểm Sự Kiện (Dựa Trên Cột):
- Cơ chế: Phân vùng dữ liệu dựa trên một cột
TIMESTAMPhoặcDATEtrong schema bảng của bạn. Đây là cách phổ biến nhất và được khuyến nghị cho dữ liệu sự kiện. - Trường Hợp Dùng: Khi bạn có một dấu thời gian sự kiện đáng tin cậy (ví dụ
event_timestamp,created_at) phản ánh chính xác thời điểm sự kiện xảy ra. Điều này cho phép các truy vấn khớp với các khung thời gian nghiệp vụ. - Ví dụ:
PARTITION BY event_timestamp
- Cơ chế: Phân vùng dữ liệu dựa trên một cột
Phân Cụm: Sắp Xếp Dữ Liệu Bên Trong Partition
Phân cụm sắp xếp dữ liệu bên trong mỗi partition dựa trên giá trị của một hoặc nhiều cột được chỉ định. Khi các truy vấn lọc hoặc tổng hợp trên những cột được phân cụm này, BigQuery có thể loại bỏ hiệu quả các khối dữ liệu không khớp với bộ lọc, giảm thêm số byte được quét.
- Cơ chế: Bạn chỉ định tối đa bốn cột phân cụm. BigQuery sẽ đặt vật lý các dòng có giá trị tương tự trong những cột này ở cạnh nhau.
- Vì Sao Phân Cụm Thắng Phân Vùng Với Một Số Dạng Bộ Lọc: Phân vùng hiệu quả với các bộ lọc theo khoảng thời gian rộng. Tuy nhiên, nếu bạn cần lọc trên một cột có độ phân giải cao bên trong một khoảng thời gian cụ thể (ví dụ
user_idhoặcdevice_id), phân cụm tỏa sáng. Một truy vấn nhưSELECT * FROM my_table WHERE _PARTITIONDATE = '2023-10-27' AND user_id = 123sẽ hưởng lợi rất lớn từ cả phân vùng trên_PARTITIONDATElẫn phân cụm trênuser_id. - Phân Cụm Theo Khoảng Số Nguyên: BigQuery hỗ trợ phân cụm trên các cột
INTEGER. Ví dụ, nếu bạn cóuser_iddạngINTEGER, phân cụm theo cột đó sẽ gom các người dùng lại với nhau.
Hết Hạn Partition
Hết hạn partition tự động xóa các partition cũ sau một khoảng thời gian đã chỉ định. Điều này là then chốt để quản lý vòng đời dữ liệu, tuân thủ chính sách lưu giữ, và kiểm soát chi phí lưu trữ.
- Cơ chế: Bạn đặt thuộc tính
partition_expiration_days(hoặcpartition_expiration_microseconds) khi tạo hoặc cập nhật một bảng. - Lợi ích: Giảm chi phí lưu trữ dài hạn và đơn giản hóa việc quản lý lưu giữ dữ liệu.
Đánh Đổi Chi Phí/Độ Trễ
- Chi phí giảm: Cả phân vùng và phân cụm đều giảm lượng dữ liệu BigQuery phải quét cho nhiều truy vấn, chuyển thẳng thành chi phí truy vấn thấp hơn (BigQuery tính phí theo dữ liệu được quét).
- Độ trễ cải thiện: Ít dữ liệu phải quét nghĩa là thời gian thực thi truy vấn nhanh hơn.
- Chi phí ghi: Có một chi phí nhỏ khi BigQuery duy trì các partition và cụm, nhưng điều này không đáng kể so với lợi ích về chi phí và hiệu năng truy vấn.
- Partition quá nhỏ: Tránh tạo quá nhiều partition rất nhỏ, vì điều này đôi khi dẫn tới chi phí metadata. BigQuery xử lý việc này khá tốt, nhưng vẫn là điều đáng cân nhắc.
Ví Dụ DDL
Dưới đây là câu lệnh CREATE TABLE trình bày phân vùng theo thời điểm sự kiện và phân cụm:
CREATE TABLE `your-gcp-project-id.your_dataset.your_table`
(
    event_id STRING NOT NULL OPTIONS(description="Unique identifier for the event"),
    event_timestamp TIMESTAMP NOT NULL OPTIONS(description="Timestamp when the event occurred"),
    user_id INTEGER OPTIONS(description="Identifier for the user"),
    session_id STRING OPTIONS(description="Identifier for the user session"),
    action STRING OPTIONS(description="Type of action performed"),
    payload JSON OPTIONS(description="JSON payload containing additional event details")
)
PARTITION BY DATE(event_timestamp) -- Partition by the date component of event_timestamp
CLUSTER BY user_id, session_id      -- Cluster within each partition by user_id and session_id
OPTIONS(
    description="Table for storing application events, partitioned by event date and clustered by user/session.",
    partition_expiration_days=90, -- Partitions older than 90 days will be automatically deleted
    require_partition_filter=true -- Enforce partition filtering in queries to prevent full table scans
);
Giải thích:
PARTITION BY DATE(event_timestamp): Dùng cộtevent_timestampđể phân vùng bảng theo ngày.CLUSTER BY user_id, session_id: Bên trong mỗi partition ngày, dữ liệu sẽ được sắp xếp và nhóm theouser_idrồi tớisession_id.partition_expiration_days=90: Bất kỳ partition nào cũ hơn 90 ngày kể từ thời điểm tạo sẽ tự động bị gỡ bỏ.require_partition_filter=true: Đây là một tùy chọn then chốt cho việc kiểm soát chi phí. Nó buộc người dùng phải đưa bộ lọc vào_PARTITIONTIME(hoặcevent_timestamptrong trường hợp này) trong truy vấn, ngăn chặn việc quét toàn bộ bảng do vô tình.
4. Bộ Nhận FastAPI Bất Đồng Bộ: Cổng Vào Cho Dữ Liệu
Bộ nhận Cloud Run đóng vai trò là endpoint HTTP cho pipeline nhập dữ liệu của chúng tôi. FastAPI, với khả năng bất đồng bộ và Pydantic để kiểm tra dữ liệu, là một lựa chọn xuất sắc để xây dựng dịch vụ này.
FastAPI Kết Hợp Async Context Manager
FastAPI hỗ trợ tự nhiên async/await, điều quan trọng đối với các thao tác bị giới hạn bởi I/O như ghi vào BigQuery. Tuy nhiên, thư viện client Python google-cloud-bigquery-storage chủ yếu là đồng bộ. Để dùng nó một cách hiệu quả trong ứng dụng FastAPI bất đồng bộ, chúng ta cần chuyển các lời gọi BigQuery đồng bộ sang một thread pool hoặc dùng asyncio.to_thread. Quan trọng hơn, việc quản lý BigQueryWriteClient và các stream gRPC bên dưới đòi hỏi xử lý cẩn thận, đặc biệt là với connection pooling và tắt êm ái (graceful shutdown).
Async context manager (async with) là lý tưởng cho việc này. Chúng cho phép chúng ta quản lý vòng đời của các stream ghi BigQuery, bảo đảm chúng được khởi tạo và đóng một cách đúng đắn.
Connection Pooling
Việc tạo một BigQueryWriteClient mới và một write stream mới cho mỗi request đến là không hiệu quả. Nó tốn chi phí thiết lập kết nối và không tận dụng được các kết nối đã có. Cách tiếp cận tốt hơn là:
- Tái sử dụng
BigQueryWriteClient: Bản thânBigQueryWriteClientcó thể là một singleton, hoặc được tạo một lần cho mỗi tiến trình. - Gom Nhóm Write Stream: Với các stream
_append_, bạn có thể tạo một nhóm các stream dài hạn. Mỗi stream có thể xử lý nhiều lời gọiAppendRowsRequest. Khi một request đến, nó chọn một stream khả dụng từ nhóm, append các dòng, rồi trả stream về nhóm. Điều này giảm thiểu chi phí tạo/hoàn tất stream. Để đơn giản trong ví dụ, chúng ta tạo một stream cho mỗi lô, nhưng cách tiếp cận tiên tiến hơn sẽ dùng nhóm.
Backpressure
Xử lý backpressure là điều tối quan trọng khi tốc độ nhập dữ liệu vượt quá năng lực xử lý của bạn hoặc vượt quá giới hạn ghi của BigQuery.
- Hàng đợi nội bộ: FastAPI có thể dùng hàng đợi nội bộ (ví dụ
asyncio.Queue) để đệm các request đến trước khi xử lý. Nếu hàng đợi đầy, các request mới có thể bị từ chối với503 Service Unavailable. - Cloud Run tự động co giãn: Cloud Run tự động co giãn số instance, điều này có ích. Tuy nhiên, nếu một instance đơn lẻ bị quá tải, hàng đợi nội bộ sẽ đóng vai trò làm vùng đệm.
- Hạn ngạch BigQuery: BigQuery có hạn ngạch cho thao tác chèn theo luồng. Nếu chạm phải, client của Storage Write API thường sẽ tự thử lại, nhưng việc vượt hạn ngạch kéo dài đòi hỏi can thiệp (ví dụ: tăng hạn ngạch hoặc giới hạn tốc độ ở phía trên).
Tắt Êm Ái Các Stream Đang Xử Lý
Khi một instance Cloud Run bị chấm dứt (ví dụ: thu nhỏ quy mô, triển khai phiên bản mới), nó nhận được tín hiệu SIGTERM. Ứng dụng cần xử lý tín hiệu này một cách êm ái:
- Ngừng nhận request mới.
- Xử lý các request đang dở: Cho phép các lời gọi
AppendRowsRequesthiện tại hoàn tất. - Hoàn tất và commit mọi stream
_append_đang mở: Điều này bảo đảm toàn bộ dữ liệu trong bộ đệm được đẩy sang BigQuery. Nếu không làm vậy, dữ liệu trong các stream đang chờ có thể bị mất hoặc bị trì hoãn.
Sự kiện lifespan của FastAPI là nơi lý tưởng để làm việc này.
Tinh Chỉnh Concurrency Của Cloud Run
Cloud Run cung cấp một số tham số để tối ưu hiệu năng và chi phí:
concurrency: Số request đồng thời tối đa mà một instance có thể xử lý. Concurrency cao hơn (ví dụ 80-250) nhìn chung là tốt cho các dịch vụ bị giới hạn bởi I/O như bộ nhận của chúng ta, miễn là ứng dụng thực sất bất đồng bộ và không bị chặn.request timeouts: Đặt mức này đủ cao để chịu được độ trễ ghi BigQuery, đặc biệt với các lô lớn, nhưng không cao đến mức các request thất bại cứ quẩn quanh. 60-120 giây là một điểm khởi đầu hợp lý.min-instances/max-instances:min-instancesgiữ một số instance nền ở trạng thái ấm, giảm độ trễ khởi động lạnh.max-instancesgiới hạn chi tiêu và mức sử dụng tài nguyên của bạn.- Phản hồi dạng luồng so với dạng đệm: Với bộ nhận dữ liệu, chúng ta chủ yếu nhận dữ liệu chứ không truyền phát phản hồi ngược lại. Trọng tâm là xử lý hiệu quả phần thân request đến.
Khóa Idempotency
Việc client thử lại là chuyện thường lệ. Nếu không có idempotency, một request được thử lại có thể dẫn tới dữ liệu trùng lặp trong BigQuery.
- Cơ chế: Client gửi một header
Idempotency-Keyduy nhất kèm theo mỗi request. - Logic phía bộ nhận:
- Khi nhận được request, kiểm tra xem
Idempotency-Keyđã từng xuất hiện gần đây chưa (ví dụ: trong một cache Redis hoặc cache nhỏ trong bộ nhớ). - Nếu đã thấy và vẫn đang "xử lý", trả về
202 Acceptedhoặc409 Conflict(tùy theo hành vi mong muốn) mà không xử lý lại. - Nếu đã thấy và "đã xử lý thành công", trả về
200 OKmà không xử lý lại. - Nếu chưa thấy, xử lý request, lưu
Idempotency-Keykèm trạng thái của nó, rồi trả kết quả.
- Khi nhận được request, kiểm tra xem
- BigQuery Storage Write API và Idempotency: Cơ chế phát lại theo offset của Storage Write API mang lại tính idempotent bên trong một stream duy nhất. Tuy nhiên, khóa idempotency ở tầng ứng dụng bảo vệ chúng ta khỏi dữ liệu trùng lặp nếu toàn bộ request gửi tới Cloud Run bị thử lại trước khi lệnh ghi BigQuery kịp bắt đầu, hoặc nếu một stream mới được tạo. Đây là một lớp bảo vệ bổ sung.
Ví Dụ Thực Tế (FastAPI)
Ví dụ dưới đây trình bày một bộ nhận FastAPI với BigQuery client dạng singleton, xử lý các sự kiện JSON đến, và ghi chúng bằng Storage Write API.
import os
import asyncio
import logging
from contextlib import asynccontextmanager
from typing import List, Dict, Any, Optional

from fastapi import FastAPI, Request, HTTPException, status
from pydantic import BaseModel, Field
from google.cloud import bigquery_storage_v1
from google.cloud.bigquery_storage_v1 import types
from google.cloud.bigquery_storage_v1 import writer
from concurrent.futures import ThreadPoolExecutor

# --- Configuration ---
PROJECT_ID = os.environ.get("GCP_PROJECT_ID")
DATASET_ID = os.environ.get("BQ_DATASET_ID")
TABLE_ID = os.environ.get("BQ_TABLE_ID")
BIGQUERY_TABLE_SCHEMA = {
    "fields": [
        {"name": "event_id", "type": "STRING", "mode": "REQUIRED"},
        {"name": "event_timestamp", "type": "TIMESTAMP", "mode": "REQUIRED"},
        {"name": "user_id", "type": "INTEGER", "mode": "NULLABLE"},
        {"name": "action", "type": "STRING", "mode": "NULLABLE"},
        {"name": "payload", "type": "JSON", "mode": "NULLABLE"}
    ]
}
MAX_BIGQUERY_STREAM_IDLE_SECONDS = 300 # Close streams if idle for too long
MAX_BIGQUERY_STREAM_BATCH_SIZE = 1000 # Max rows per append call
MAX_BIGQUERY_STREAM_BATCH_BYTES = 10 * 1024 * 1024 # 10MB per append call
MAX_WORKER_THREADS = 5 # For offloading synchronous BigQuery calls

# --- Logging ---
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)

# --- Global BigQuery Client and Thread Pool ---
# We use a global client and thread pool to reuse resources efficiently.
bq_storage_client: Optional[bigquery_storage_v1.BigQueryWriteClient] = None
bq_executor: Optional[ThreadPoolExecutor] = None

# --- Pydantic Models for Request Validation ---
class EventPayload(BaseModel):
    ip: Optional[str] = None
    duration_s: Optional[int] = None
    # Add other dynamic fields as needed. Use Any for truly flexible JSON.
    # For strict validation, define all expected fields.

class Event(BaseModel):
    event_id: str = Field(..., description="Unique identifier for the event")
    event_timestamp: str = Field(..., description="ISO 8601 timestamp of the event")
    user_id: Optional[int] = Field(None, description="User ID associated with the event")
    action: Optional[str] = Field(None, description="Action performed by the user")
    payload: Optional[EventPayload] = Field(None, description="Additional event details")

# --- FastAPI Lifespan Management ---
@asynccontextmanager
async def lifespan(app: FastAPI):
    global bq_storage_client, bq_executor
    logger.info("Starting up Cloud Run receiver...")

    if not all([PROJECT_ID, DATASET_ID, TABLE_ID]):
        logger.error("Missing required environment variables for BigQuery connection.")
        raise RuntimeError("BigQuery environment variables not set.")

    bq_storage_client = bigquery_storage_v1.BigQueryWriteClient()
    bq_executor = ThreadPoolExecutor(max_workers=MAX_WORKER_THREADS)
    logger.info("BigQueryWriteClient and ThreadPoolExecutor initialized.")

    yield # Application runs

    logger.info("Shutting down Cloud Run receiver...")
    if bq_storage_client:
        # In a real scenario, you'd manage open write streams here.
        # For this simple example, we assume streams are short-lived per request.
        # If using long-lived pooled streams, you'd finalize/commit them here.
        bq_storage_client.transport.close() # Close gRPC connections
        logger.info("BigQueryWriteClient closed.")
    if bq_executor:
        bq_executor.shutdown(wait=True)
        logger.info("ThreadPoolExecutor shut down.")
    logger.info("Cloud Run receiver shut down complete.")

app = FastAPI(
    title="BigQuery Serverless Ingestion Receiver",
    description="Receives events and streams them to BigQuery via Storage Write API.",
    version="1.0.0",
    lifespan=lifespan
)

# --- Idempotency Cache (In-memory for simplicity, use Redis for production) ---
# This is a very basic in-memory cache. For production, use a distributed cache like Redis.
# Stores {idempotency_key: (status, timestamp)}
IDEMPOTENCY_CACHE: Dict[str, tuple[str, float]] = {}
IDEMPOTENCY_CACHE_EXPIRATION_SECONDS = 3600 # 1 hour

def check_idempotency(idempotency_key: str) -> Optional[str]:
    """Checks idempotency cache. Returns 'processed' if seen, None otherwise."""
    if idempotency_key in IDEMPOTENCY_CACHE:
        status, timestamp = IDEMPOTENCY_CACHE[idempotency_key]
        if time.time() - timestamp < IDEMPOTENCY_CACHE_EXPIRATION_SECONDS:
            logger.info(f"Idempotent request detected for key: {idempotency_key}. Status: {status}")
            return status
        else:
            # Expired entry, remove it
            del IDEMPOTENCY_CACHE[idempotency_key]
    return None

def set_idempotency_status(idempotency_key: str, status: str):
    """Sets idempotency status."""
    IDEMPOTENCY_CACHE[idempotency_key] = (status, time.time())

# --- BigQuery Write Function (Synchronous, to be run in thread pool) ---
def _write_to_bigquery_sync(
    client: bigquery_storage_v1.BigQueryWriteClient,
    table_path: str,
    rows_to_insert: List[Dict[str, Any]]
):
    """Synchronously writes rows to BigQuery using Storage Write API."""
    write_stream = client.create_write_stream(
        parent=table_path, write_stream=types.WriteStream(type_=types.WriteStream.Type.PENDING)
    )
    stream_name = write_stream.name
    logger.info(f"Created write stream: {stream_name}")

    json_stream_writer = writer.JsonStreamWriter(
        client,
        stream_name,
        table_schema=BIGQUERY_TABLE_SCHEMA
    )

    try:
        append_future = json_stream_writer.append_rows(rows_to_insert)
        response = append_future.result() # Blocks until response

        if response.row_errors:
            logger.error(f"Row errors for stream {stream_name}: {response.row_errors}")
            raise RuntimeError(f"BigQuery row errors: {response.row_errors}")
        else:
            logger.info(f"Successfully appended {len(rows_to_insert)} rows to stream {stream_name} at offset {response.append_result.offset.value}")

    except Exception as e:
        logger.error(f"Failed to append rows to BigQuery stream {stream_name}: {e}")
        # Finalize to release resources even on error
        client.finalize_write_stream(name=stream_name)
        raise
    finally:
        # Finalize and commit the stream to make data visible
        client.finalize_write_stream(name=stream_name)
        commit_request = types.BatchCommitWriteStreamsRequest(
            parent=table_path,
            write_streams=[stream_name]
        )
        client.batch_commit_write_streams(commit_request)
        logger.info(f"Committed write stream: {stream_name}")


# --- FastAPI Endpoint ---
@app.post("/ingest")
async def ingest_events(request: Request, events: List[Event]):
    """
    Receives a batch of events and streams them to BigQuery.
    """
    idempotency_key = request.headers.get("Idempotency-Key")

    if idempotency_key:
        status_in_cache = check_idempotency(idempotency_key)
        if status_in_cache == "processed":
            return {"message": "Request already processed", "status": "idempotent_success"}
        elif status_in_cache == "processing":
            raise HTTPException(
                status_code=status.HTTP_409_CONFLICT,
                detail="Request with this Idempotency-Key is already being processed."
            )
        set_idempotency_status(idempotency_key, "processing")

    if not bq_storage_client or not bq_executor:
        logger.error("BigQuery client or executor not initialized.")
        raise HTTPException(
            status_code=status.HTTP_500_INTERNAL_SERVER_ERROR,
            detail="Service not ready."
        )

    table_path = bq_storage_client.table_path(PROJECT_ID, DATASET_ID, TABLE_ID)
    rows_to_insert = [event.model_dump(mode='json') for event in events]

    try:
        # Offload synchronous BigQuery write to a separate thread
        await asyncio.to_thread(
            _write_to_bigquery_sync,
            bq_storage_client,
            table_path,
            rows_to_insert
        )
        if idempotency_key:
            set_idempotency_status(idempotency_key, "processed")
        return {"message": f"Successfully ingested {len(events)} events."}
    except Exception as e:
        logger.error(f"Failed to ingest events: {e}", exc_info=True)
        if idempotency_key:
            set_idempotency_status(idempotency_key, "failed")
        raise HTTPException(
            status_code=status.HTTP_500_INTERNAL_SERVER_ERROR,
            detail=f"Failed to write to BigQuery: {e}"
        )

# Example of a health check endpoint
@app.get("/health")
async def health_check():
    return {"status": "ok"}
Bây giờ, hãy đóng gói ứng dụng này thành một container image.
Dockerfile
# Use an official Python runtime as a parent image
FROM python:3.10-slim-buster

# Set the working directory in the container
WORKDIR /app

# Install dependencies
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

# Copy the application code
COPY . .

# Expose the port the app runs on
ENV PORT 8080

# Run the application with Uvicorn
CMD exec uvicorn main:app --host 0.0.0.0 --port $PORT --workers 1
Tệp Phụ Thuộc
fastapi
uvicorn[standard]
google-cloud-bigquery-storage
pydantic
Triển Khai Lên Cloud Run
Sau khi build và push image lên Container Registry, chúng ta có thể triển khai dịch vụ:
gcloud run deploy bigquery-ingester \
  --image gcr.io/your-project-id/bigquery-ingester:latest \
  --platform managed \
  --region us-central1 \
  --allow-unauthenticated \
  --cpu 1 \
  --memory 2Gi \
  --concurrency 80 \
  --timeout 120s \
  --min-instances 1 \
  --max-instances 10 \
  --set-env-vars GCP_PROJECT_ID=your-project-id,BQ_DATASET_ID=your_dataset,BQ_TABLE_ID=your_table \
  --service-account bigquery-ingester-sa@your-project-id.iam.gserviceaccount.com
Các Tham Số Tinh Chỉnh Quan Trọng Của Cloud Run:
--concurrency 80: Một điểm khởi đầu tốt cho các ứng dụng Python bất đồng bộ bị giới hạn bởi I/O. Hãy điều chỉnh dựa trên kết quả profiling.--timeout 120s: Cho phép các thao tác ghi BigQuery kéo dài hơn, đặc biệt với các lô lớn.--min-instances 1: Giữ một instance ở trạng thái ấm để giảm độ trễ khởi động lạnh cho việc nhập dữ liệu quan trọng.--max-instances 10: Đặt trần trên mức co giãn để kiểm soát chi phí.
5. Terraform Cho Toàn Bộ Stack
Terraform cung cấp Infrastructure as Code (IaC) để quản lý toàn bộ pipeline của chúng ta. Điều này bảo đảm khả năng tái lập, kiểm soát phiên bản, và triển khai nhất quán.
Chúng ta sẽ định nghĩa:
- Các Google Cloud API bắt buộc.
- Một service account chuyên dụng với các vai trò IAM theo nguyên tắc đặc quyền tối thiểu.
- Pub/Sub topic cho sự kiện và một Dead Letter Topic (DLT).
- Pub/Sub subscription (nếu sự kiện đến từ Pub/Sub).
- BigQuery dataset và bảng đã phân vùng/phân cụm.
- Dịch vụ Cloud Run cho bộ nhận FastAPI.
- Một Cloud Run Job (v2 worker) tối giản cho các tác vụ bảo trì (ví dụ: di chuyển schema, nạp lại dữ liệu lịch sử).
# main.tf

# -----------------------------------------------------------------------------
# Provider and Configuration
# -----------------------------------------------------------------------------
terraform {
  required_providers {
    google = {
      source  = "hashicorp/google"
      version = "~> 5.0"
    }
  }
  required_version = ">= 1.0"
}

# Variables for project and region
variable "project_id" {
  description = "The GCP project ID."
  type        = string
}

variable "region" {
  description = "The GCP region for resources."
  type        = string
  default     = "us-central1"
}

variable "dataset_id" {
  description = "BigQuery Dataset ID for ingestion."
  type        = string
  default     = "event_data"
}

variable "table_id" {
  description = "BigQuery Table ID for ingested events."
  type        = string
  default     = "app_events"
}

variable "cloud_run_service_name" {
  description = "Name of the Cloud Run service."
  type        = string
  default     = "bigquery-ingester"
}

variable "cloud_run_job_name" {
  description = "Name of the Cloud Run Job (v2 worker)."
  type        = string
  default     = "bq-maintenance-job"
}

variable "image_tag" {
  description = "Docker image tag for the Cloud Run service/job."
  type        = string
  default     = "latest" # In production, use specific version tags like v1.0.0
}

# -----------------------------------------------------------------------------
# Enable Required APIs
# -----------------------------------------------------------------------------
resource "google_project_service" "apis" {
  for_each = toset([
    "run.googleapis.com",
    "pubsub.googleapis.com",
    "bigquery.googleapis.com",
    "bigqueryconnection.googleapis.com", # Required for Storage Write API
    "bigquerystorage.googleapis.com",    # Required for Storage Write API
    "artifactregistry.googleapis.com",   # For Docker image storage
    "cloudbuild.googleapis.com",         # If using Cloud Build for CI/CD
    "iam.googleapis.com"                 # For managing service accounts
  ])
  project = var.project_id
  service = each.key
  disable_on_destroy = false
}

# -----------------------------------------------------------------------------
# Service Account and IAM
# -----------------------------------------------------------------------------
resource "google_service_account" "ingester_sa" {
  project      = var.project_id
  account_id   = "bigquery-ingester-sa"
  display_name = "Service Account for BigQuery Ingestion Cloud Run Service"
}

# Grant BigQuery Data Editor role for writing to the table
resource "google_project_iam_member" "bq_data_editor" {
  project = var.project_id
  role    = "roles/bigquery.dataEditor" # Allows writing data to tables
  member  = "serviceAccount:${google_service_account.ingester_sa.email}"
}

# Grant Pub/Sub Publisher role if Cloud Run pushes to Pub/Sub (e.g., for DLQ)
# Or if Cloud Run pulls from Pub/Sub via subscription
resource "google_project_iam_member" "pubsub_publisher" {
  project = var.project_id
  role    = "roles/pubsub.publisher"
  member  = "serviceAccount:${google_service_account.ingester_sa.email}"
  # Comment out if Cloud Run only receives HTTP and doesn't publish to Pub/Sub
}

# Allow Cloud Run to invoke the service (for unauthenticated access, this is 'allUsers')
# If you want authenticated access, use `google_cloud_run_service_iam_member`
# and specify which service accounts or users can invoke it.
resource "google_cloud_run_service_iam_member" "allow_unauthenticated" {
  project  = var.project_id
  location = var.region
  service  = google_cloud_run_service.ingester_service.name
  role     = "roles/run.invoker"
  member   = "allUsers"
  # Remove this block or change 'allUsers' to specific service accounts for authenticated access.
}

# -----------------------------------------------------------------------------
# Pub/Sub Topics (Main and Dead Letter)
# -----------------------------------------------------------------------------
resource "google_pubsub_topic" "main_events_topic" {
  project = var.project_id
  name    = "main-events-topic"
}

resource "google_pubsub_topic" "dlq_events_topic" {
  project = var.project_id
  name    = "dlq-events-topic"
}

# Pub/Sub Subscription (if Cloud Run pulls from Pub/Sub)
# This example assumes direct HTTP ingestion, but if using Pub/Sub as input,
# you'd create a push subscription to the Cloud Run service here.
/*
resource "google_pubsub_subscription" "cloud_run_push_subscription" {
  project = var.project_id
  name    = "cloud-run-ingester-sub"
  topic   = google_pubsub_topic.main_events_topic.name

  ack_deadline_seconds = 600 # Adjust based on processing time
  message_retention_duration = "604800s" # 7 days

  push_config {
    push_endpoint = google_cloud_run_service.ingester_service.status[0].url
    oidc_token {
      service_account_email = google_service_account.ingester_sa.email
    }
  }

  # Enable Dead Letter Queue
  dead_letter_policy {
    dead_letter_topic     = google_pubsub_topic.dlq_events_topic.id
    max_delivery_attempts = 5
  }

  # Enable exactly-once delivery (requires corresponding client-side support)
  enable_exactly_once_delivery = true
}
*/

# -----------------------------------------------------------------------------
# BigQuery Dataset and Table
# -----------------------------------------------------------------------------
resource "google_bigquery_dataset" "event_dataset" {
  project    = var.project_id
  dataset_id = var.dataset_id
  location   = var.region
  description = "Dataset for storing application event data."
}

resource "google_bigquery_table" "events_table" {
  project    = var.project_id
  dataset_id = google_bigquery_dataset.event_dataset.dataset_id
  table_id   = var.table_id
  deletion_protection = false # Set to true in production for critical tables

  schema = jsonencode([
    {
      name        = "event_id"
      type        = "STRING"
      mode        = "REQUIRED"
      description = "Unique identifier for the event"
    },
    {
      name        = "event_timestamp"
      type        = "TIMESTAMP"
      mode        = "REQUIRED"
      description = "Timestamp when the event occurred"
    },
    {
      name        = "user_id"
      type        = "INTEGER"
      mode        = "NULLABLE"
      description = "Identifier for the user"
    },
    {
      name        = "session_id"
      type        = "STRING"
      mode        = "NULLABLE"
      description = "Identifier for the user session"
    },
    {
      name        = "action"
      type        = "STRING"
      mode        = "NULLABLE"
      description = "Type of action performed"
    },
    {
      name        = "payload"
      type        = "JSON"
      mode        = "NULLABLE"
      description = "JSON payload containing additional event details"
    }
  ])

  time_partitioning {
    type                    = "DAY"
    field                   = "event_timestamp"
    expiration_ms           = 90 * 24 * 60 * 60 * 1000 # 90 days in milliseconds
    require_partition_filter = true
  }

  clustering = ["user_id", "session_id"] # Order matters for clustering

  labels = {
    env = "production"
    app = "ingestion"
  }
}

# -----------------------------------------------------------------------------
# Cloud Run Service (FastAPI Receiver)
# -----------------------------------------------------------------------------
resource "google_cloud_run_service" "ingester_service" {
  project  = var.project_id
  location = var.region
  name     = var.cloud_run_service_name

  template {
    spec {
      service_account_name = google_service_account.ingester_sa.email
      containers {
        image = "gcr.io/${var.project_id}/${var.cloud_run_service_name}:${var.image_tag}"
        env {
          name  = "GCP_PROJECT_ID"
          value = var.project_id
        }
        env {
          name  = "BQ_DATASET_ID"
          value = google_bigquery_dataset.event_dataset.dataset_id
        }
        env {
          name  = "BQ_TABLE_ID"
          value = google_bigquery_table.events_table.table_id
        }
        resources {
          cpu_idle = true # Optimize for CPU usage when idle
          limits = {
            cpu    = "1000m" # 1 CPU
            memory = "2Gi"   # 2 GB RAM
          }
        }
      }
      container_concurrency = 80 # Max concurrent requests per instance
    }

    metadata {
      annotations = {
        "autoscaling.knative.dev/minScale" = "1"
        "autoscaling.knative.dev/maxScale" = "10"
        "run.googleapis.com/client-name" = "terraform"
        "run.googleapis.com/vpc-access-connector" = "" # If using VPC Access
        "run.googleapis.com/vpc-access-egress" = "all" # If using VPC Access
      }
    }
  }

  traffic {
    percent         = 100
    latest_revision = true
  }

  timeouts {
    create = "10m"
    update = "10m"
  }

  lifecycle {
    ignore_changes = [
      template[0].metadata[0].annotations["autoscaling.knative.dev/minScale"],
      template[0].metadata[0].annotations["autoscaling.knative.dev/maxScale"],
    ]
  }
}

# -----------------------------------------------------------------------------
# Cloud Run Job (v2 Worker - e.g., for schema migrations or backfills)
# -----------------------------------------------------------------------------
resource "google_cloud_run_v2_job" "bq_maintenance_job" {
  project  = var.project_id
  location = var.region
  name     = var.cloud_run_job_name

  template {
    template {
      service_account_name = google_service_account.ingester_sa.email
      containers {
        image = "gcr.io/${var.project_id}/${var.cloud_run_job_name}:${var.image_tag}"
        env {
          name  = "GCP_PROJECT_ID"
          value = var.project_id
        }
        env {
          name  = "BQ_DATASET_ID"
          value = google_bigquery_dataset.event_dataset.dataset_id
        }
        env {
          name  = "BQ_TABLE_ID"
          value = google_bigquery_table.events_table.table_id
        }
        resources {
          limits = {
            cpu    = "1000m"
            memory = "512Mi"
          }
        }
      }
      timeout = "3600s" # 1 hour timeout for the job
      task_count = 1 # Number of parallel tasks
    }
    # This example does not define an execution template directly,
    # as it's typically triggered manually or by Cloud Scheduler.
  }
  labels = {
    env = "production"
    app = "bq-maintenance"
  }
}
Thực Hành Tốt Về IAM:
roles/bigquery.dataEditor: Cấp quyền ghi dữ liệu vào các bảng BigQuery trong project. Đây là mức tối thiểu cần thiết cho Storage Write API.roles/run.invoker: Cho phépallUsersgọi dịch vụ Cloud Run. Với các dịch vụ nội bộ, hãy giới hạn quyền này cho các service account hoặc người dùng cụ thể.roles/pubsub.publisher: Cần thiết nếu dịch vụ Cloud Run phát hành message tới Pub/Sub (ví dụ: tới một DLQ).roles/pubsub.viewervàroles/pubsub.subscriber: Nếu Cloud Run được cấu hình để kéo message từ một Pub/Sub subscription (không hiển thị trong ví dụ chính, nhưng có trong phần bình luận của Terraform).
6. Phân Tích Chi Phí
Hiểu và tối ưu chi phí là điều tối quan trọng đối với các hệ thống production. Dưới đây là bảng phân tích chi phí đơn vị theo từng dịch vụ cùng một ví dụ tính toán cụ thể.
Chi Phí Đơn Vị Từng Dịch Vụ (Xấp xỉ, tính đến cuối năm 2023 - luôn kiểm tra bảng giá GCP!)
| Thành phần dịch vụ | Chi phí đơn vị | Ghi chú |
|---|---|---|
| Cloud Run | ||
| CPU (hoạt động) | $0.00002400 / vCPU-giây | Chỉ bị tính phí khi đang xử lý request. |
| CPU (nhàn rỗi) | $0.00000600 / vCPU-giây | Dành cho min-instances. Mức giá thấp hơn cho việc giữ instance ấm. |
| Bộ nhớ (hoạt động) | $0.00000250 / GiB-giây | Chỉ bị tính phí khi đang xử lý request. |
| Bộ nhớ (nhàn rỗi) | $0.000000625 / GiB-giây | Dành cho min-instances. |
| Số request | $0.40 / triệu request | Bao gồm các HTTP request. |
| Egress mạng | 0.12 - 0.23 / GiB (tùy bậc) | Dữ liệu rời khỏi GCP. |
| Pub/Sub | ||
| Message Ingress/Egress | $40 / TiB | 10 GiB đầu mỗi tháng miễn phí. Tính phí theo message được phát/chuyển giao. |
| Lưu trữ message | $10 / GiB-tháng | Dành cho message được giữ lại quá 7 ngày (ví dụ: trong DLQ hoặc subscription giữ lâu). |
| BigQuery | ||
| Storage Write API (SA) | $0.05 / GiB | Dữ liệu được ghi qua Storage Write API. |
| Lưu trữ hoạt động | $0.02 / GiB-tháng | Dành cho dữ liệu trong lưu trữ hoạt động. 10 GiB đầu mỗi tháng miễn phí. |
| Lưu trữ dài hạn | $0.01 / GiB-tháng | Dành cho dữ liệu không bị chạm tới trong 90 ngày liên tiếp. |
| Truy vấn On-Demand | $6.25 / TiB được quét | Dành cho truy vấn phân tích (1 TiB đầu mỗi tháng miễn phí). Không dùng trực tiếp cho nhập dữ liệu, mà cho phía hạ nguồn. |
Ví Dụ Tính Chi Phí Hàng Tháng
Hãy giả định một khối lượng cụ thể:
- Khối lượng: 100 triệu sự kiện mỗi tháng.
- Kích thước sự kiện: Trung bình 1 KB mỗi sự kiện (sau khi serialize JSON).
- Cloud Run: 1 vCPU, 2 GiB RAM,
concurrency80,min-instances1,max-instances10. - BigQuery: Hết hạn partition sau 90 ngày.
1. Chi phí Cloud Run:
- Số request: 100.000.000 request / 1.000.000 * 0.40 = 40.00
- Dữ liệu xử lý: 100 triệu sự kiện * 1KB/sự kiện = 100 GiB. Giả định mức sử dụng CPU/bộ nhớ 50%.
- CPU: 100 GiB / (80 req/instance * 1KB/req) * (1 vCPU * mức sử dụng 0.5) * (trung bình 0.1s/req) * 0.000024/vCPU-giây = ~0.000000001 (không đáng kể, cách tính thực tế phức tạp hơn, nhưng với concurrency cao và thời gian xử lý mỗi request thấp, chi phí CPU thường rất nhỏ)
- Hãy đơn giản hóa: 100 triệu request, thời gian xử lý trung bình 100ms mỗi request. Tổng số CPU-giây hoạt động: 100 triệu * 0.1s / 80 concurrency = 125.000 CPU-giây.
- Chi phí CPU: 125.000 * 0.000024 = 3.00
- Chi phí bộ nhớ: 125.000 * (2GiB / 3600s/giờ) * 0.00000250/GiB-giây = ~0.01
- Nhàn rỗi từ
min-instances(1 instance, 24/7):- CPU nhàn rỗi: 1 vCPU * 24 * 30 * 3600 giây/tháng * 0.000006 = 15.55
- Bộ nhớ nhàn rỗi: 2 GiB * 24 * 30 * 3600 giây/tháng * 0.000000625 = 3.24
- Tổng Cloud Run (xấp xỉ): 40 (request) + 3 (CPU hoạt động) + 0.01 (bộ nhớ hoạt động) + 15.55 (CPU nhàn rỗi) + 3.24 (bộ nhớ nhàn rỗi) = **~61.80**
2. Chi phí BigQuery Storage Write API:
- Dữ liệu nhập vào: 100 GiB
- Chi phí: 100 GiB * 0.05/GiB = **5.00**
3. Chi phí lưu trữ BigQuery:
- Dữ liệu lưu trữ (hoạt động): 100 GiB/tháng * 3 tháng (do giữ 90 ngày) = 300 GiB.
- Chi phí (hoạt động): (300 GiB - 10 GiB miễn phí) * 0.02/GiB = **5.80**
- Lưu trữ dài hạn: Sau 90 ngày, dữ liệu trở thành dài hạn. Nếu chúng ta giữ 90 ngày rồi hết hạn, nó sẽ không chạm tới lưu trữ dài hạn. Nếu giữ lâu hơn, ví dụ 1 năm, thì một phần dữ liệu sẽ chuyển đổi. Với kịch bản này, giả định dữ liệu hết hạn trước khi trở thành dài hạn.
- Tổng lưu trữ BigQuery (xấp xỉ): ~$5.80
4. Chi phí Pub/Sub (nếu dùng cho đầu vào):
- Ingress/Egress dữ liệu: 100 GiB. 10 GiB đầu miễn phí.
- Chi phí: (100 GiB - 10 GiB miễn phí) * 40/TiB = 90 GiB * 0.04/GiB = $3.60
- Tổng Pub/Sub (xấp xỉ): ~$3.60
Tổng chi phí hàng tháng ước tính: 61.80 (Cloud Run) + 5.00 (BQ Write API) + 5.80 (BQ Storage) + 3.60 (Pub/Sub) = ~$76.20
Đây chỉ là một ước tính rất sơ lược. Chi phí thực tế phụ thuộc nặng nề vào thời gian xử lý, mức sử dụng nhàn rỗi, egress mạng, và các mẫu sử dụng BigQuery cụ thể.
Các Đòn Bẩy Tối Ưu Chi Phí Hàng Đầu, Xếp Theo Mức Tác Động
- Phân vùng & Phân cụm BigQuery: Tác động cao nhất. Giảm chi phí truy vấn bằng cách tối thiểu hóa lượng dữ liệu bị quét. Cực kỳ quan trọng với mọi khối lượng công việc phân tích.
require_partition_filterlà bắt buộc. - Hết hạn partition của BigQuery: Tác động cao. Tự động xóa dữ liệu cũ, trực tiếp giảm chi phí lưu trữ BigQuery. Hãy căn cứ vào chính sách giữ dữ liệu.
- Tối ưu schema BigQuery: Tác động cao. Dùng kiểu dữ liệu phù hợp (ví dụ:
INT64thay vìSTRINGcho các ID,DATEthay vìTIMESTAMPnếu không cần phần giờ trong ngày). Tránh các cột thừa. Điều này giảm dung lượng lưu trữ và chi phí quét dữ liệu truy vấn. - Concurrency của Cloud Run: Tác động trung bình-cao. Concurrency cao (nếu ứng dụng của bạn thực sự bất đồng bộ) cho phép ít instance hơn xử lý nhiều request hơn, giảm tổng mức tiêu thụ CPU/bộ nhớ và chi phí nhàn rỗi.
min-instancescủa Cloud Run: Tác động trung bình. Đặtmin-instances=0khi khởi động lạnh là chấp nhận được với các pipeline không quan trọng sẽ tiết kiệm chi phí nhàn rỗi. Với việc nhập dữ liệu quan trọng và yêu cầu độ trễ thấp, mộtmin-instancesnhỏ thường là hợp lý.- Gom lô cho BigQuery Storage Write API: Tác động trung bình. Gửi các lô hàng lớn hơn mỗi
AppendRowsRequestgiảm số lần gọi gRPC và chi phí phụ đi kèm, có thể cải thiện thông lượng và hiệu quả. Tránh các lô quá nhỏ. - Thời gian giữ message của Pub/Sub: Tác động thấp-trung bình. Hãy giữ thời gian giữ message ngắn nhất mà vẫn cần thiết (mặc định 7 ngày thường là đủ). Chỉ gia hạn khi có nhu cầu khôi phục cụ thể, vì giữ lâu hơn sẽ phát sinh chi phí lưu trữ.
7. Khả Quan Sát, Chế Độ Lỗi Và Củng Cố Cho Production
Xây dựng một pipeline production đòi hỏi nhiều hơn chỉ là mã nguồn; nó cần các thực hành vận hành vững chắc.
Hàng Đợi Chết (DLQ)
DLQ là thành phần thiết yếu để cô lập và quản lý các message không thể xử lý thành công.
- DLQ của Pub/Sub: Nếu dùng Pub/Sub làm nguồn sự kiện, hãy cấu hình một DLQ trên subscription. Các message vượt quá
max_delivery_attemptssẽ tự động được chuyển tiếp. - DLQ ở tầng ứng dụng Cloud Run: Nếu Cloud Run nhận HTTP request trực tiếp, hoặc nếu có lỗi xử lý nội bộ xảy ra trước khi tới BigQuery, chính ứng dụng đó nên ghi lại sự kiện thất bại và, lý tưởng nhất, phát hành nó tới một topic DLQ riêng của Pub/Sub.
- Xử lý message trong DLQ: Thiết lập một tiến trình riêng (ví dụ: một Cloud Function, một Cloud Run Job) để tiêu thụ từ DLQ, phân tích nguyên nhân thất bại, sửa dữ liệu (nếu có thể), rồi nhập lại hoặc lưu trữ. Điều này ngăn message độc hại chặn pipeline chính.
Xử Lý Schema Drift
Lược đồ dữ liệu sẽ thay đổi. Pipeline của bạn phải có khả năng chịu đựng những thay đổi này.
- Schema linh hoạt của BigQuery: BigQuery hoạt động theo kiểu schema-on-read. Bạn có thể thêm các cột nullable mới vào một bảng hiện có mà không phá vỡ các truy vấn cũ hay cần thời gian ngừng hoạt động.
- Kiểm tra ở tầng ứng dụng: Các model Pydantic trong FastAPI cung cấp kiểm tra schema nghiêm ngặt.
- Chế độ nghiêm ngặt: Nếu một field đến không có trong model Pydantic, nó sẽ bị từ chối. Tốt cho việc thực thi hợp đồng dữ liệu chặt chẽ.
- Chế độ linh hoạt: Dùng
extra='allow'trong Pydantic hoặcDict[str, Any]để cho phép các field không xác định, sau đó lưu chúng vào một cột kiểuJSONtrong BigQuery. Điều này thường được ưu tiên với dữ liệu sự kiện.
- Chiến lược tiến hóa schema:
- Thay đổi tương thích ngược: Thêm các field nullable mới vào schema bảng BigQuery. Cập nhật model Pydantic để bao gồm các field mới (biến chúng thành
Optional). - Thay đổi phá vỡ tương thích (ví dụ: đổi tên, đổi kiểu): Nên tránh nếu có thể. Nếu bắt buộc, hãy tạo một bảng mới, di chuyển dữ liệu, rồi chuyển đích nhập sang bảng mới.
- Dữ liệu không hợp lệ/lỗi định dạng: Lưu vào một bảng "cách ly" riêng hoặc đẩy vào một DLQ cụ thể để kiểm tra thủ công.
- Thay đổi tương thích ngược: Thêm các field nullable mới vào schema bảng BigQuery. Cập nhật model Pydantic để bao gồm các field mới (biến chúng thành
Message Độc Hại
Message độc hại là loại message liên tục gây ra lỗi xử lý, ngay cả sau khi đã thử lại nhiều lần.
- Cơ chế DLQ: DLQ của Pub/Sub và các DLQ ở tầng ứng dụng là hàng phòng thủ chính. Sau một số lần thử lại có thể cấu hình, message sẽ được chuyển đi, ngăn nó chặn vô thời hạn hàng đợi xử lý chính.
- Giám sát & cảnh báo: Hãy theo dõi dung lượng DLQ. Một DLQ phình to là dấu hiệu của vấn đề message độc hại hoặc một sự cố mang tính hệ thống.
- Phân tích: Kiểm tra các message độc hại để hiểu nguyên nhân gốc (ví dụ: JSON không hợp lệ, kiểu dữ liệu không mong đợi, lỗi ứng dụng).
Hạn Ngạch Và Ngữ Nghĩa Thử Lại Với Exponential Backoff
Các dịch vụ GCP đều có hạn ngạch. Vượt quá hạn ngạch sẽ dẫn tới lỗi RESOURCE_EXHAUSTED.
- Hạn ngạch BigQuery Storage Write API: Giới hạn QPS theo project/vùng.
- Hạn ngạch Cloud Run: Giới hạn số instance, giới hạn CPU.
- Logic thử lại: Client của bạn (bộ nhận Cloud Run) phải hiện thực logic thử lại vững chắc với exponential backoff và jitter.
- Exponential Backoff: Tăng khoảng thời gian chờ giữa các lần thử lại theo cấp số nhân (ví dụ: 1s, 2s, 4s, 8s...).
- Jitter: Thêm một khoảng chờ ngẫu nhiên nhỏ để tránh vấn đề "bầy ong đông" khi nhiều client cùng thử lại đồng thời.
- Số lần thử lại tối đa: Xác định số lần thử lại tối đa trước khi báo lỗi request và gửi nó tới DLQ.
- Client libraries: Các thư viện client của Google Cloud thường đã có sẵn cơ chế thử lại, nhưng hãy kiểm tra cấu hình của chúng.
Cảnh Báo Và SLO
Hãy định nghĩa Service Level Objectives (SLO) và thiết lập cảnh báo để chủ động phát hiện sự cố.
- Các chỉ số chính (Cloud Monitoring):
- Cloud Run:
- Độ trễ request (p99, p95)
- Tỉ lệ lỗi (HTTP response 5xx)
- Số lượng request
- Mức sử dụng CPU, mức sử dụng bộ nhớ
- Số instance
- BigQuery:
- Độ trễ
append_rowscủa Storage Write API - Số lỗi
append_rowscủa Storage Write API - Khối lượng dữ liệu đã nhập
- Dung lượng lưu trữ của bảng
- Độ trễ
- Pub/Sub (nếu dùng):
- Số message chưa được giao (kích thước backlog)
- Tuổi của message chưa xác nhận cũ nhất
- Số message trong DLQ
- Cloud Run:
- SLO:
- Tính khả dụng: Endpoint nhập dữ liệu khả dụng 99.9% thời gian (ví dụ: < 0.1% lỗi 5xx).
- Độ trễ: Độ trễ nhập dữ liệu P99 < 5 giây.
- Thông lượng: Nhập thành công X sự kiện mỗi giây.
- Độ tươi mới dữ liệu: Dữ liệu hiển thị được trong BigQuery trong vòng Y phút kể từ khi sự kiện xảy ra.
- Cảnh báo: Cấu hình cảnh báo trong Cloud Monitoring (hoặc hệ thống cảnh báo bạn ưu tiên) khi SLO bị vi phạm. Định tuyến cảnh báo tới kỹ sư trực.
Bảng Xử Lý Sự Cố Theo Runbook
Một runbook cung cấp các bước rõ ràng, hành động được cho các tình huống lỗi thường gặp.
| Tình huống lỗi | Triệu chứng | Các bước khắc phục | Cách giải quyết |
|---|---|---|---|
| Lỗi 5xx từ Cloud Run | Tỉ lệ 5xx tăng, độ trễ cao, instance sập | Kiểm tra log Cloud Run để tìm exception. Theo dõi mức sử dụng CPU/Bộ nhớ. | Điều tra lỗi mã nguồn. Tăng giới hạn CPU/Memory. Điều chỉnh concurrency. |
| Cloud Run chạm Max Instances | Đạt max_instances, request bị xếp hàng/bị loại bỏ | Kiểm tra tốc độ request so với năng lực xử lý. Theo dõi concurrency. | Tăng max_instances (nếu ngân sách cho phép). Tối ưu mã nguồn để xử lý nhanh hơn. |
| Lỗi ghi BigQuery | Lỗi BigQueryWriteClient, thiếu dữ liệu trong BQ | Kiểm tra hạn ngạch BigQuery Storage Write API. Kiểm tra schema bảng. | Đề nghị tăng hạn ngạch. Sửa schema ứng dụng. Thử lại các lô thất bại từ DLQ. |
| Backlog DLQ của Pub/Sub tăng | Số message trong dlq-events-topic tăng | Kiểm tra message trong DLQ. Kiểm tra log ứng dụng nhập dữ liệu để tìm lỗi thường gặp. | Xác định nguyên nhân message độc hại. Triển khai bản sửa. Xử lý lại các message trong DLQ. |
| Dữ liệu không xuất hiện trong BQ | Bảng rỗng/cũ, SELECT COUNT(*) thấp | Kiểm tra log Cloud Run để biết _write_to_bigquery_sync thành công hay thất bại. Xác nhận stream đã commit. | Bảo đảm finalize_write_stream và batch_commit_write_streams được gọi. |
| Chi phí truy vấn BigQuery cao | Cảnh báo chi phí cho mức sử dụng truy vấn BigQuery. | Phân tích các mẫu truy vấn. Kiểm tra xem đã dùng phân vùng/phân cụm chưa. | Thực thi require_partition_filter. Tối ưu truy vấn. Rà soát schema. |
8. Checklist Production Và Kết Luận
Trước khi đưa pipeline nhập dữ liệu serverless của bạn lên production, hãy chắc chắn rằng bạn đã xử lý các khía cạnh quan trọng sau:
Checklist Production
- IAM: Đã cấu hình service account theo nguyên tắc đặc quyền tối thiểu cho mọi thành phần.
- Mạng: VPC Service Controls (nếu cần cho ranh giới bảo mật).
- Giám sát & Cảnh báo: Dashboard và cảnh báo toàn diện cho mọi chỉ số chính và SLO.
- Logging: Đã hiện thực logging có cấu trúc trong ứng dụng Cloud Run, được Cloud Logging thu thập.
- Xử lý lỗi: Logic thử lại vững chắc với exponential backoff và jitter. Đã cấu hình và giám sát Dead Letter Queue (DLQ).
- Quản lý Schema: Chiến lược rõ ràng cho việc tiến hóa và kiểm tra schema.
- Idempotency: Đã hiện thực khóa idempotency ở tầng ứng dụng cho các lần thử lại từ client.
- Bảo mật: Secret được quản lý an toàn (ví dụ: Secret Manager). Không có dữ liệu nhạy cảm trong log.
- Quản lý chi phí: Đã cấu hình cảnh báo ngân sách. Rà soát thường xuyên các yếu tố chi phí.
- Kiểm thử hiệu năng: Đã thực hiện load testing để xác nhận khả năng mở rộng và xác định điểm nghẽn.
- Tắt êm ái: Ứng dụng Cloud Run xử lý
SIGTERMđể hoàn tất các stream BigQuery đang dở. - Terraform: Toàn bộ hạ tầng được định nghĩa trong Terraform, đã được rà soát và kiểm soát phiên bản. Bật
deletion_protectioncho các tài nguyên quan trọng. - Tài liệu: Runbook, sơ đồ kiến trúc và định nghĩa schema luôn cập nhật.
Kết Luận Và Các Đánh Đổi Chính
Xây dựng một pipeline nhập dữ liệu serverless với BigQuery và Cloud Run mang lại lợi ích to lớn:
- Khả năng mở rộng: Tự động co giãn để xử lý tải biến động mà không cần can thiệp thủ công.
- Độ tin cậy: Tận dụng khả năng đệm của Pub/Sub, ngữ nghĩa exactly-once của BigQuery Storage Write API, và xử lý lỗi vững chắc.
- Hiệu quả chi phí: Mô hình trả theo mức sử dụng, được tối ưu bởi việc sử dụng tài nguyên hiệu quả cùng các tối ưu lưu trữ/truy vấn của BigQuery.
- Giảm gánh nặng vận hành: Không còn máy chủ để quản lý, vá lỗi hay nâng cấp.
Tuy nhiên, cách tiếp cận này cũng đi kèm những đánh đổi:
- Độ phức tạp của hệ thống phân tán: Mặc dù serverless đã che giấu hạ tầng, việc quản lý trạng thái phân tán, tính nhất quán cuối cùng, và các tình huống lỗi phức tạp vẫn đòi hỏi thiết kế cẩn thận.
- Phụ thuộc vào một nhà cung cấp: Tích hợp sâu với các dịch vụ GCP có thể khiến việc chuyển sang cloud khác trở nên khó khăn hơn.
- Thách thức về khả quan sát: Gỡ lỗi trong hệ thống phân tán có thể khó hơn ứng dụng nguyên khối, đòi hỏi tracing tốt và logging có cấu trúc.
- Minh bạch chi phí: Dù hiệu quả về chi phí, việc hiểu và dự đoán chi phí có thể khó nếu không theo dõi cẩn thận và phân tích các mẫu sử dụng.
- Khởi động lạnh: Dù đã được giảm thiểu bằng
min-instances, các hàm serverless vẫn có thể gặp đột biến độ trễ trong lúc khởi động lạnh nếu không được quản lý.
Bằng cách cân nhắc cẩn thận các khía cạnh này và triển khai những chiến lược chi tiết đã trình bày trong bài viết này, bạn có thể xây dựng một pipeline nhập dữ liệu serverless cực kỳ hiệu quả, đạt chuẩn production, một cách đáng tin cậy nuôi dưỡng các sáng kiến phân tích dữ liệu và học máy của bạn. Kiến trúc này là một trụ cột của các nền tảng dữ liệu hiện đại, cho phép lặp nhanh và ra quyết định dựa trên dữ liệu với khả năng mở rộng.
Bạn Có Thể Thích Những Bài Này
- Terraform State Management Best Practices
- Terraform State Lock and Backend Architecture Guide
- Docker Compose for Local Development: A Complete Setup Guide
- Docker BuildKit Cache Mounts: Python uv, Go & Node.js Guide (2026)
Kiểm tra kiến thức
Một ứng dụng kinh doanh quan trọng tạo ra các sự kiện có khối lượng lớn, độ trễ thấp cần được đưa vào BigQuery. Nhóm đang tranh luận liệu có nên gửi các sự kiện trực tiếp đến Cloud Run receiver qua HTTP hay trước tiên publish chúng đến một Pub/Sub topic. Với mục tiêu xây dựng một hệ thống production-grade, lợi thế chính của việc đưa Pub/Sub vào pipeline là gì?
Công cụ lập trình trực tiếp trên trình duyệt
Làm sạch log AI CLI, tạo biểu thức cron, giải mã JWT và tính quyền chmod offline.
Bài viết liên quan
Kho dữ liệu phân tích Serverless với BigQuery & Cloud Run: Từ luồng GA4 đến cảnh báo SEO tự động
Tìm hiểu cách xây dựng kho dữ liệu phân tích serverless tự động với BigQuery, Google Analytics 4 và Cloud Run: mô hình hóa lược đồ, chuyển đổi SQL theo lịch trình, chi phí không tải và cảnh báo truy vấn SEO tự động.
Đọc tiếp
Cẩm Nang Kiến Trúc GCP Thực Dụng: Dịch Vụ Nào Thực Sự Nên Dùng (Và Nên Tránh Điều Gì)
Cẩm nang production đã được kiểm chứng về Google Cloud Platform. Tìm hiểu vì sao Cloud Run thắng GKE trong 90% workload, cách tận dụng BigQuery và Secret Manager, cùng 5 bẫy chi phí ẩn đang làm cạn kiệt ngân sách cloud.
Đọc tiếp
Khoa học Dữ liệu Tốc độ Cao: DuckDB và Polars cho Phân tích Hiệu suất Cao
Bỏ qua Pandas ngốn bộ nhớ: tăng tốc các pipeline dữ liệu với Polars (đa luồng Rust, LazyFrames, Arrow) và DuckDB (SQL vector hóa trong tiến trình, streaming Parquet out-of-core).
Đọc tiếp