•17分で読める
Retrieval-Augmented Generation (RAG)を理解する

Locionic(@Locionic)
Claude、GPT-4、Llamaといった大規模言語モデル(LLM)は、その驚くべき自然言語推論能力とコード合成能力によって、現代のコンピューティングに革命をもたらしました。
しかし、何十億ものパラメータを持つにもかかわらず、LLMは本番の企業環境にデプロイされると、2つの致命的な脆弱性に悩まされます。
- ハルシネーション(Hallucinations): 権威的で流暢だが、事実に基づかない記述を生成する傾向。
- 知識のカットオフ(Knowledge Cutoffs): 企業の非公開文書、最新の顧客記録、モデルのトレーニング日以降に発生したイベントにアクセスできないこと。
これまで、組織はファインチューニングによってこれを解決しようと試みてきました。しかし、ファインチューニングは計算コストが高く、古い事実を忘れるのに苦労し、証明可能な情報源の引用を提供できません。
普遍的なアーキテクチャソリューションが**検索拡張生成(Retrieval-Augmented Generation: RAG)**です。
RAGは、LLMのパラメトリックな推論能力と、動的で非パラメトリックな企業知識ベースとの間のギャップを埋め、事実に基づいた根拠と監査可能性を保証します。
Audio Briefing• Voice: Google Cloud ja-JP-Neural2-B
0:00 / --:--
コアコンセプト:パラメトリックメモリと非パラメトリックメモリ
RAGを理解するためには、AIシステムにおける2種類の知識表現を区別する必要があります。
- パラメトリックメモリ(Parametric Memory): 事前学習中にニューラルネットワーク内に固定された、静的な重みと数十億の浮動小数点パラメータ。広範な推論パターン、文法規則、世界知識を格納します。
- 非パラメトリックメモリ(Non-Parametric Memory): 外部の動的に更新可能な知識ストア。通常は、独自のPDF、データベーススキーマ、ドキュメントを含むベクトルデータベースまたは全文検索エンジンです。
RAGパイプラインでは、LLMは百科事典としてではなく、分析推論エンジンとして扱われます。ユーザーが質問をすると、システムは非パラメトリックメモリをクエリし、最も関連性の高い事実の段落を取得し、それらをプロンプトのコンテキストウィンドウに挿入し、LLMに次のように指示します。「提供された参照ドキュメントのみを使用してユーザーの質問に答えてください。情報源を引用してください。」
3段階のプロダクションRAGアーキテクチャ
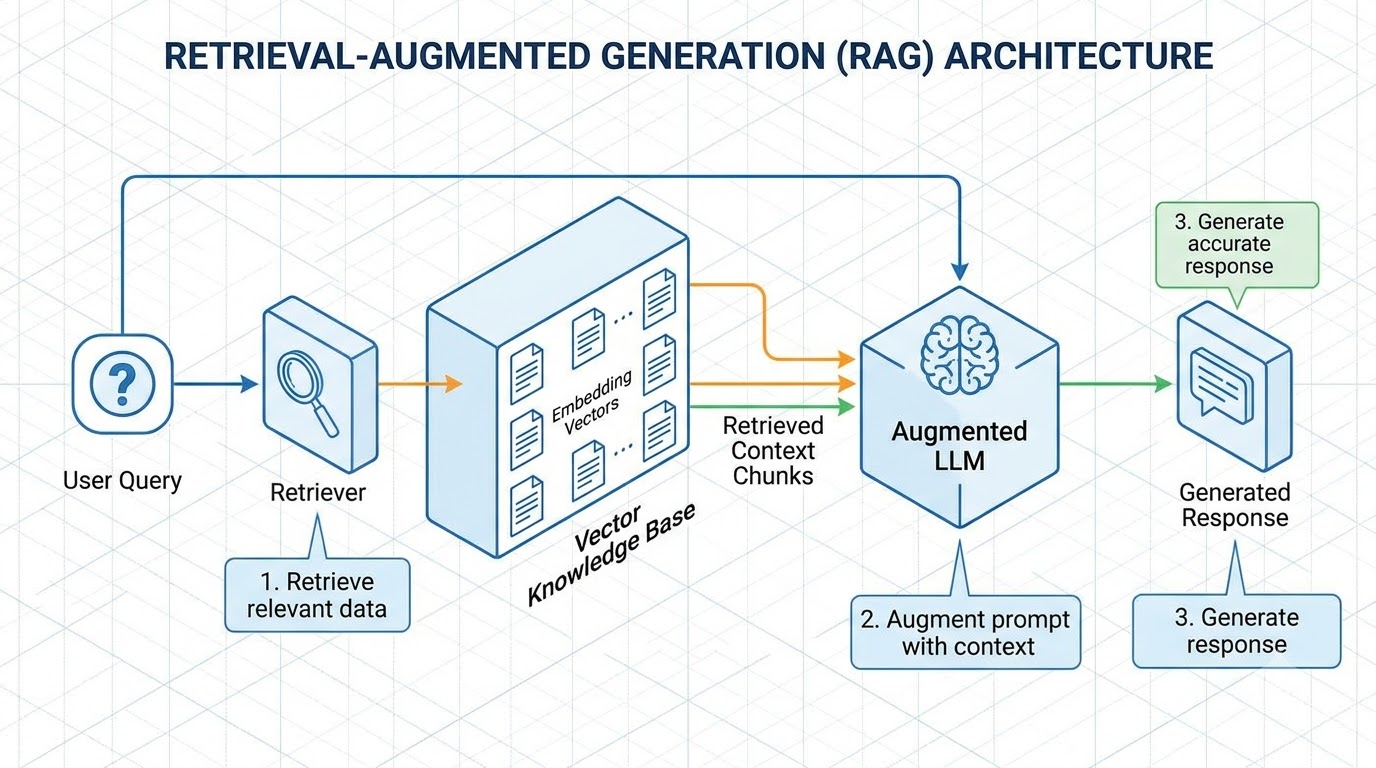
プロダクションレベルのRAGパイプラインは、取り込み(Ingestion)、検索(Retrieval)、**生成(Generation)**の3つの連続したフェーズで構成されます。
[ INGESTION ]
Raw Docs ──> Chunking ──> Embedding Model ──> Vector Database (pgvector / Qdrant)

[ RETRIEVAL & RERANKING ]
User Query ──> Hybrid Search (Dense Vector + BM25) ──> Cross-Encoder Reranker ──> Top-K Chunks

[ GENERATION ]
Prompt = Context Chunks + User Query ──> LLM (Claude / GPT-4) ──> Factual Cited Answer
フェーズ1:取り込みとセマンティックチャンキング
200ページのPDFを単一のレコードとしてベクトルデータベースにそのまま投入することはできません。取り込みステージでは、高解像度の検索のために生データを準備します。
- テキスト抽出: ヘッダー、フッターの削除、スキャンされたドキュメントのOCRクリーンアップ。
- チャンキング戦略: テキストを個別のセグメントに分割します。一般的な戦略は次のとおりです。
- 固定サイズチャンキング: 512トークンのチャンクを10%の重複で作成します(シンプルですが、文中のコンテキストを分断する可能性があります)。
- セマンティック/段落チャンキング: 自然なマークダウンの見出し、段落、または文の境界に沿ってテキストを分割します。
- 階層的チャンキング(親子): 細かいベクトルマッチングのために小さなチャンク(128トークン)を格納しますが、物語のコンテキストを保持するために、より大きな囲む親チャンク(1,024トークン)をLLMに返します。
- ベクトル埋め込み: チャンクを埋め込みモデル(
text-embedding-3-smallやbge-large-en-v1.5など)に通し、テキストを1,536次元のセマンティック座標空間にマッピングします。
フェーズ2:高度なハイブリッド検索とリランキング
素朴なRAGシステムは、ベクトルデータベースでのコサイン類似度検索のみに依存しています。本番環境では、純粋なベクトル検索は以下の点で頻繁に失敗します。
- 正確な製品シリアル番号やSKU(
ERR_TIMEOUT_502)。 - 頭字語や特定の名前(
Dr. Loc Nguyen)。 - 稀な技術的識別子。
これを解決するために、最新のRAGはハイブリッド検索(Hybrid Search)を実装しています。これは、密なベクトル検索(Dense Vector Search)(意味的な概念理解)と疎なキーワード検索(Sparse Keyword Search)(BM25の語彙精度)を**Reciprocal Rank Fusion (RRF)**を使用して組み合わせるものです。
python
# hybrid_retrieval.py
from collections import defaultdict
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[tuple[str, float]]:
    """
    Fuses ranked lists from vector search and BM25 keyword search.
    RRF Score = sum(1 / (k + rank))
    """
    rrf_scores = defaultdict(float)

    for rank, doc_id in enumerate(dense_results):
        rrf_scores[doc_id] += 1.0 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        rrf_scores[doc_id] += 1.0 / (k + rank + 1)

    # Sort documents by descending fusion score
    sorted_docs = sorted(rrf_scores.items(), key=lambda x: x[1], reverse=True)
    return sorted_docs

# Top-ranked chunks are subsequently passed to a Cross-Encoder Reranker
# (such as Cohere Rerank v3) to compute exact query-to-passage relevance scores.
トップ25のハイブリッド結果にクロスエンコーダーリランカー(Cross-Encoder Reranker)(Cohere RerankやBGE-Rerankerなど)を適用することで、システムは完全なクロスアテンションに基づいてパッセージを再スコアリングし、LLMに最も関連性の高い3〜5個のコンテキストチャンクを提示します。
フェーズ3:生成と根拠に基づいたプロンプティング
最終フェーズでは、取得されたチャンクを統合して一貫性のある回答を生成します。プロンプトテンプレートは、ハルシネーションを防ぐために厳格な認識論的謙虚さ(epistemic modesty)を強制する必要があります。
text
You are an enterprise AI assistant for Loc Corp.
Answer the user's question using ONLY the provided context blocks below.
If the answer cannot be deduced from the context, state clearly: "I cannot answer this based on the available records."
Do not invent information. Always cite chunk references (e.g., [Doc 1]).

--- CONTEXT BLOCKS ---
[Doc 1]: Loc Corp standard SLA provides 99.95% uptime for Enterprise tier customers.
[Doc 2]: Enterprise customer tickets receive a 1-hour initial response window.

--- USER QUESTION ---
What is the SLA uptime guarantee for Enterprise clients?

--- ANSWER ---
Advertisement
ベクトルデータベースの状況:2026年比較
| データベース | アーキテクチャタイプ | 強み | 理想的なシナリオ |
|---|---|---|---|
| pgvector (PostgreSQL) | リレーショナル拡張 | ACIDトランザクション、SQL結合、新たなインフラ不要 | 既にPostgresを本番運用している場合 |
| Qdrant | 専用ベクトルエンジン (Rust) | ペイロードフィルタリング、超高速HNSW、ディスク上のベクトル | 高スループットAIマイクロサービス |
| Pinecone | マネージドクラウドサーバーレス | 運用オーバーヘッドゼロ、自動スケーリング | 迅速なプロトタイピング、サーバーレスチーム |
| Chroma | 軽量組み込み / ローカル | 簡単なローカルセットアップ、Pythonネイティブ | エッジデバイス、CLIツール、単体テスト |
RAG品質の評価:RAGトライアド
ランダムな出力を手動で検査するだけでは、RAGパイプラインを最適化することはできません。プロダクションシステムは、RAGトライアド(RagasやTruLensなどのフレームワークによって形式化されています)を監視します。
- コンテキストの関連性(Context Relevance): 検索エンジンはユーザーのクエリに実際に関連するパッセージを取得しましたか?(スコアが低い場合、チャンキングが不適切であるか、埋め込みの不一致を示します)。
- 根拠(Groundedness / Faithfulness): LLMの応答におけるすべての事実の主張は、取得されたコンテキストによって厳密に裏付けられていますか?(スコアが低い場合、モデルのハルシネーションを示します)。
- 回答の関連性(Answer Relevance): 生成された応答は、ユーザーが尋ねた内容に直接答えていますか?(スコアが低い場合、プロンプトのずれや冗長な回避を示します)。
知識を確認する(インタラクティブクイズ)
Interactive Quiz
Question 1 of 2
ある企業は、長くて複雑な技術仕様書を多数含む社内ドキュメントのためにRAGシステムを構築しています。彼らは、チャンクが小さすぎるとLLMが重要なコンテキストを失うこと、またチャンクが大きすぎるとLLMのコンテキストウィンドウを超過することを懸念しています。きめ細かな検索とLLMのための包括的なコンテキストのバランスを取ることで、これらの懸念に最もよく対処できるチャンキング戦略は何ですか?
よくある質問
ファインチューニングは、モデルの内部ニューラル重みを調整して、特定のトーン、スタイル、または出力構文(自然言語からSQLを生成するなど)を学習させます。RAGは、プロンプトコンテキストに外部のリアルタイムの事実を提供します。企業知識の検索においては、RAGの方がはるかに優れています。なぜなら、事実の更新には、数日間のGPU再トレーニングを実行するのではなく、データベースの行を変更するだけで済むからです。
普遍的な数値はありません。密な技術文書の場合、256〜512トークンで50トークンの重複を持たせることで、意味的な特異性と十分な周辺コンテキストのバランスが取れます。法律契約や長い物語形式のポリシーの場合、階層的チャンキング(128トークンの小さな検索チャンクが1,024トークンの親ブロックを指す)が最高の精度を提供します。
RAGは、生のLLM生成と比較してハルシネーションを90%以上削減しますが、完全にゼロにするわけではありません。取得されたパッセージに矛盾する事実が含まれている場合や、モデルがシステムプロンプトの指示を無視した場合、ハルシネーションは依然として発生する可能性があります。「テキストに存在する場合のみ回答する」といった厳密なネガティブプロンプティングと、自動検証ガードレールを使用することが不可欠です。
設計・運用の要点と今後のステップ
検索拡張生成は、実験的なハックからエンタープライズAIエンジニアリングの基盤となるアーキテクチャへと進化しました。
階層的チャンキング、Reciprocal Rank Fusionを用いたハイブリッド密/疎検索、クロスエンコーダーリランキング、そしてRAGトライアドの可観測性を組み合わせることで、エンジニアリングチームは、独自の企業知識の価値を最大限に引き出す、信頼性が高く監査可能なAIアプリケーションを構築できます。
こちらもおすすめ
この記事を共有:
開発者ユーティリティ
ブラウザで動く無料の開発者ツール
AI CLIログの整形、Cron式の作成、JWTの解析、chmod権限の計算をオフラインで実行。
Advertisement
関連記事
ai
本番RAG向けVectorDatabase (2026): Pinecone vs Qdrant vs Milvus vs pgvector
本番RAGパイプライン向けにPinecone、Qdrant、Milvus、pgvectorのアーキテクチャを、HNSW vs IVFFlatインデックス、単段フィルタリング検索、p95レイテンシ、メモリフットプリントでベンチマークします。
続きを読む
ai
ステートフルなAgentic RAG: グラフステートマシン、自己修正ループ、フォールバックルーティング
ステートフルなAgentic RAGについて、グラフステートマシン、自己修正ループ、フォールバックルーティングを、本番環境レベルのアーキテクチャとコード例で網羅的に解説するガイドです。
続きを読む
ai
LangChainとLlamaIndex(2026): 本番RAGパイプラインガイド
本番RAGパイプラインにおけるLangChainとLlamaIndexのアーキテクチャを、ドキュメント解析、ベクトルインデックス、クエリルーティング、レイテンシベンチマークの観点から比較します。
続きを読む