2026年のPython並行処理:AsyncIO、スレッド、プロセス
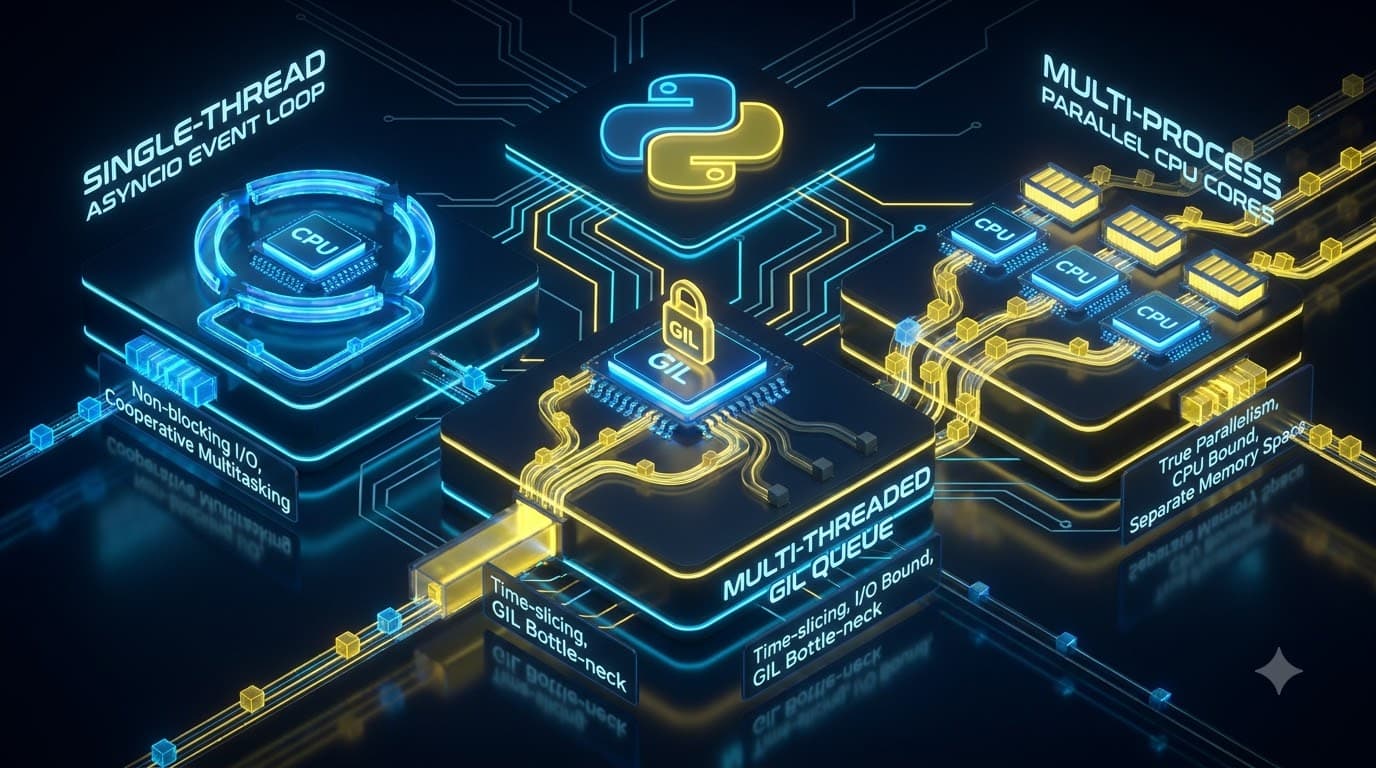

Table of Contents
マルチスレッドCPUの落とし穴
CPU負荷の高いPythonの計算に4つのスレッドを追加すると、シングルスレッドよりも30%から50%遅くなることが多いことをご存知でしたか?この直感に反する速度低下は、CPythonにおける絶え間ないGILミューテックスの競合とコンテキストスイッチングのオーバーヘッドによって引き起こされます。
高性能なPythonバックエンド、データパイプライン、マイクロサービスを記述するには、スレッディング(Threading)、マルチプロセッシング(Multiprocessing)、**AsyncIOコルーチン(Coroutines)**の根本的な違いを習得する必要があります。
パラダイム比較マトリックス
| 側面 | AsyncIO (コルーチン) | スレッディング | マルチプロセッシング |
|---|---|---|---|
| 並行処理モデル | 協調的シングルスレッドイベントループ | プリエンプティブOSスレッド (1つのGILがロックされる) | プリエンプティブな独立したOSプロセス (複数のGIL) |
| メモリモデル | 共有メモリ (超軽量) | 共有メモリ (ロック/ミューテックスが必要) | 分離されたアドレス空間 (IPC / Pickleシリアライゼーション) |
| 最適な用途 | 10,000以上の同時ネットワーク接続 / WebSockets | ブロッキングI/O (レガシーDBドライバー、ファイルシステム呼び出し) | 重いCPU処理、ML推論、画像変換 |
| リソースオーバーヘッド | コルーチンあたり約1KB (事実上無限にスケール可能) | スレッドあたり約8KB~1MBのスタック | プロセスインスタンスあたり約20MB~50MB |
アーキテクチャ決定フローチャート
並行Pythonシステムを設計する際は、この決定木を使用してください。
実際のコード:3つのパラダイムのベンチマーク
import asyncio
import httpx

async def fetch_endpoint(client: httpx.AsyncClient, url: str) -> int:
    response = await client.get(url)
    return response.status_code

async def main():
    urls = ["https://httpbin.org/delay/1"] * 20
    async with httpx.AsyncClient(timeout=10) as client:
        tasks = [fetch_endpoint(client, url) for url in urls]
        # Executes all 20 HTTP calls concurrently in ~1.1 seconds on 1 thread!
        results = await asyncio.gather(*tasks)
        print(f"Fetched {len(results)} endpoints successfully.")

asyncio.run(main())
from concurrent.futures import ThreadPoolExecutor
import urllib.request

def blocking_fetch(url: str) -> int:
    # GIL is automatically released during OS socket read
    with urllib.request.urlopen(url, timeout=10) as resp:
        return resp.status

urls = ["https://httpbin.org/delay/1"] * 20
with ThreadPoolExecutor(max_workers=10) as executor:
    results = list(executor.map(blocking_fetch, urls))
    print(f"Threaded fetch completed for {len(results)} URLs.")
from concurrent.futures import ProcessPoolExecutor
import math

def cpu_heavy_hash(n: int) -> int:
    # True parallel execution across separate CPU cores without GIL bottleneck
    return sum(math.isqrt(i) for i in range(n))

if __name__ == "__main__":
    numbers = [50_000_000] * 8
    with ProcessPoolExecutor() as executor:
        results = list(executor.map(cpu_heavy_hash, numbers))
        print(f"Parallel CPU computation finished on {len(results)} cores!")
並行処理の悪夢を避けるための4つのルール
1. AsyncIO内でブロッキング呼び出しを混ぜない
async def関数内で同期ブロッキング関数(time.sleep()やrequests.get()など)を呼び出すと、すべてのユーザーに対してシングルスレッドのイベントループ全体がフリーズします!ブロッキングコードを呼び出す必要がある場合は、await asyncio.to_thread(blocking_func)でラップしてください。
2. スレッド内の共有メモリをロックミューテックスで保護する
スレッドはメモリを共有するため、counter += 1のような非アトミックな操作は深刻な競合状態を引き起こします。常にthreading.Lock()で共有状態を同期してください。
3. if __name__ == '__main__': でマルチプロセッシングを保護する
WindowsおよびmacOS(spawnメソッド)では、子プロセスがエントリポイントスクリプトを再インポートします。このガードを省略すると、無限のプロセス生成カスケードが発生し、システムがクラッシュします。
4. プロセス間シリアライゼーション(IPC)を最小限に抑える
ギガバイト単位の生データをプロセス間で渡すには、コストのかかるpickleシリアライゼーションが必要です。ゼロコピーのNumPy配列やメモリバッファにはmultiprocessing.shared_memoryを使用してください。
メンタルモデルフラッシュカード
グローバルインタプリタロック (GIL)
グローバルインタプリタロック (GIL)
協調的マルチタスク
協調的マルチタスク
CPUバウンド vs I/Oバウンド
CPUバウンド vs I/Oバウンド
インタラクティブ知識チェック
よくある質問
はい!Python 3.13以降では、実験的な--disable-gil(フリースレッドPython)ビルドが導入されます。有効にすると、マルチスレッドコードはマルチプロセッシングなしで複数のCPUコアで並行して実行できます。
はい!loop.run_in_executor(None, sync_function)またはasyncio.to_thread(sync_function)を使用して、ブロッキングするレガシー同期ライブラリをメインの非同期イベントループを停止させることなくバックグラウンドスレッドプールにオフロードできます。
Pythonにはハードコードされた制限はありませんが、実際のスレッド数はOSの仮想メモリとカーネルスレッドテーブルの制限(通常、パフォーマンスが大幅に低下する前に1,000~2,000スレッド)によって制約されます。
こちらもおすすめ
Free In-Browser Developer Tools
Clean AI CLI logs, build cron expressions, decode JWTs, and calculate chmod permissions offline.
Related Articles

本番環境のSQLite: WALモード、高並行性、そして実践的なPRAGMA設定
高スループットな本番環境でSQLiteをマスターしましょう。先行書き込みログ(WAL)、busy_timeoutのチューニング、読み書きの同時実行性、そして実用的なベンチマークについて解説します。
Read more
PythonFastAPIを高並行処理向けに最適化する
Uvicorn、Gunicornワーカー、asyncパターン、データベースコネクションプーリングを網羅し、高並行処理環境におけるFastAPIアプリケーションのパフォーマンスを最大化するための詳細な解説。
Read more
PythonコードベースをフリースレッドCPython 3.13へ移行する
C拡張機能を監査し、GILの前提を排除して、マルチスレッドPythonワークロードをフリースレッドCPython 3.13以降へ安全に移行し、真の並列処理を実現しましょう。
Read more