PythonFastAPIを高並行処理向けに最適化する

Table of Contents
FastAPIは、PythonのWeb開発エコシステムに旋風を巻き起こしました。優れた開発者体験、自動的なSwagger UI生成、Pydanticによる堅牢なデータ検証により、現代のPython APIの選択肢としてますます選ばれるフレームワークとなっています。しかし、その最も称賛される機能は、おそらくその速度でしょう。ベンチマークでは、FastAPIは利用可能な最速のPythonフレームワークの1つとして頻繁に位置づけられ、特定のシナリオではNodeJSやGoに匹敵します。
しかし、デフォルトのパフォーマンスは誤解を招く可能性があります。「Hello World」の単純なベンチマークは驚くほど高速に実行されますが、数千の同時ユーザー、大量のデータベースクエリ、外部API呼び出しといった高並行性ワークロードを扱う実際のアプリケーションでは、慎重な設定とアーキテクチャ上の事前検討が必要です。素朴なFastAPIアプリケーションを高並行性環境にデプロイすると、すぐにそのプレッシャーに耐えられなくなるかもしれません。
この詳細なガイドでは、高並行性環境向けにPython FastAPIを最適化するための重要な戦略を探ります。プロセス管理、Pythonのイベントループのニュアンス、データベース接続プーリング、高度なシリアル化技術について説明し、バックエンドが適切にスケールするようにします。
High-Performance Python Backend Series
1. 基本: ASGIとUvicorn
FastAPIを最適化する方法を理解するには、まずそれがどのように実行されるかを理解する必要があります。DjangoやFlaskのような従来のPython Webフレームワークは、本質的に同期的なWSGI(Web Server Gateway Interface)に基づいて構築されていました。一方、FastAPIはASGI(Asynchronous Server Gateway Interface)に基づいて構築されています。
ASGIはリクエストの非同期処理を可能にします。つまり、単一のサーバープロセスが、遅いI/O操作(ネットワークリクエストやデータベース読み取りなど)の完了を待つことなく、複数のリクエストを同時に処理できます。
FastAPIに推奨される標準のASGIサーバーはUvicornです。Uvicornはuvloop(Cythonで書かれた標準のasyncioイベントループのドロップイン代替)とhttptoolsの上に構築されています。この組み合わせがUvicornにその生の速度を与えています。
通常、開発中にFastAPIアプリを実行するには、次のようにします。
uvicorn main:app --reload
Uvicornは非常に高速ですが、本番環境でこのように実行すると、大きなボトルネックが生じます。それは、単一のUvicornプロセスはシングルスレッドであるということです。PythonのGlobal Interpreter Lock(GIL)のため、単一のUvicornプロセスは単一のCPUコアしか利用できません。16コアまたは32コアを搭載した最新のサーバーでは、単一のUvicornインスタンスを実行すると、サーバーの計算能力の大部分が完全にアイドル状態になります。
2. コアをまたぐスケーリング: GunicornとUvicornワーカー
マルチコアマシンの全能力を活用するには、複数のUvicornインスタンスを同時に生成および管理できるプロセスマネージャーが必要です。これにより、並行性(複数の操作を同時に管理すること)を補完する真の並列処理(複数の操作を同時に実行すること)が可能になります。
Python Webアプリケーションの業界標準プロセスマネージャーはGunicornです。Gunicornは歴史的にWSGIサーバーですが、Uvicornをワーカークラスとして使用するように設定でき、ASGIアプリケーションにプロセス管理をもたらします。
高並行性向けにFastAPIをデプロイするには、GunicornをUvicornワーカーとともに実行する必要があります。
gunicorn -w 4 -k uvicorn.workers.UvicornWorker main:app
ワーカー数の決定
いくつのワーカーを設定すべきでしょうか?WSGIアプリケーションに対するGunicornの古典的な推奨事項は(2 * number_of_cpu_cores) + 1です。しかし、ASGIアプリケーションは非同期であり、I/Oを待つ間にスレッドをブロックしないため、それほど多くのワーカーは必要ないかもしれません。
FastAPIの適切な出発点は、CPUコアあたり1つのワーカーであり、さらに1つか2つ追加するかもしれません。たとえば、8コアのマシンでは、-w 8から始めるかもしれません。正確な数は、特定のワークロード(CPUバウンドかI/Oバウンドか)に大きく依存します。アプリケーションが重い計算タスクを実行する場合、コンテキストスイッチングのオーバーヘッドを防ぐために、ワーカー数を減らす方が良いかもしれません。インフラストラクチャに最適な点を見つけるために、常にロードテストを行ってください。
3. Async/Awaitのジレンマ: async def vs def
これはおそらく、このガイドで最も重要なセクションです。FastAPIがasync defと標準のdefをどのように処理するかを誤解することは、本番環境での壊滅的なパフォーマンス障害の最も一般的な原因です。
async defを使用してルートを定義すると、FastAPIはそれをメインの非同期イベントループで直接実行します。これは、非ブロッキング操作(非同期データベースクエリや非同期HTTPリクエスト(例: httpxを使用)など)に最適です。
# GOOD: Using an async HTTP client inside async def
@app.get("/data")
async def get_data():
    async with httpx.AsyncClient() as client:
        response = await client.get("https://api.example.com")
        return response.json()
しかし、同期的なブロッキング操作をasync defルート内に配置すると、イベントループ全体がブロックされます。その同期操作が実行されている間、サーバーは他のリクエストを受け入れたり処理したりできません。並行性はゼロになります。
import time

# TERRIBLE: Blocking the event loop
@app.get("/slow")
async def slow_operation():
    time.sleep(5)  # The entire server stops for 5 seconds
    return {"status": "done"}
標準のrequests、標準のSQLAlchemy(非同期拡張なし)、または重いCPUバウンドの画像処理タスクのような同期ライブラリを使用する必要がある場合はどうでしょうか?
FastAPIはエレガントな解決策を提供します。async defの代わりに標準のdefを使用します。標準のdefを使用すると、FastAPIはその関数を外部のスレッドプールで実行するのに十分賢いです。これにより、メインのイベントループはブロックされず、応答性が保たれ、他のリクエストを同時に処理できます。
# GOOD: FastAPI runs this in a threadpool, protecting the event loop
@app.get("/sync-slow")
def slow_sync_operation():
    time.sleep(5)
    return {"status": "done"}
経験則:
async defは、関数内のすべての操作がawait可能で非ブロッキングである場合にのみ使用します。- 同期データベースドライバー、同期APIクライアントを使用している場合、または重いCPUバウンドタスクを実行している場合は、
defを使用します。
4. データベース接続プーリング
高並行性環境では、アプリケーションは1秒間に数百または数千回データベースと通信しようとします。データベースへの新しいTCP接続を開くことは、遅く、コストのかかる操作です。さらに、PostgreSQLのようなデータベースには、同時接続の最大数に厳密な制限があります(max_connections)。
FastAPIアプリケーションが大量の負荷の下でリクエストごとに新しい接続を起動すると、すぐにデータベース接続が枯渇し、システムがクラッシュします。
解決策は接続プーリングです。接続プールは、アクティブなデータベース接続のセットをメモリ内に維持します。リクエストがデータベースをクエリする必要がある場合、プールから接続を借り、クエリを実行し、その接続をプールに戻して次のリクエストで再利用できるようにします。
SQLAlchemy Asyncによるプーリングの実装
SQLAlchemy 2.0とその非同期拡張機能を使用している場合、接続プーリングは組み込まれています。エンジンを作成するときにプールを設定します。
from sqlalchemy.ext.asyncio import create_async_engine

DATABASE_URL = "postgresql+asyncpg://user:password@localhost/dbname"

engine = create_async_engine(
    DATABASE_URL,
    pool_size=20,          # The number of persistent connections to keep open
    max_overflow=10,       # How many additional connections to allow during spikes
    pool_timeout=30,       # How long to wait for a connection before failing
    pool_recycle=1800      # Recycle connections after 30 minutes to prevent staleness
)
真のエンタープライズ規模では、特に複数のサーバーで複数のGunicornワーカーを実行している場合(各ワーカーが独自のプールを維持するため)、アプリケーションレベルのプーリングだけに頼るだけでは不十分です。このようなシナリオでは、PgBouncerのようなインフラストラクチャレベルの接続プーラーを実装する必要があります。PgBouncerはFastAPIアプリケーションとPostgreSQLの間に位置し、数千のアプリケーション接続を少数の実際のデータベース接続に多重化します。
5. スループットの最大化: JSONシリアル化とバックグラウンドタスク
プロセス管理とI/Oのボトルネックが解消されたら、アプリケーションレベルの最適化でさらにパフォーマンスを向上させることができます。
より高速なJSONシリアル化
デフォルトでは、FastAPIはシリアル化にPythonの標準jsonライブラリを使用します。信頼性はありますが、最速ではありません。大量のJSONペイロードを返す高スループットAPIでは、シリアル化が重大なCPUボトルネックになる可能性があります。
FastAPIはカスタムレスポンスクラスをサポートしています。デフォルトのJSONレスポンスをORJSONResponseに置き換えることができます。これは、信じられないほど高速なRustベースのJSONライブラリであるorjsonを使用します。
from fastapi import FastAPI
from fastapi.responses import ORJSONResponse

app = FastAPI(default_response_class=ORJSONResponse)

@app.get("/fast-json")
async def get_fast_json():
    return {"message": "This is serialized at the speed of light"}
pip install orjsonことを忘れないでください。
バックグラウンドタスクによる作業のオフロード
非同期でバックグラウンドで実行できる操作のために、ユーザーを待たせるべきではありません。ウェルカムメールの送信、アップロードされたファイルの処理、Webhookのpingは、HTTPレスポンスをブロックすべきではありません。
単純なタスクには、FastAPIの組み込みのBackgroundTasksを使用します。これは、HTTPレスポンスがクライアントに送信された後にその関数を実行します。
from fastapi import BackgroundTasks

def send_email_notification(email: str):
    # Simulated email sending
    pass

@app.post("/register")
async def register_user(email: str, background_tasks: BackgroundTasks):
    # Register user in DB...
    background_tasks.add_task(send_email_notification, email)
    return {"message": "User registered successfully"}
重い分散ワークロードには、RedisをバックエンドとするCeleryやRQのような専用のメッセージキューとタスクランナーを統合します。
結論
FastAPIは、バックエンドパフォーマンス競争において大きなリードを提供する素晴らしいツールです。しかし、高並行性はアーキテクチャ上の欠陥を容赦なく露呈させます。
Gunicornワーカーを使用してFastAPIを複数のコアにスケーリングし、Pythonのイベントループのルール(async defとdefを正しく組み合わせる)を厳密に遵守し、堅牢なデータベース接続プーリングを実装し、シリアル化を最適化することで、数百万のリクエストを容易に処理できるバックエンドシステムを構築できます。デフォルトで高速であることは良いことですが、設計によって高速であることはさらに良いことです。
FastAPIスタックを調整し、異なるフレームワークアーキテクチャがより高いスループットまたはワーカーあたりのメモリ削減をもたらすかどうかを評価している場合は、当社のFastAPI vs Litestar (2026) ベンチマーク比較をご覧ください。
こちらもおすすめ
Free In-Browser Developer Tools
Clean AI CLI logs, build cron expressions, decode JWTs, and calculate chmod permissions offline.
Related Articles

本番環境のSQLite: WALモード、高並行性、そして実践的なPRAGMA設定
高スループットな本番環境でSQLiteをマスターしましょう。先行書き込みログ(WAL)、busy_timeoutのチューニング、読み書きの同時実行性、そして実用的なベンチマークについて解説します。
Read more
高度なPythonデータ構造:リストと辞書を万能薬にするのをやめよう
Pythonの高性能データ構造であるcollections.deque、Counter、defaultdict、heapq、slots dataclassesを使いこなし、10倍高速なコードを実現するための実践的なガイド。
Read more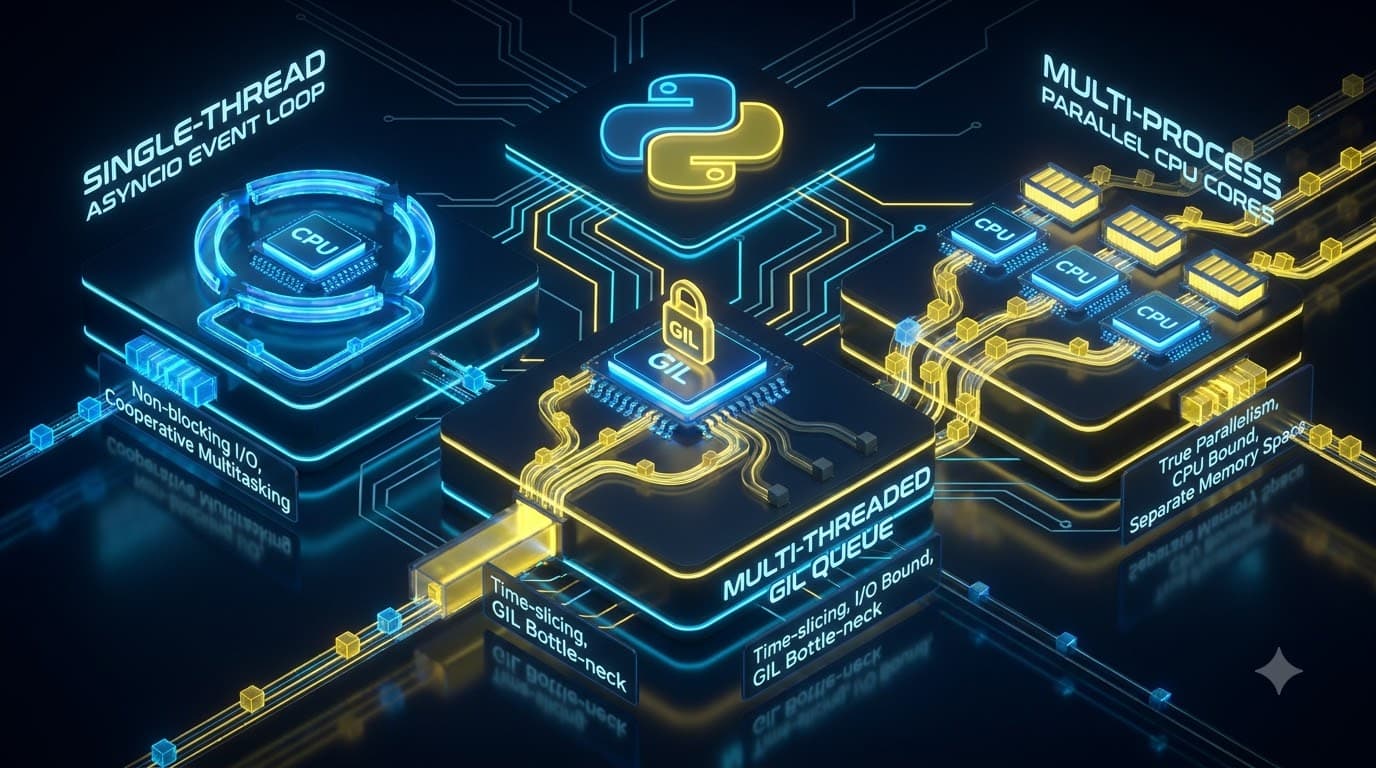
2026年のPython並行処理:AsyncIO、スレッド、プロセス
CPUコードが4スレッドで50%遅くなる理由、AsyncIOイベントループ、GIL回避策、マルチプロセシングのベンチマークをアーキテクチャ決定木と比較して解説します。
Read more