AI時代の新たなリスク考察

Table of Contents
私はキャリアのほとんどを、ルール、しきい値、レビューキューといった昔ながらの方法で不正検知システムを構築することに費やしてきました。ルールを作成し、誤検知が山積するのを見て、調整し、それを繰り返す。そして3ヶ月後、データチームの誰かが私が見落としていたパターンを発見する、という具合でした。
AIはそれを完全に覆します。魔法だからではなく、トランザクションストリームの内部に存在し、私がこれまで保守してきたどのルールセットよりも速く適応できるからです。
AIが実際に変えるもの
根本的な変化は、リアクティブな検知からほぼリアルタイムの検知への移行です。ルールでは、すでに見つけてルールを作成したものしか捕捉できません。トランザクションパターンでトレーニングされたモデルは、既存のどのルールにも一致しない異常をフラグ付けできます。例えば、新しい場所の新しいデバイスからの購入で、それ以外はユーザーの支出プロファイルに合致している場合などです。
しかし、私が予期しなかった落とし穴があります。それは、モデルはルールよりも速くドリフトするということです。ルールは一致するかしないかのどちらかです。モデルの信頼度しきい値は、データ分布が変化するにつれて変動します。デプロイ時には優れたパフォーマンスを発揮していたモデルが、不正パターンが進化するにつれて3ヶ月以内に著しく劣化するのを経験しました。
メンテナンスの現実
新しいパターンを発見したときにルールセットを更新する必要があります。モデルは常に監視する必要があります。精度、再現率、誤検知率、データドリフトなどです。メンテナンスの負担は異なりますが、低くなるわけではありません。
ルールが依然として優位な点
すべての不正シナリオがMLの恩恵を受けるわけではありません。単純な速度チェック(「このカードから10分以内に5回以上のトランザクション」)は、ルールとしての方が高速で信頼性があります。モデルは新しいパターンを捕捉できるかもしれませんが、3行のif文で完璧に処理できるケースに対して、レイテンシと複雑さを導入することにもなります。
私が使う基準はこうです。不正パターンを1文で説明できるなら、ルールを作成する。パターンが「見ればわかる」というものなら、モデルをトレーニングする。
モデルを本番環境にデプロイする
最も困難な教訓は、モデルを構築することではなく、それをサービスとして提供することでした。リアルタイムの不正検知には、100ミリ秒未満での推論が必要です。そのためには、以下のことが必要でした。
- トランザクション時に実行される特徴量エンジニアリングであり、バッチ処理ではないこと。「このユーザーの過去24時間の平均トランザクション額」の計算は、日次ジョブからではなく、瞬時に行われる必要があります。
- 肥大化しないモデルのシリアル化。200MBの依存関係を持つPickleファイルは、決済パイプラインには不向きです。
- フォールバック戦略。モデルサーバーがダウンした場合(そしてそれは必ずダウンします)、ルールセットは引き続き実行される必要があります。私は、フォールバックなしで美しいMLパイプラインを構築したチームを見てきましたが、最初の障害で彼らのリスクシステム全体がオフラインになりました。
フォールバックはオプションではない
私が本番環境で見てきたMLベースのリスクシステムはすべて、その下に劣化モードのルールセットを持っています。最初の障害の後ではなく、初日からそのフォールバックを設計してください。
今から始める人に私が伝えたいこと
明白なパターンにはルールから始めましょう。ルールでは捕捉できないエッジケースにはMLを追加します。モデルのパフォーマンスを常に監視してください。精度だけでなく、ビジネスへの影響(どれだけの正当なトランザクションをブロックしているか?)もです。そして常に、常にフォールバックを用意してください。
私が見てきた最高のリスクトシステムは、純粋なMLでも純粋なルールでもありません。それぞれがお互いの盲点をカバーするハイブリッドです。
こちらもおすすめ
- ウォレットとAIエージェントで決済フローを構築して学んだこと
- LangChain vs LlamaIndex: 本番RAGパイプラインガイド
- JAXによる深層学習
- JAXとTPUによる深層学習の最適化
詳細解説:コアメカニクス
表面の下を見ると、基盤となるメカニクスはシステムの複雑な相互作用を明らかにします。現代の開発において、これらのメカニクスを理解することが、初心者とエキスパートを分けるものです。
この実用的な例を考えてみましょう。
// A comprehensive example demonstrating advanced patterns
class ServiceManager {
  constructor() {
    this.services = new Map();
    this.initialized = false;
  }

  register(name, service) {
    if (this.services.has(name)) {
      throw new Error(`Service ${name} already registered`);
    }
    this.services.set(name, service);
  }

  async initializeAll() {
    this.initialized = true;
    for (const [name, service] of this.services) {
      if (typeof service.init === 'function') {
        await service.init();
      }
    }
  }

  get(name) {
    if (!this.initialized) {
      console.warn('Accessing services before initialization');
    }
    return this.services.get(name);
  }
}
このパターンにより、ビジネス要件が変化しても、アーキテクチャはスケーラブルで堅牢な状態を保つことができます。これは、大規模なアプリケーションで大きな利益をもたらす基本的なアプローチです。
実世界での応用とスケーリング
これを本番環境で実装すると、新たな課題が生じます。並行処理、状態管理、メモリリークを考慮する必要があります。
例えば、高スループットシステムを扱う場合、あらゆるマイクロ最適化が重要になります。ローカル開発では明らかにならないボトルネックを特定するために、プロファイリングツールに頼ることがよくあります。
上記の図は、アプリケーションが水平にスケールする典型的なデプロイ戦略を示しています。
理解度チェック
よくある質問
この追加のコンテキストは、上記で議論されたトピックに関するより多くの背景情報を提供し、実際のシナリオに含まれるニュアンスを包括的に理解できるようにします。
Free In-Browser Developer Tools
Clean AI CLI logs, build cron expressions, decode JWTs, and calculate chmod permissions offline.
Related Articles

本番RAG向けVectorDatabase (2026): Pinecone vs Qdrant vs Milvus vs pgvector
本番RAGパイプライン向けにPinecone、Qdrant、Milvus、pgvectorのアーキテクチャを、HNSW vs IVFFlatインデックス、単段フィルタリング検索、p95レイテンシ、メモリフットプリントでベンチマークします。
Read more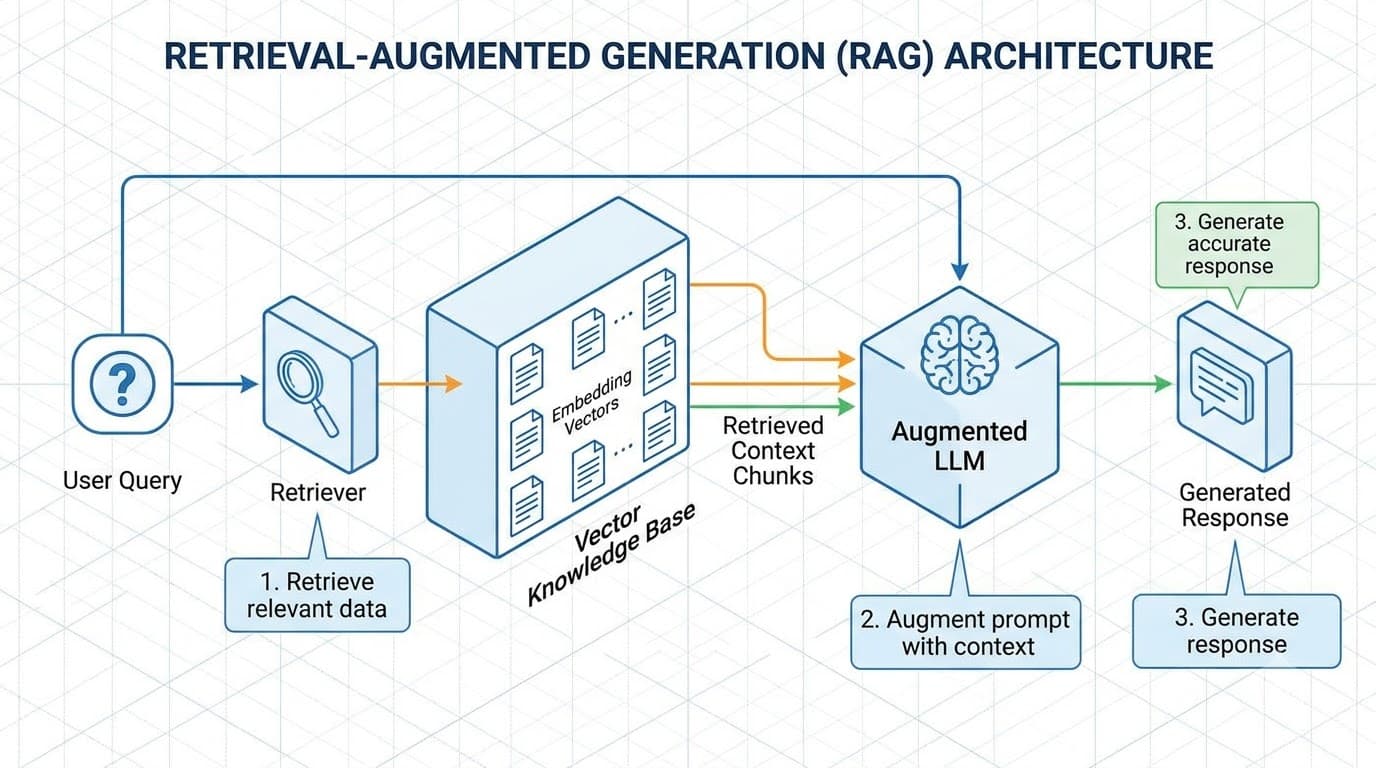
Retrieval-Augmented Generation (RAG)を理解する
Retrieval-Augmented Generation (RAG)のチャンキング戦略、ベクトル埋め込み、ハイブリッド密疎検索、リランキングパイプラインについて深く掘り下げます。
Read more
13日間のクラウドスプリント:期限切れGCPクレジットを永続的なメンテナンス費用ゼロのアセットに変える方法
期限切れのGoogleCloudクレジットから最大のROIを引き出すための実践ガイド。一時的なコンピューティングを、期限切れ後のコストゼロで永続的なSEOコンテンツ、ニューラルオーディオ、事前計算済みデータセットに変換する方法を学びましょう。
Read more