本番環境における非同期Pythonのメモリリークのプロファイリング

高並行性の非同期Pythonサービスを本番環境で実行した経験があれば、メモリチャートが徐々に上昇し、最終的にオーケストレータがOOM Killer(終了コード137)でPodを強制終了させるのを見たことがあるだろう。
Pythonのガベージコレクタは標準的な参照サイクルをクリーンアップするが、asyncioのイベントループはメモリを保持し続ける微妙な方法を導入してしまう。待機されていないタスク、コールバックが欠落したバックグラウンドフューチャー、そして閉じられていない非同期イテレータは、イベントループの内部状態にオブジェクトを静かにピン留めする。
クイック診断リファレンス:
| 症状 | 根本原因 | 診断ツール | 修正方法 |
|---|---|---|---|
| ループの早期終了後にRSSが上昇 | 宙ぶらりんのasync defジェネレータフレーム | tracemalloc.take_snapshot() | contextlib.aclosing()または明示的なawait gen.aclose() |
| 高負荷時にPodがOOMで強制終了 | asyncio.all_tasks()内に待機されていないタスク | asyncio.all_tasks(loop)のダンプ | asyncio.TaskGroupまたは強参照セットの破棄 |
| タスク終了後もメモリ使用量が高いまま | CPythonのpymallocによる断片化 | memray run --live | MALLOC_TRIM_THRESHOLD_の設定またはワーカーのリサイクル |
| 未処理の例外がRAMを消費 | タスクオブジェクトにピン留めされたトレースバックフレーム | sys.unraisablehookによるロギング | 明示的な例外取得またはタスクコールバック |
本番環境の並行処理とプロファイリングハンドブック
本番環境における並行処理、asyncioタスクグループ、スレッド対マルチプロセッシング、そしてメモリプロファイリングに関する完全なアーキテクチャガイドをお探しですか?Modern Pythonシリーズの包括的な高性能な並行処理とプロファイリングの章をお読みください。
根本原因:なぜasyncioは未回収のオブジェクトを保持するのか
Pythonのasyncioループがリークしたオブジェクトを蓄積する主な原因は、待機されていないタスク、非同期ジェネレータ内の循環参照、または閉じられていないイベントループのコールバックがヒープメモリ内に強参照を保持することである。
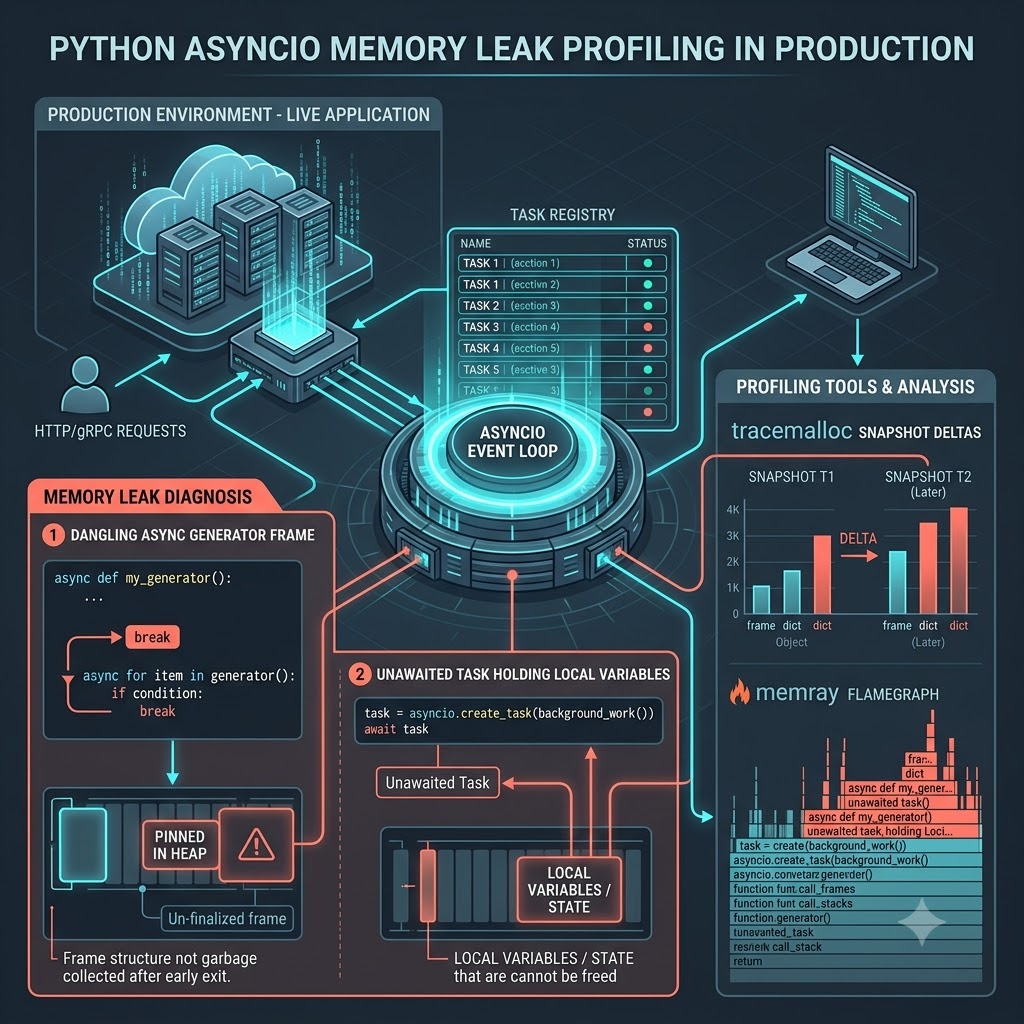
非同期タスクがアクティブなイベントループ内で実行を開始すると、スケジューラは内部の実行中セットに基盤となるタスクオブジェクトへの強参照を登録する。もしバックグラウンドワーカーがコルーチンを生成し、その結果を適切に収集または待機しない場合、それらのタスクは処理が完了した後もメモリ内に登録されたままになる。カスタム例外ハンドラや取得されなかった結果がローカルフレーム変数への参照を保持していると、イベントループは完了したタスクフレームをガベージコレクションできない。さらに、async defで作成された非同期ジェネレータは、呼び出し元のループによって明示的に閉じられるか、最後まで使い果たされるまで、内部のジェネレータフレーム参照を維持する。開発者が早期のループ終了時にこれらのジェネレータを適切に閉じないと、CPythonは実行フレーム全体を無期限にRAMにピン留めし続ける。
ストリーミングペイロードのチャンクを非同期ジェネレータループを介して処理する高スループットのAPIゲートウェイを考えてみよう。
import asyncio
import gc
from typing import AsyncGenerator

class PayloadBuffer:
    def __init__(self, data_chunk: bytes) -> None:
        self.data_chunk = data_chunk
        self.processed = False
        self.metadata: dict[str, str] = {"origin": "gateway_ingress", "status": "buffered"}

async def stream_payload_chunks(raw_stream: list[bytes]) -> AsyncGenerator[PayloadBuffer, None]:
    for chunk in raw_stream:
        buffer = PayloadBuffer(chunk)
        # 危険: コンシューマが早期にbreakすると、このジェネレータフレームはメモリ内に未回収のまま残る
        yield buffer
        buffer.processed = True

async def leaky_request_handler(payload_chunks: list[bytes]) -> None:
    gen = stream_payload_chunks(payload_chunks)
    async for item in gen:
        if item.data_chunk.startswith(b"ABORT"):
            # 早期のbreakは、ファイナライズされずにジェネレータフレームをメモリに宙ぶらりんのままにする
            print("Aborting stream processing immediately due to invalid chunk payload header")
            break
上記のスニペットでは、async forループから抜け出すと、ジェネレータインスタンスが実行途中で中断されたままになる。ジェネレータフレームはPayloadBufferオブジェクトやローカルのストリーム変数への参照を保持しているため、ガベージコレクションサイクルはそのメモリをループが終了するまで回収できない。検証エラーやクライアントの切断により何千ものリクエストが早期に中断されると、蓄積されたジェネレータフレームが数百メガバイトのプロセスRSSメモリを消費する。サービスが1時間あたり数万のリクエストを処理する場合、このメモリリークパターンは利用可能なシステムメモリを急速に消費するだろう。
この特定の保持ベクトルを防ぐために、本番サービスはすべての非同期ジェネレータがacloseやコンテキストマネージャを使用して明示的なファイナライズを実装することを保証しなければならない。さらに、開発者はバックグラウンドタスクを追跡せずに放置し、実行終了時に参照をクリーンアップするタスク完了コールバックをアタッチしないようにすべきである。回復力のあるサーバーアーキテクチャを構築する際、これらの参照ライフタイムのルールを理解することは、バックエンドエンジニアにとって任意ではない。
asyncioタスクの内部表現を理解することは、なぜ待機されていないフューチャーがイベントループのティックを越えて存続するのかを明らかにするのに役立つ。すべてのタスクインスタンスには、トレースバックフレーム、ローカル変数、contextvars構造、および例外の詳細を含む明示的な参照辞書が含まれている。誰も待機していないバックグラウンドタスク内でキャッチされない例外が発生すると、CPythonはタスクがガベージコレクションされるときにそれを表示するためにトレースバックオブジェクトを保持する。しかし、タスク自体がグローバルレジストリやアクティブなイベントループのコールバックテーブル内で参照され続けている場合、そのガベージコレクションパスは決して発生しない。結果として、タスクフレーム内で参照されている大きなペイロード構造は、無期限にメモリに捕捉されたままになる。
もう一つの頻繁なメモリ保持の原因は、ワーカープールアーキテクチャにおけるasyncio.Queueオブジェクトの不適切な使用に関係している。キューのプロデューサがコンシューマタスクが処理できるよりも速くアイテムをプッシュすると、管理されていないキューは巨大なサイズに膨れ上がる。コンシューマが最終的に追いついたとしても、Pythonの内部メモリアロケータは解放されたメモリをすぐにオペレーティングシステムホストに返さない。本番のメモリチャートを解釈する際には、Pythonの内部pymallocヒープアロケータとシステムレベルのメモリマネージャとの境界を理解することが不可欠である。
tracemallocで宙ぶらりんのジェネレータフレームを特定する
Tracemallocは、ヒープアロケーションのトレーススナップショットを取得し、ガベージコレクションサイクル間のメモリ差分を比較することで、未回収の非同期ジェネレータフレームを特定する。
標準のPython tracemallocモジュールは、アプリケーション実行の早い段階で初期化されると、Pythonヒープ上に割り当てられたすべてのオブジェクトのトレースバックをキャプチャする。アプリケーションのウォームアップ後にベースラインスナップショットを取得し、ストレスワークロード実行後に取得したスナップショットと比較することで、開発者はメモリブロックを蓄積している正確なソースコードの行番号を特定できる。非同期アプリケーションの場合、スナップショットを特定のモジュールファイル名でフィルタリングすることで、標準のイベントループのオーバーヘッドからリーク候補を分離する。行ごとのメモリアロケーションの差分を分析することで、エンジニアは一時的なメモリスパイクと永続的なメモリリークを区別できる。
以下は、非同期実行サイクルにわたるアロケーションの増加を追跡する、完全な本番プロファイリングユーティリティである。
import asyncio
import tracemalloc
import linecache
import gc
from typing import Any

class AsyncMemoryProfiler:
    def __init__(self, top_n: int = 10) -> None:
        self.top_n = top_n
        self.snapshot_before: tracemalloc.Snapshot | None = None

    def start(self) -> None:
        tracemalloc.start(25)
        self.snapshot_before = tracemalloc.take_snapshot()

    def compare_with_baseline(self) -> list[str]:
        if self.snapshot_before is None:
            raise RuntimeError("Profiler wasn't started prior to baseline comparison execution")

        # 現在のスナップショットを取得する前にガベージコレクションを強制実行
        gc.collect()
        snapshot_after = tracemalloc.take_snapshot()
        stats = snapshot_after.compare_to(self.snapshot_before, "lineno")

        report_lines: list[str] = []
        for stat in stats[:self.top_n]:
            frame = stat.traceback[0]
            filename = frame.filename
            line_number = frame.lineno
            line_text = linecache.getline(filename, line_number).strip()
            size_kb = stat.size_diff / 1024
            count_diff = stat.count_diff
            report_lines.append(
                f"File: {filename}:{line_number} | Diff: {size_kb:+.2f} KB | Objects: {count_diff:+} | Code: {line_text}"
            )
        return report_lines
このプロファイラを負荷テストのイテレーション中に実行すると、トラフィック下で単調に増加するアロケーションソースが明らかになる。
async def run_profiling_suite() -> None:
    profiler = AsyncMemoryProfiler(top_n=5)
    profiler.start()

    # ワーカーーループ内で5000の同時ストリーミングリクエストを処理するシミュレーション
    for iteration in range(5000):
        fake_chunks = [b"HEADER_START", b"DATA_CHUNK_001", b"ABORT_SIGNAL_TRIGGER"]
        await leaky_request_handler(fake_chunks)

    results = profiler.compare_with_baseline()
    print("\n--- メモリアロケーション差分レポートサマリー ---")
    for entry in results:
        print(entry)
tracemallocのレポートを分析すると、ジェネレータオブジェクト、辞書フレーム、文字列アロケーションがリクエスト間で持続する正確なアロケーションポイントが明らかになる。tracemallocがジェネレータのインスタンス化行でアロケーション数が着実に増加していることを示した場合、開発者は重い外部デバッガをアタッチすることなく、閉じられていないジェネレータのリークを即座に確認できる。継続的インテグレーションスイート内に自動化されたtracemallocアサーションを組み込むことで、メモリリークのリグレッションがステージング環境に到達するのを防ぐことができる。
しかし、tracemallocはPythonの標準メモリアロケータ(PyMem_MallocおよびPyObject_Malloc)を介して行われたアロケーションのみを記録する。アプリケーションがPythonアロケータをバイパスするC拡張やネイティブコンパイルされたライブラリを利用している場合、tracemallocはそれらのアロケーションを完全に見逃す。完全なプロファイリングワークフローを構築するには、高性能なネイティブ拡張を扱う際にtracemallocとネイティブシステムアロケータを組み合わせる必要がある。
tracemallocの出力を検査する際は、トレースバックの深さの設定に注意を払うこと。デフォルトでは、tracemallocはパフォーマンスのオーバーヘッドを最小限に抑えるために、アロケーションごとに1つのスタックフレームしか記録しない。フレームの深さを25フレームに増やすことで、エンジニアは非同期のyieldポイントを越えて、オブジェクトのインスタンス化をハイレベルなアプリケーションハンドラまで遡って追跡できる。より深いトレースバックのキャプチャはプロファイリングのメモリ使用量をわずかに増加させるが、複雑な非同期コールチェーンをデバッグする際に重要なコンテキストの可視性を提供する。
複雑なイベント駆動型マイクロサービスでは、ドメイン固有のファイルパターンでスナップショットの差分をフィルタリングすることで、サードパーティのフレームワークのアロケーションからアプリケーションのバグを分離するのに役立つ。標準ライブラリのフレームやWebフレームワークの内部ループを無視することで、エンジニアはリークが発生するカスタムビジネスロジックに直接集中できる。ドメインフィルタと行番号でグループ化された統計的集計を組み合わせることで、明確で実行可能なデバッグサマリーが得られる。
MemrayでネイティブC拡張とヒープの肥大化をプロファイリングする
Memrayは、CレベルのメモリアロケーションをPythonのスタックフレームと並行してプロファイリングすることで、ネイティブC拡張の非同期メモリ肥大化を追跡し、管理されていないCバッファを浮き彫りにする。
numpy、pyarrow、grpcなどのネイティブライブラリやカスタムC拡張は、システムのmallocやカスタムC++アロケータを通じて直接メモリを割り当てる。非同期ワーカーが基盤となるポインタを明示的に解放せずにデータバッファをC拡張に渡すと、tracemallocが安定したPythonヒープ使用量を報告しているにもかかわらず、プロセスのメモリは急速に増加する。Memrayは、Pythonインタープリタの内部と低レベルのメモリアロケーションシンボルの両方にフックし、CとPythonの境界を越えたメモリ分布の統一されたフレームグラフを構築する。この機能により、Memrayは非同期データベースドライバや機械学習推論サーバーをデバッグする際に非常に貴重なツールとなる。
本番環境やステージング環境でMemrayを使って非同期サーバープロセスをプロファイリングするには、Memray CLIラッパーを使用してアプリケーションを起動する。
# 非同期サービスをMemrayプロファイリングラッパーの下でライブモニタリング付きで実行
memray run --live --output async_profile.bin -m uvicorn app.main:app --port 8000 --workers 1
ライブプロファイリングモードは即座にコンソールフィードバックを提供するが、インタラクティブなHTMLレポートを生成することで、時間間隔にわたるコールスタックの詳細な調査が可能になる。
# バイナリキャプチャデータセットからインタラクティブなフレームグラフを生成
memray flamegraph async_profile.bin -o memray_flamegraph.html

# アロケーションサイズのしきい値でフィルタリングされたテーブルレポートを生成
memray table async_profile.bin -o memray_table.html
非同期アプリケーションのMemray出力をレビューする際は、ワーカースレッドやC拡張コールバック内で行われるアロケーションに特に注意を払うこと。次の表は、非同期デバッグワークフローにおけるtracemallocとMemrayの主な運用上の違いをまとめたものである。
| 機能の次元 | Python Tracemalloc | Memray C Profiler |
|---|---|---|
| プロファイリングのオーバーヘッド | 低(実行速度の低下は5%~15%) | 中程度(実行速度の低下は15%~35%) |
| C拡張の追跡 | 非対応(Pythonヒープアロケーションのみ) | 完全対応(ネイティブのmallocとcallocを追跡) |
| 出力の可視化 | コンソールテキストサマリーと統計リスト | インタラクティブなHTMLフレームグラフと3Dマップ |
| 本番環境への適合性 | ライブのステージング環境で非常に安全 | 負荷テストやステージングパスに最適 |
| スタックフレームの深さ | 設定可能な行番号トレースの深さ | CとPythonの完全な統一コールスタックの深さ |
tracemallocと並行してMemrayを使用することで、チームは高レベルのPythonオブジェクト保持と低レベルのCバッファリークの両方にわたる完全な可視性を得ることができる。チームが両方のツールを組み合わせると、ソフトウェアスタック全体にわたるあらゆるメモリ保持の異常を特定できる包括的な診断フレームワークが作成される。
Memrayのネイティブアロケーション追跡は、標準のPythonツールが完全に見逃す高性能なCライブラリの微妙なバグを明らかにする。例えば、非同期エンドポイント内でpyarrowを使用してストリーミングIPCレコードを処理する際、閉じられていないレコードバッチリーダーは、sys.getsizeof()呼び出し内に決して登録されないネイティブC++メモリバッファを割り当てる。Memrayはこれらのネイティブメモリブロックをフレームグラフ上で直接ハイライトし、開発者に欠落しているC++デストラクタ呼び出しや解放されていないArrowテーブルハンドルを直接指し示す。
さらに、Memrayにはマルチスレッドおよびマルチプロセスの非同期アプリケーション向けに特化した追跡モードが含まれている。UvicornやGunicornのようなWebサーバーを複数のワーカープロセスで実行する場合、Memrayはすべてのワーカーインスタンスにわたるアロケーションを同時にキャプチャできる。集計されたワーカーレポートを分析することで、特定の負荷分散構成やマルチプロセス競合条件の下でしか現れないメモリリークの状況を防ぐことができる。
リークのない非同期ジェネレータとバックグラウンドタスクのパターン
リークのない非同期ジェネレータは、リソースの初期化をtry-finallyブロック内にラップし、閉じられていないイテレータをaclose呼び出しで明示的にファイナライズすることで構築すべきである。
非同期ジェネレータのライフサイクルを管理する最も安全なメカニズムは、contextlib.aclosingを使用するか、カスタムの非同期コンテキストマネージャを構築することである。aclosingヘルパーは、コンシューマがasync forループから早期に抜けた場合でも、コンテキストの終了時にジェネレータのaclose()メソッドが即座に呼び出されることを保証する。これにより、ジェネレータフレーム内のすべてのfinallyブロックの実行がトリガーされ、保持されていた参照が解放され、ネットワークソケットが適切に閉じられる。このパターンをすべてのストリーミングエンドポイントに実装することで、予期せぬクライアントの切断がメモリ内にジェネレータオブジェクトを放置しないようにできる。
以下は、先ほどのストリーミングペイロードプロセッサをリファクタリングした、リークのないバージョンである。
import asyncio
from contextlib import aclosing
from typing import AsyncIterator

async def resilient_stream_processor(raw_chunks: list[bytes]) -> AsyncIterator[bytes]:
    # try-finallyブロック内で明示的なクリーンアップを保証する、回復力のある非同期ジェネレータ
    try:
        for chunk in raw_chunks:
            # クリーンアップの安全性を保証しつつ、呼び出し元に制御をyieldする
            yield chunk
    finally:
        # このブロックは、呼び出し元によってgenerator.aclose()が呼ばれると確実に実行される
        print("Cleaning up stream processing generator frame resources cleanly")

async def safe_request_handler(payload_chunks: list[bytes]) -> None:
    # 非同期イテレータをaclosingコンテキストマネージャラッパーでラップする
    async with aclosing(resilient_stream_processor(payload_chunks)) as stream:

        async for chunk in stream:
            if chunk.startswith(b"ABORT"):
                print("Safely exiting stream processing via context manager finalization")
                break
aclosingの使用に加えて、バックグラウンドのasyncioタスクを実行するサービスは、タスク管理レジストリを使用してアクティブなフューチャーを追跡すべきである。バックグラウンドタスクが終了すると、レジストリは完了コールバックを使用してタスク参照を削除する。
class TaskRegistry:
    def __init__(self) -> None:
        self._active_tasks: set[asyncio.Task[Any]] = set()

    def spawn_tracked_task(self, coroutine: Any) -> asyncio.Task[Any]:
        task = asyncio.create_task(coroutine)
        self._active_tasks.add(task)
        # 完了コールバックのトリガー時にタスク参照を自動的に破棄する
        task.add_done_callback(self._active_tasks.discard)
        return task

    async def shutdown(self) -> None:
        if self._active_tasks:
            print(f"Cancelling pending background tasks count: {len(self._active_tasks)}")
            for task in self._active_tasks:
                task.cancel()
            await asyncio.gather(*self._active_tasks, return_exceptions=True)
構造化されたタスク管理とコンテキスト管理された非同期ジェネレータを採用することで、本番のasyncioマイクロサービスにおけるメモリ保持バグの大部分を排除できる。エンジニアリングチーム全体でこれらのアーキテクチャパターンを確立したソフトウェアエンジニアは、深刻なトラフィックスパイク下でも一貫して低いプロセスRSSフットプリントを維持する。
これらのサービスにASGIフレームワークを選択する際、フレームワークのアーキテクチャはワーカーあたりのベースラインメモリに大きく影響する。ワーカーあたりのメモリフットプリントとスループットについては、FastAPI対Litestarのベンチマーク比較を参照のこと。コンテナ環境にデプロイする際は、AstralのuvをマルチステージDockerビルドで使用して、ベースイメージを軽量に保つこと。
大容量マイクロサービスの長期的な安定性を確保するために、ソフトウェアチームは継続的インテグレーションパイプラインに自動メモリプロファイリングを統合しなければならない。ステージング環境に対してtracemallocを有効にして負荷テストを実行することで、開発者はアロケーションのリグレッションが本番サーバーに到達する前にキャッチできる。さらに、Kubernetesのようなコンテナオーケストレーションプラットフォーム内で厳格なRSSメモリ制限を設定することで、予期せぬメモリ蓄積がマイクロサービスクラスタ全体にわたる連鎖的なノード障害ではなく、制御されたPodの再起動をトリガーすることが保証される。
メモリトラブルシューティングのための明確な運用手順書(runbook)を確立することで、メモリアラートが発生した際にエンジニアリングチームが効果的に対応できるようになる。アラートが本番コンテナでのメモリ使用量の増加を示した場合、エンジニアはサービスインスタンスを再起動する前に、組み込みの診断エンドポイントを使用して直ちにヒープスナップショットをキャプチャすべきである。ライブの本番ノードから直接取得したヒープスナップショットを検査することで、どのデータ構造がメモリ拡張を引き起こしたかについて、議論の余地のない証拠が得られる。
最後に、内部キューの深さと並行性セマフォに上限を設けるように非同期データパイプラインを設計すること。境界のないキューとスロットルされていないワーカータスクは、負荷スパイク下での予期せぬメモリ拡張の主要な運用上の原因であり続ける。境界付きキューを明示的なタスクレジストリおよびコンテキスト管理された非同期ジェネレータと組み合わせることで、メモリの劣化なしに無期限に実行可能な、回復力のあるPythonアプリケーションを構築できる。
こちらもご覧ください
- 高並行性のためのPython FastAPIの最適化
- FastAPI vs Litestar (2026): パフォーマンス、ベンチマーク、そして乗り換えるべき時
- FastAPI vs Celery: BackgroundTasksと分散タスクキューの使い分け
- 面倒なClickタスクの実用的なリスト - そしてPythonでそれらを自動化する方法
技術リファレンスとトラブルシューティング
タスク完了後のプロセスRSSの保持
Pythonは、小さなオブジェクトのアロケーションを効率的に処理するために、pymallocによって管理されるカスタムの内部メモリプールを使用する。asyncioループ内でオブジェクトがガベージコレクションされると、pymallocはメモリをOSカーネルにページを返すのではなく、内部のPythonプールに解放する。その結果、Pythonの内部ヒープが将来のアロケーションのためにスペースを再利用しているにもかかわらず、topやpsのようなシステムツールは高いRSSメモリ使用量を報告する。
未処理の例外によるピン留めされたトレースバックフレーム
バックグラウンドタスクが未処理の例外を発生させ、待機されないままでいると、例外オブジェクトはその実行トレースバックフレームへの参照を保持する。このトレースバックフレームは、エラーが発生したときに存在したすべてのローカル変数、引数、および中間オブジェクトへの参照を保持する。別のコンポーネントがタスクを待機するか例外を抽出しない限り、それらのオブジェクトは無期限にメモリにピン留めされたままになる。
非同期キャッシュのためのWeakrefパターン
weakref.WeakValueDictionaryやweakref.WeakKeyDictionaryを使用することで、インメモリキャッシュの実装がオブジェクトを無期限にピン留めするのを防ぐことができる。キャッシュされたオブジェクトがアプリケーションの他の場所で強参照を持たなくなると、ガベージコレクションはそれらを弱参照辞書から自動的に削除し、手動でのキャッシュ削除バグを回避する。
ワーカープールにおける境界のないキューの保持
閉じられていないasyncioキューは、内部のdeque構造内にバッファリングされたすべてのアイテムペイロードへの強参照を保持する。ワーカースレッドがクラッシュしたり、キューを空にせずに終了したりすると、残りのアイテムペイロードと関連するコンテキスト変数は、キューオブジェクト自体がガベージコレクションされるまでメモリに残り続ける。
明示的なガベージコレクション vs pymallocのリサイクル
gc.collect()の明示的な呼び出しは、完全なガベージコレクションがイベントループの実行を一時停止させるため、本番のホットパスでは一般的に避けるべきである。しかし、専用のバックグラウンドメンテナンスループ内で定期的にgc.collect()を呼び出すか、大規模なバッチジョブを完了した直後に呼び出すことは、ヒープの断片化が発生する前に循環参照をクリーンアップするのに役立つ。
プロセスRSS vs ヒープメモリアロケーション
Resident Set Size (RSS)は、Cライブラリやネイティブバッファを含む、OSカーネルによってプロセスに割り当てられた合計物理RAMを測定する。tracemallocのようなツールで測定されるヒープメモリは、CPythonランタイムアロケータによって直接管理されるPythonオブジェクトのみを追跡する。
知識を確認する(インタラクティブクイズ)
本番環境で高並行なasync Pythonサービスが負荷時にOOM kills (終了コード137) を経験しています。初期調査の結果、`asyncio.all_tasks(loop)` が未awaitのタスクの増加を示しています。この特定のメモリリークを本番環境で軽減するための最も効果的な戦略は次のうちどれですか?
ブラウザで動く無料の開発者ツール
AI CLIログの整形、Cron式の作成、JWTの解析、chmod権限の計算をオフラインで実行。
関連記事
2026年のPython並行処理:AsyncIO、スレッド、プロセス
CPUコードが4スレッドで50%遅くなる理由、AsyncIOイベントループ、GIL回避策、マルチプロセシングのベンチマークをアーキテクチャ決定木と比較して解説します。
続きを読む
PythonAsyncio徹底解説:2026年のコルーチン、タスク、イベントループ
2026年のPythonasyncioをマスターし、コルーチン、TaskGroupとgatherの比較、uvloopの内部、イベントループの枯渇防止、非同期セマフォプーリングを習得しましょう。
続きを読む
本番環境Pythonのための高度なMypy Strict Modeパターン
大規模なPythonコードベースで、ParamSpec、TypeVarTuple、Protocols、カスタム型ガードを用いた高度なmypy strict型チェックパターンを習得しましょう。
続きを読む