BigQuery + Cloud Run: 本番向けのサーバーレスデータ取込パイプライン構築

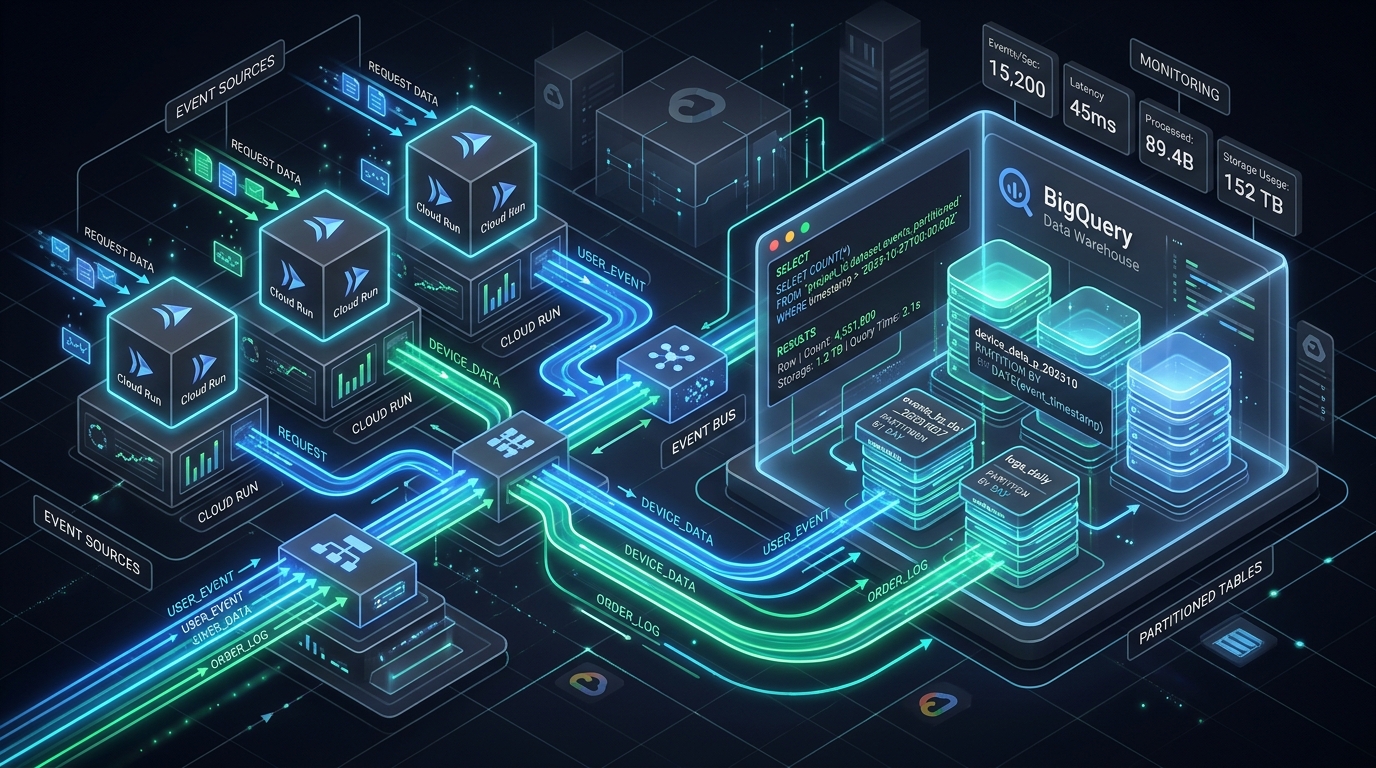
プラットフォームエンジニアとして、私はその場しのぎの実装から完成度の高いものまで、数えきれないほどの取込パイプラインを見てきました。本番環境で、大量のイベントストリームを低レイテンシかつ信頼性が高く、かつコスト効率のよい形で処理するシステムを構築するのは容易なことではありません。
本書は、上流の設計判断から実装の詳細、費用への影響、運用周りの強靭化まで扱う実践ガイドです。
1. アーキテクチャ概要: サーバーレス取込
本章のサーバーレス取込パイプラインは、高スループットかつ低レイテンシなイベント処理に向けて設計されており、解析のためにデータを確実に BigQuery へ届けることを目的にしています。
中核となる考え方は、管理されたサービスを使って運用負荷を最小化し、スケーラビリティを最大限に引き出すことです。
エンドツーエンドのフローは次の通りです:
- イベントソース: データが発生するアプリケーションやサービス (Webhook、IoT デバイス、内部マイクロサービスなど)。
- パブリッシャー (任意だが推奨): イベントを Pub/Sub のトピックへ発行します。これにより疎結合、バッファリング、組み込みの再試行機構が得られ、信頼性と突発的なトラフィックの吸収力が上がります。HTTP で直接取り込む場合はこの層を飛ばします。
- Cloud Run レシーバ: Cloud Run 上にデプロイされたステートレスな HTTP サービス (FastAPI で実装)。イベント (HTTP 直接、または Pub/Sub の push サブスクリプション経由の pull) を受け取り、検証したうえで BigQuery へ流します。
- BigQuery Storage Write API: Cloud Run サービスが BigQuery Storage Write API を使って、効率的で信頼性の高い exactly-once の取込を行います。
- BigQuery テーブル: データは BigQuery のテーブルへ書き込まれ、通常はイベント時刻でパーティション分割し、関連する次元でクラスタリングします。クエリ性能の最適化とコスト削減が両立します。
- 下流のコンシューマー: BigQuery に入ったデータは、解析、ダッシュボード (Looker Studio、Power BI)、機械学習モデル、後段の変換 (dbt、Dataflow) ですぐに利用できます。
+----------------+       +-----------+       +---------------+       +---------------------+       +----------------+       +-------------------+
|                |       |           |       |               |       |                     |       |                |       |                   |
|  Event Source  +------>|  Pub/Sub  +------>|  Cloud Run    +------>|  BigQuery Storage   +------>|  BigQuery      +------>|  Downstream       |
| (Application,  |       |   Topic   |       |  (FastAPI     |       |    Write API        |       |  Table         |       |  Consumers        |
|  IoT, Webhook) |       |           |       |   Receiver)   |       |                     |       | (Partitioned,  |       | (Analytics, ML,   |
|                |       |           |       |               |       |                     |       |  Clustered)    |       |  Dashboards)      |
+----------------+       +-----------+       +---------------+       +---------------------+       +----------------+       +-------------------+
        ^                                            |                                                      ^
        |                                            |                                                      |
        |                                            +------------------------------------------------------+
        |                                                    (Error Handling, DLQ, Monitoring)
        |
        +-----------------------------------------------------------------------------------------------------
                                                              (Direct HTTP Ingestion - bypasses Pub/Sub)
このアーキテクチャは完全にサーバーレスです。プロビジョニング、パッチ適用、管理すべきサーバーは存在しません。スケールは需要に応じて自動的に行われます。
2. BigQuery Storage Write API: ストリーミングを正しく実装する
大量かつリアルタイムなデータを BigQuery へ取り込むなら、Storage Write API が決定的な選択肢です。旧来の JSON ストリーミング挿入 (現在も利用できますが、高性能な新規パイプラインでは一般に非推奨) や、Cloud Storage を経由したバッチロードよりも明確に優れています。
Storage Write API が旧来のストリーミングより優れている理由
旧来の JSON ストリーミング挿入 API (tabledata.insertAll) にはいくつかの制約があります。
- コスト: 行あたりの単価が 高くなります。
- スループット: スループットの上限が低くなります。
- 信頼性: best-effort のセマンティクスであり、exactly-once 処理にはクライアント側の重複排除が必要です。
- スキーマの進化: 柔軟性が低く、スキーマ変更を慎重に扱う必要があります。
BigQuery Storage Write API はこれらの欠点を解消します。
- コスト効率: 概してよりコスト効率が高く、スケール越大にその差は広がります。
- 高いスループット: 大量のデータ取込レートを想定して設計されています。
- Exactly-Once セマンティクス: 重要な点として、ストリーム内で exactly-once の配信をサポートし、クライアント側の重複排除が不要になります。
- スキーマの進化: スキーマ更新 ( nullable カラムの追加など) の扱いが優れています。
- 型安全性: データ直列化に Avro または Protobuf を使い、生の JSON より強い型検査を得ます。API は JSON ペイロードも受け付けますが、最適な性能とスキーマ検証のためには Avro/Protobuf の利用が推奨されます。本稿では、通常の HTTP サービスとの統合が容易な JSON ストリーム形式に絞って説明します。
- オフセットベースの再生: 一時的なエラーからの確実な復旧を可能にします。
JSON ストリーム形式
Storage Write API を JSON で使う場合、データは AppendRowsRequest の json_rows フィールド内に JSON オブジェクトのリストとして送られます。各オブジェクトが 1 行を表します。API は名前に基づいて JSON のフィールドを BigQuery テーブルのカラムへ自動的にマッピングします。
簡略化した AppendRowsRequest ペイロードの例 (概念理解のためのもの) です:
{
  "writeStream": "projects/my-project/datasets/my_dataset/tables/my_table/streams/my_stream_id",
  "offset": {
    "value": "123"
  },
  "jsonRows": {
    "rows": [
      {"event_id": "abc-123", "event_timestamp": "2023-10-27T10:00:00Z", "payload": {"user_id": 123, "action": "click"}},
      {"event_id": "def-456", "event_timestamp": "2023-10-27T10:00:01Z", "payload": {"user_id": 456, "action": "view"}}
    ]
  }
}
Append-Rows ストリームの命名規則
Storage Write API はストリームを使ってデータ取込を管理します。主として 2 種類のストリームがあり、命名規則と保証の内容が異なります。
_defaultストリーム: 既定の、バッファリングされないストリームです。at-most-once のセマンティクスを持ち、各AppendRowsRequestは直ちに BigQuery へ書き込みます。リクエストが失敗した場合、クライアントが再試行しない限りデータは失われ、組み込みの重複排除もありません。mission-critical なデータには一般に推奨しません。_append_ストリーム (例:_append_stream_id): exactly-once のセマンティクスを提供する バッファリング ストリームです。_append_で始まるカスタム ID のストリームを作ると、API は内部でデータをバッファリングします。データを可視化するにはWriteStream.Finalize()とWriteStream.Commit()を明示的に呼ぶ必要があります。最大の利点は、AppendRowsRequestにoffsetを指定できることです。リクエストが失敗しても同じoffsetで再試行でき、API はデータをちょうど一度だけ書き込むことを保証します。確実な取込にはこの方法が推奨されます。
本稿では、信頼性と exactly-once の保証に優れる _append_ ストリームに絞って説明します。
オフセットベースの再生と Exactly-Once セマンティクス
AppendRowsRequest の offset フィールドは exactly-once 配信の要です。_append_ ストリームへ行を追加するとき、期待する offset を指定します。BigQuery サービスは AppendRowsResponse の中で、書き込まれた最初の行の実際の offset を返します。
- クライアントの責務: クライアントは各ストリームの現在の
offsetを保持しなければなりません。行のバッチを送信するときのoffsetは、現在のバッチより 前 に正常に書き込まれた行数であるべきです。 - 再試行の仕組み:
AppendRowsRequestが失敗した場合 (ネットワークエラー、BigQuery の一時的なエラーなど)、クライアントは バッチ全体を 同じoffsetで安全に再試行できます。Storage Write API はそのoffsetのデータがすでに書き込まれたかを判別し、成功応答を返すだけなので、重複は発生しません。 - ストリームの確定とコミット:
_append_ストリームの場合、ストリームが確定してコミットされた 後 で初めてデータがクエリから見えるようになります。これにより、複数のAppendRowsRequestを 1 つのアトミックなトランザクションにまとめられます。
クライアントライブラリ
Google Cloud は Storage Write API のための慣用的なクライアントライブラリを複数の言語で提供しています。
- Go:
cloud.google.com/go/bigquery/storage/apiv1 - Java:
com.google.cloud:google-cloud-bigquery-storage - Python:
google-cloud-bigquery-storage - Node.js:
@google-cloud/bigquery-storage
これらのライブラリは gRPC の複雑な 部分を抽象化し、ストリーム管理とデータ追加のための上位レベル API を提供します。
実装例 (Python)
次の Python の例は、BigQuery Storage Write API を使って _append_ ストリームを作成し、行を追加する方法を示します。
import json
import time
from google.cloud import bigquery_storage_v1
from google.cloud.bigquery_storage_v1 import types
from google.cloud.bigquery_storage_v1 import writer

def append_rows_to_bq_stream(
    project_id: str,
    dataset_id: str,
    table_id: str,
    rows: list[dict] # List of dictionaries, each representing a row
):
    """Appends rows to a BigQuery table using the Storage Write API."""

    client = bigquery_storage_v1.BigQueryWriteClient()
    table_path = client.table_path(project_id, dataset_id, table_id)

    # Create a write stream.
    # Use the 'PENDING' type for exactly-once semantics and explicit commit.
    write_stream = types.WriteStream(type_=types.WriteStream.Type.PENDING)
    write_stream = client.create_write_stream(
        parent=table_path, write_stream=write_stream
    )
    stream_name = write_stream.name
    print(f"Created write stream: {stream_name}")

    # Create a JSON stream writer.
    # This writer manages the connection and sends batches.
    # The `offset` is managed internally by the writer for exactly-once delivery.
    json_stream_writer = writer.JsonStreamWriter(
        client,
        stream_name,
        # The schema of the table. The Storage Write API uses this to validate
        # and correctly parse JSON rows.
        # It's crucial to provide the correct schema.
        table_schema={
            "fields": [
                {"name": "event_id", "type": "STRING", "mode": "REQUIRED"},
                {"name": "event_timestamp", "type": "TIMESTAMP", "mode": "REQUIRED"},
                {"name": "user_id", "type": "INTEGER", "mode": "NULLABLE"},
                {"name": "action", "type": "STRING", "mode": "NULLABLE"},
                {"name": "payload", "type": "JSON", "mode": "NULLABLE"}
            ]
        }
    )

    # Append rows. The writer handles batching and sending.
    # It also manages the offset for exactly-once semantics.
    try:
        # The `append_rows` method returns a future.
        # We wait for it to complete to ensure the write is acknowledged.
        # In a real application, you might manage these futures asynchronously.
        append_future = json_stream_writer.append_rows(rows)
        response = append_future.result() # Blocks until response is received

        if response.row_errors:
            print(f"Row errors encountered: {response.row_errors}")
        else:
            print(f"Successfully appended {len(rows)} rows to stream {stream_name} at offset {response.append_result.offset.value}")

    except Exception as e:
        print(f"Error appending rows: {e}")
        # In a real system, you'd handle this more robustly,
        # potentially retrying or sending to a DLQ.
        client.batch_finalize_write_stream(names=[stream_name]) # Finalize to release resources
        raise

    finally:
        # Finalize the stream. This makes the buffered data visible.
        # For PENDING streams, data is only visible after commit.
        # For COMMITTED streams (not used here), data is visible immediately.
        client.finalize_write_stream(name=stream_name)
        print(f"Finalized write stream: {stream_name}")

        # Commit the stream. This is required for PENDING streams
        # to make the data permanent.
        batch_commit_write_streams_request = types.BatchCommitWriteStreamsRequest()
        batch_commit_write_streams_request.parent = table_path
        batch_commit_write_streams_request.write_streams.append(stream_name)
        client.batch_commit_write_streams(batch_commit_write_streams_request)
        print(f"Committed write stream: {stream_name}")

# Example usage:
if __name__ == "__main__":
    PROJECT_ID = "your-gcp-project-id"
    DATASET_ID = "your_dataset"
    TABLE_ID = "your_table"

    sample_rows = [
        {"event_id": "uuid-1", "event_timestamp": "2023-10-27T10:00:00.123456Z", "user_id": 1, "action": "login", "payload": {"ip": "1.1.1.1"}},
        {"event_id": "uuid-2", "event_timestamp": "2023-10-27T10:00:01.678901Z", "user_id": 2, "action": "logout", "payload": {"duration_s": 600}},
    ]

    # Ensure the table and dataset exist before running this.
    # The table schema should match the fields provided to JsonStreamWriter.
    append_rows_to_bq_stream(PROJECT_ID, DATASET_ID, TABLE_ID, sample_rows)
このコードの要点:
WriteStream.Type.PENDING: exactly-once セマンティクスのために決定的な部分です。データはバッファリングされ、明示的にfinalize_write_streamとbatch_commit_write_streamsを呼んだ後に初めて可視になります。JsonStreamWriter: ストリームの管理、行のバッチ化、オフセットの扱いを簡潔にするヘルパークラスです。- スキーマ定義:
JsonStreamWriterにtable_schemaを渡すことは、JSON の行を正しく解析し検証するために必須です。 - エラー処理:
try...except...finallyブロックは、追加中に発生したエラーの扱い方と、ストリームが確実に確定・コミットされることの示し方です。本番では、より精緻な再試行ロジックと、回復不能なエラー向けの Dead Letter Queue (DLQ) を実装するはずです。
3. パーティショニングとクラスタリング: BigQuery の最適化
BigQuery の強みは、巨大なデータセットを高速にスキャンできることにあります。パーティショニングとクラスタリングは、走査するデータ量を最小化することでクエリ性能を高め、コストを抑えるための基本技法です。
パーティショニング: データのセグメント化
パーティショニングは、特定カラムの値や取込時刻を基準にテーブルをより小さく管理しやすいセグメントへ分割します。パーティションカラムで絞り込むクエリは該当するパーティションだけを走査するため、処理データ量が大きく減ります。
-
取込時刻基準のパーティショニング:
- 仕組み: BigQuery は、テーブルへ取り込まれた時刻に基づいて自動的にデータをパーティション分割します。
- 擬似カラム:
_PARTITIONTIME(TIMESTAMP) または_PARTITIONDATE(DATE) の擬似カラムを使います。 - ユースケース: イベント時刻が利用できない、あるいは信頼できない場合、あるいは「BigQuery に届いた時刻」で主にクエリする場合に最適です。
- 例:
PARTITION BY _PARTITIONDATE
-
イベント時刻基準のパーティショニング (カラム型):
- 仕組み: テーブルのスキーマ内にある
TIMESTAMPまたはDATEカラムに基づいてデータを分割します。イベントデータでは最も一般的で推奨される方法です。 - ユースケース: イベントが発生した時刻を正確に表す、信頼できるイベントタイムスタンプ (例えば
event_timestamp、created_at) を持っている場合。クエリを業務の時間軸に合わせられるようになります。 - 例:
PARTITION BY event_timestamp
- 仕組み: テーブルのスキーマ内にある
クラスタリング: パーティション内でのデータの並べ替え
クラスタリングは、指定した 1 つ以上のカラムの値に基づいて、各パーティション内のデータを並べ替えます。クエリがこのクラスタリング対象のカラムで絞り込みや集約を行うと、BigQuery は条件に合致しないデータブロックを効率よく枝刈りでき、走査バイト数をさらに減らせます。
- 仕組み: クラスタリングカラムは最大 4 つまで指定できます。BigQuery は、これらのカラムの値が類似する行を物理的に隣接させて配置します。
- 一部の絞り込みパターンではクラスタリングがパーティショニングに勝つ理由: パーティショニングは期間単位の広い絞り込みには有効です。しかし、特定の時間範囲の 中で カーディナリティの高いカラム (
user_idやdevice_idなど) で絞り込む必要がある場合、クラスタリングが威力を発揮します。SELECT * FROM my_table WHERE _PARTITIONDATE = '2023-10-27' AND user_id = 123のようなクエリは、_PARTITIONDATEでのパーティショニングとuser_idでのクラスタリングの両方から大きな恩恵を受けます。 - 整数範囲のクラスタリング: BigQuery は
INTEGERカラムのクラスタリングをサポートしています。例えばuser_idがINTEGERであれば、それでクラスタリングすることでユーザー単位にまとまります。
パーティションの有効期限
パーティションの有効期限を使うと、指定した期間を経過した古いパーティションを自動的に削除できます。データライフサイクルの管理、保存ポリシーに沿った運用、保存コストの抑制に欠かせません。
- 仕組み: テーブルの作成または更新時に
partition_expiration_days(またはpartition_expiration_microseconds) プロパティを設定します。 - 利点: 長期ストレージのコストを削減し、データの保持管理を簡素化できます。
コストとレイテンシのトレードオフ
- コスト削減: パーティショニングもクラスタリングも、多くのクエリで BigQuery が走査するデータ量を減らすため、そのままクエリコストの低下に直結します (BigQuery は走査データに対して課金されます)。
- レイテンシ改善: 走査データが減るほどクエリの実行時間は速くなります。
- 取込側のオーバーヘッド: BigQuery がパーティションとクラスタの維持に多少の負荷はありますが、これはクエリのコスト面・性能面のメリットに比べれば無視できます。
- 小さすぎるパーティション: 極端に小さいパーティションを多数作ると、メタデータのオーバーヘッドが発生することがあります。BigQuery はこれをかなりうまく扱いますが、考慮に入れておく価値はあります。
DDL の例
イベント時刻基準のパーティショニングとクラスタリングを示す CREATE TABLE 文です。
CREATE TABLE `your-gcp-project-id.your_dataset.your_table`
(
    event_id STRING NOT NULL OPTIONS(description="Unique identifier for the event"),
    event_timestamp TIMESTAMP NOT NULL OPTIONS(description="Timestamp when the event occurred"),
    user_id INTEGER OPTIONS(description="Identifier for the user"),
    session_id STRING OPTIONS(description="Identifier for the user session"),
    action STRING OPTIONS(description="Type of action performed"),
    payload JSON OPTIONS(description="JSON payload containing additional event details")
)
PARTITION BY DATE(event_timestamp) -- Partition by the date component of event_timestamp
CLUSTER BY user_id, session_id      -- Cluster within each partition by user_id and session_id
OPTIONS(
    description="Table for storing application events, partitioned by event date and clustered by user/session.",
    partition_expiration_days=90, -- Partitions older than 90 days will be automatically deleted
    require_partition_filter=true -- Enforce partition filtering in queries to prevent full table scans
);
説明:
PARTITION BY DATE(event_timestamp):event_timestampカラムを使い、テーブルを日単位にパーティション分割します。CLUSTER BY user_id, session_id: 日ごとのパーティションの中で、データはuser_id、次にsession_idの順に並べられ、まとめられます。partition_expiration_days=90: 作成から 90 日を超えたパーティションは自動的に削除されます。require_partition_filter=true: コスト管理にとって決定的なオプションです。クエリで_PARTITIONTIME(この場合はevent_timestamp) による絞り込みを強制するため、つい主意してテーブル全体を走査してしまうことを防ぎます。
4. 非同期 FastAPI レシーバ: 取込のゲートウェイ
Cloud Run 上のレシーバは、本章の取込パイプラインのための HTTP エンドポイントとして機能します。FastAPI は非同期処理と Pydantic によるデータ検証を備えているため、このサービスの構築に最適です。
FastAPI と非同期コンテキストマネージャ
FastAPI は async/await をネイティブに扱えます。これは BigQuery への書き込みのような I/O バウンドな操作では重要です。ただし google-cloud-bigquery-storage の Python クライアントは主に同期型です。これを非同期の FastAPI アプリケーションで効率よく使うには、同期的な BigQuery 呼び出しをスレッドプールへ移すか asyncio.to_thread を使う必要があります。より重要なのは、BigQueryWriteClient とその下にある gRPC ストリームのライフサイクル管理です。コネクションプーリングとグレースフルシャットダウンの点で慎重な扱いが求められます。
非同期コンテキストマネージャ (async with) はこの目的に最適です。BigQuery の書き込みストリームのライフサイクルを管理し、適切に初期化され、確実に閉じられることを保証してくれます。
コネクションプーリング
到着するリクエストごとに新しい BigQueryWriteClient と新しい書き込みストリームを作るのは効率が悪いです。接続確立のオーバーヘッドが発生し、既存の接続を活用できていません。より良いアプローチは次の通りです。
BigQueryWriteClientの再利用:BigQueryWriteClient自体はシングルトンにすることも、プロセスごとに一度だけ生成することもできます。- 書き込みストリームのプール化:
_append_ストリームについては、長寿命のストリームのプールを作れます。各ストリームは複数のAppendRowsRequestを処理できます。リクエストが来たら、プールから空いているストリームを選び、行を追加し、そのストリームをプールへ返します。これによりストリームの作成・確定のオーバーヘッドを最小化できます。本章の例では簡潔さのためにバッチごとにストリームを 1 つ作りますが、より高度な方法ではプール化します。
バックプレッシャー
取込レートが処理能力や BigQuery の書き込み上限を上回る場合、バックプレッシャーを適切に扱うことは不可避な課題です。
- Cloud Run の自動スケーリング: Cloud Run はインスタンスを自動的にスケールさせる点で有効です。しかし、単一のインスタンスが処理しきれなくなった場合は、内部キューがバッファとして機能します。
- BigQuery のクォータ: BigQuery にはストリーミング挿入のクォータがあります。そこに達した場合、Storage Write API のクライアントは通常再試行しますが、クォータ超過が持続する場合は対処が必要です (例えばクォータを引き上げる、または上流で流量を制限する)。
処理中ストリームのグレースフルシャットダウン
Cloud Run のインスタンスが終了するとき (スケールダウン、デプロイなど)、SIGTERM シグナルを受け取ります。アプリケーションはこれを丁寧に扱う必要があります。
- 新しいリクエストの受付を停止する。
- 処理中のリクエストを処理する: 進行中の
AppendRowsRequestが完了するまで待ちます。 - 開いている
_append_ストリームをすべて確定してコミットする: これにより、バッファ内のデータすべてが BigQuery へ書き出されます。これを行わないと、保留中のストリームのデータが失われたり、遅延したりします。
FastAPI の lifespan イベントハンドラは、この処理に最適です。
Cloud Run の同時実行数のチューニング
Cloud Run は性能とコストを最適化するためのパラメータをいくつか備えています。
concurrency: 1 つのインスタンスが同時に扱えるリクエスト数の上限です。高い同時実行数 (例えば 80-250) は、アプリケーションが本当に非同期でブロックしない限り、I/O バウンドなサービスである本レシーバには一般に有利に働きます。request timeouts: 大きなバッチでの BigQuery 書き込みレイテンシを吸収できる程度に高く設定しますが、失敗したリクエストが長く残るほど高くないようにします。60-120 秒が妥当な出発点です。min-instances/max-instances:min-instancesは一定数のインスタンスを起動したまま温存し、コールドスタートのレイテンシを削減します。max-instancesは支出とリソース使用量を頭打ちにします。- ストリーミング応答とバッファリング応答: 取込レシーバは主としてデータを 受け取り ます。応答をストリーミングして返すわけではありません。重点は、届いたリクエスト本文を効率よく処理することです。
冪等性キー
クライアント側での再試行は日常的なことです。冪等性がなければ、再試行されたリクエストが BigQuery 内に重複データを生む可能性があります。
- 仕組み: クライアントは各リクエストに一意な
Idempotency-Keyヘッダーを付けて送ります。 - レシーバ側のロジック:
- リクエストを受け取ったら、
Idempotency-Keyが最近見られたかどうかを確認します (例えば Redis のキャッシュや小さなインメモリキャッシュ)。 - 見たことがあり、まだ「処理中」なら、再処理せずに
202 Acceptedまたは409 Conflictを返します (望ましい動作に応じて選びます)。 - 見たことがあり「処理成功」済みなら、再処理せずに
200 OKを返します。 - 見たことがないなら、リクエストを処理し、
Idempotency-Keyとその状態を保存してから結果を返します。
- リクエストを受け取ったら、
- BigQuery Storage Write API と冪等性: オフセットベースの再生により、Storage Write API は 単一のストリーム内 で冪等性を担保します。しかし、BigQuery への書き込みが始まる前に Cloud Run へのリクエスト全体が 丸ごと再試行された場合、あるいは新しいストリームが作られた場合の重複を防ぐには、アプリケーションレベルの冪等性キーが必要です。補完的な防御の層です。
実装例 (FastAPI)
次の例は、シングルトンの BigQuery クライアントを持つ FastAPI レシーバで、受信した JSON イベントを処理し、Storage Write API で書き込むものです。
import os
import asyncio
import logging
from contextlib import asynccontextmanager
from typing import List, Dict, Any, Optional

from fastapi import FastAPI, Request, HTTPException, status
from pydantic import BaseModel, Field
from google.cloud import bigquery_storage_v1
from google.cloud.bigquery_storage_v1 import types
from google.cloud.bigquery_storage_v1 import writer
from concurrent.futures import ThreadPoolExecutor

# --- Configuration ---
PROJECT_ID = os.environ.get("GCP_PROJECT_ID")
DATASET_ID = os.environ.get("BQ_DATASET_ID")
TABLE_ID = os.environ.get("BQ_TABLE_ID")
BIGQUERY_TABLE_SCHEMA = {
    "fields": [
        {"name": "event_id", "type": "STRING", "mode": "REQUIRED"},
        {"name": "event_timestamp", "type": "TIMESTAMP", "mode": "REQUIRED"},
        {"name": "user_id", "type": "INTEGER", "mode": "NULLABLE"},
        {"name": "action", "type": "STRING", "mode": "NULLABLE"},
        {"name": "payload", "type": "JSON", "mode": "NULLABLE"}
    ]
}
MAX_BIGQUERY_STREAM_IDLE_SECONDS = 300 # Close streams if idle for too long
MAX_BIGQUERY_STREAM_BATCH_SIZE = 1000 # Max rows per append call
MAX_BIGQUERY_STREAM_BATCH_BYTES = 10 * 1024 * 1024 # 10MB per append call
MAX_WORKER_THREADS = 5 # For offloading synchronous BigQuery calls

# --- Logging ---
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)

# --- Global BigQuery Client and Thread Pool ---
# We use a global client and thread pool to reuse resources efficiently.
bq_storage_client: Optional[bigquery_storage_v1.BigQueryWriteClient] = None
bq_executor: Optional[ThreadPoolExecutor] = None

# --- Pydantic Models for Request Validation ---
class EventPayload(BaseModel):
    ip: Optional[str] = None
    duration_s: Optional[int] = None
    # Add other dynamic fields as needed. Use Any for truly flexible JSON.
    # For strict validation, define all expected fields.

class Event(BaseModel):
    event_id: str = Field(..., description="Unique identifier for the event")
    event_timestamp: str = Field(..., description="ISO 8601 timestamp of the event")
    user_id: Optional[int] = Field(None, description="User ID associated with the event")
    action: Optional[str] = Field(None, description="Action performed by the user")
    payload: Optional[EventPayload] = Field(None, description="Additional event details")

# --- FastAPI Lifespan Management ---
@asynccontextmanager
async def lifespan(app: FastAPI):
    global bq_storage_client, bq_executor
    logger.info("Starting up Cloud Run receiver...")

    if not all([PROJECT_ID, DATASET_ID, TABLE_ID]):
        logger.error("Missing required environment variables for BigQuery connection.")
        raise RuntimeError("BigQuery environment variables not set.")

    bq_storage_client = bigquery_storage_v1.BigQueryWriteClient()
    bq_executor = ThreadPoolExecutor(max_workers=MAX_WORKER_THREADS)
    logger.info("BigQueryWriteClient and ThreadPoolExecutor initialized.")

    yield # Application runs

    logger.info("Shutting down Cloud Run receiver...")
    if bq_storage_client:
        # In a real scenario, you'd manage open write streams here.
        # For this simple example, we assume streams are short-lived per request.
        # If using long-lived pooled streams, you'd finalize/commit them here.
        bq_storage_client.transport.close() # Close gRPC connections
        logger.info("BigQueryWriteClient closed.")
    if bq_executor:
        bq_executor.shutdown(wait=True)
        logger.info("ThreadPoolExecutor shut down.")
    logger.info("Cloud Run receiver shut down complete.")

app = FastAPI(
    title="BigQuery Serverless Ingestion Receiver",
    description="Receives events and streams them to BigQuery via Storage Write API.",
    version="1.0.0",
    lifespan=lifespan
)

# --- Idempotency Cache (In-memory for simplicity, use Redis for production) ---
# This is a very basic in-memory cache. For production, use a distributed cache like Redis.
# Stores {idempotency_key: (status, timestamp)}
IDEMPOTENCY_CACHE: Dict[str, tuple[str, float]] = {}
IDEMPOTENCY_CACHE_EXPIRATION_SECONDS = 3600 # 1 hour

def check_idempotency(idempotency_key: str) -> Optional[str]:
    """Checks idempotency cache. Returns 'processed' if seen, None otherwise."""
    if idempotency_key in IDEMPOTENCY_CACHE:
        status, timestamp = IDEMPOTENCY_CACHE[idempotency_key]
        if time.time() - timestamp < IDEMPOTENCY_CACHE_EXPIRATION_SECONDS:
            logger.info(f"Idempotent request detected for key: {idempotency_key}. Status: {status}")
            return status
        else:
            # Expired entry, remove it
            del IDEMPOTENCY_CACHE[idempotency_key]
    return None

def set_idempotency_status(idempotency_key: str, status: str):
    """Sets idempotency status."""
    IDEMPOTENCY_CACHE[idempotency_key] = (status, time.time())

# --- BigQuery Write Function (Synchronous, to be run in thread pool) ---
def _write_to_bigquery_sync(
    client: bigquery_storage_v1.BigQueryWriteClient,
    table_path: str,
    rows_to_insert: List[Dict[str, Any]]
):
    """Synchronously writes rows to BigQuery using Storage Write API."""
    write_stream = client.create_write_stream(
        parent=table_path, write_stream=types.WriteStream(type_=types.WriteStream.Type.PENDING)
    )
    stream_name = write_stream.name
    logger.info(f"Created write stream: {stream_name}")

    json_stream_writer = writer.JsonStreamWriter(
        client,
        stream_name,
        table_schema=BIGQUERY_TABLE_SCHEMA
    )

    try:
        append_future = json_stream_writer.append_rows(rows_to_insert)
        response = append_future.result() # Blocks until response

        if response.row_errors:
            logger.error(f"Row errors for stream {stream_name}: {response.row_errors}")
            raise RuntimeError(f"BigQuery row errors: {response.row_errors}")
        else:
            logger.info(f"Successfully appended {len(rows_to_insert)} rows to stream {stream_name} at offset {response.append_result.offset.value}")

    except Exception as e:
        logger.error(f"Failed to append rows to BigQuery stream {stream_name}: {e}")
        # Finalize to release resources even on error
        client.finalize_write_stream(name=stream_name)
        raise
    finally:
        # Finalize and commit the stream to make data visible
        client.finalize_write_stream(name=stream_name)
        commit_request = types.BatchCommitWriteStreamsRequest(
            parent=table_path,
            write_streams=[stream_name]
        )
        client.batch_commit_write_streams(commit_request)
        logger.info(f"Committed write stream: {stream_name}")


# --- FastAPI Endpoint ---
@app.post("/ingest")
async def ingest_events(request: Request, events: List[Event]):
    """
    Receives a batch of events and streams them to BigQuery.
    """
    idempotency_key = request.headers.get("Idempotency-Key")

    if idempotency_key:
        status_in_cache = check_idempotency(idempotency_key)
        if status_in_cache == "processed":
            return {"message": "Request already processed", "status": "idempotent_success"}
        elif status_in_cache == "processing":
            raise HTTPException(
                status_code=status.HTTP_409_CONFLICT,
                detail="Request with this Idempotency-Key is already being processed."
            )
        set_idempotency_status(idempotency_key, "processing")

    if not bq_storage_client or not bq_executor:
        logger.error("BigQuery client or executor not initialized.")
        raise HTTPException(
            status_code=status.HTTP_500_INTERNAL_SERVER_ERROR,
            detail="Service not ready."
        )

    table_path = bq_storage_client.table_path(PROJECT_ID, DATASET_ID, TABLE_ID)
    rows_to_insert = [event.model_dump(mode='json') for event in events]

    try:
        # Offload synchronous BigQuery write to a separate thread
        await asyncio.to_thread(
            _write_to_bigquery_sync,
            bq_storage_client,
            table_path,
            rows_to_insert
        )
        if idempotency_key:
            set_idempotency_status(idempotency_key, "processed")
        return {"message": f"Successfully ingested {len(events)} events."}
    except Exception as e:
        logger.error(f"Failed to ingest events: {e}", exc_info=True)
        if idempotency_key:
            set_idempotency_status(idempotency_key, "failed")
        raise HTTPException(
            status_code=status.HTTP_500_INTERNAL_SERVER_ERROR,
            detail=f"Failed to write to BigQuery: {e}"
        )

# Example of a health check endpoint
@app.get("/health")
async def health_check():
    return {"status": "ok"}
さて、このアプリケーションをコンテナイメージにパッケージ化しましょう。
Dockerfile
# Use an official Python runtime as a parent image
FROM python:3.10-slim-buster

# Set the working directory in the container
WORKDIR /app

# Install dependencies
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

# Copy the application code
COPY . .

# Expose the port the app runs on
ENV PORT 8080

# Run the application with Uvicorn
CMD exec uvicorn main:app --host 0.0.0.0 --port $PORT --workers 1
依存関係ファイル
fastapi
uvicorn[standard]
google-cloud-bigquery-storage
pydantic
Cloud Run へのデプロイ
イメージをビルドして Container Registry へプッシュしたら、サービスをデプロイできます。
gcloud run deploy bigquery-ingester \
  --image gcr.io/your-project-id/bigquery-ingester:latest \
  --platform managed \
  --region us-central1 \
  --allow-unauthenticated \
  --cpu 1 \
  --memory 2Gi \
  --concurrency 80 \
  --timeout 120s \
  --min-instances 1 \
  --max-instances 10 \
  --set-env-vars GCP_PROJECT_ID=your-project-id,BQ_DATASET_ID=your_dataset,BQ_TABLE_ID=your_table \
  --service-account bigquery-ingester-sa@your-project-id.iam.gserviceaccount.com
Cloud Run の主要チューニングパラメータ:
--concurrency 80: I/O バウンドな Python 非同期アプリケーションにとって良い出発点です。プロファイリングの結果に基づいて調整してください。--timeout 120s: 大きなバッチでの BigQuery 書き込み処理が収まるだけの時間を確保します。特にバッチサイズが大きい場合に有効です。--min-instances 1: 重要な取込のためにインスタンスを 1 台ウォームな状態に保ち、コールドスタートのレイテンシを抑えます。--max-instances 10: スケールの上限を定め、費用を抑えます。
5. スタック全体を Terraform で扱う
Terraform は、パイプライン全体の管理を Infrastructure as Code (IaC) として提供します。これにより再現性、バージョン管理、一貫したデプロイが保証されます。
以下を定義します。
- 必要な Google Cloud API。
- 最小権限の IAM ロールを持つ専用のサービスアカウント。
- イベント用の Pub/Sub トピックと Dead Letter トピック (DLT)。
- Pub/Sub サブスクリプション (イベントが Pub/Sub から届く場合)。
- BigQuery データセットと、パーティショニングおよびクラスタリングされたテーブル。
- FastAPI レシーバ用の Cloud Run サービス。
- 保守タスク (スキーマ移行、データのバックフィルなど) 用の最小限の Cloud Run Job (v2 ワーカー)。
# main.tf

# -----------------------------------------------------------------------------
# Provider and Configuration
# -----------------------------------------------------------------------------
terraform {
  required_providers {
    google = {
      source  = "hashicorp/google"
      version = "~> 5.0"
    }
  }
  required_version = ">= 1.0"
}

# Variables for project and region
variable "project_id" {
  description = "The GCP project ID."
  type        = string
}

variable "region" {
  description = "The GCP region for resources."
  type        = string
  default     = "us-central1"
}

variable "dataset_id" {
  description = "BigQuery Dataset ID for ingestion."
  type        = string
  default     = "event_data"
}

variable "table_id" {
  description = "BigQuery Table ID for ingested events."
  type        = string
  default     = "app_events"
}

variable "cloud_run_service_name" {
  description = "Name of the Cloud Run service."
  type        = string
  default     = "bigquery-ingester"
}

variable "cloud_run_job_name" {
  description = "Name of the Cloud Run Job (v2 worker)."
  type        = string
  default     = "bq-maintenance-job"
}

variable "image_tag" {
  description = "Docker image tag for the Cloud Run service/job."
  type        = string
  default     = "latest" # In production, use specific version tags like v1.0.0
}

# -----------------------------------------------------------------------------
# Enable Required APIs
# -----------------------------------------------------------------------------
resource "google_project_service" "apis" {
  for_each = toset([
    "run.googleapis.com",
    "pubsub.googleapis.com",
    "bigquery.googleapis.com",
    "bigqueryconnection.googleapis.com", # Required for Storage Write API
    "bigquerystorage.googleapis.com",    # Required for Storage Write API
    "artifactregistry.googleapis.com",   # For Docker image storage
    "cloudbuild.googleapis.com",         # If using Cloud Build for CI/CD
    "iam.googleapis.com"                 # For managing service accounts
  ])
  project = var.project_id
  service = each.key
  disable_on_destroy = false
}

# -----------------------------------------------------------------------------
# Service Account and IAM
# -----------------------------------------------------------------------------
resource "google_service_account" "ingester_sa" {
  project      = var.project_id
  account_id   = "bigquery-ingester-sa"
  display_name = "Service Account for BigQuery Ingestion Cloud Run Service"
}

# Grant BigQuery Data Editor role for writing to the table
resource "google_project_iam_member" "bq_data_editor" {
  project = var.project_id
  role    = "roles/bigquery.dataEditor" # Allows writing data to tables
  member  = "serviceAccount:${google_service_account.ingester_sa.email}"
}

# Grant Pub/Sub Publisher role if Cloud Run pushes to Pub/Sub (e.g., for DLQ)
# Or if Cloud Run pulls from Pub/Sub via subscription
resource "google_project_iam_member" "pubsub_publisher" {
  project = var.project_id
  role    = "roles/pubsub.publisher"
  member  = "serviceAccount:${google_service_account.ingester_sa.email}"
  # Comment out if Cloud Run only receives HTTP and doesn't publish to Pub/Sub
}

# Allow Cloud Run to invoke the service (for unauthenticated access, this is 'allUsers')
# If you want authenticated access, use `google_cloud_run_service_iam_member`
# and specify which service accounts or users can invoke it.
resource "google_cloud_run_service_iam_member" "allow_unauthenticated" {
  project  = var.project_id
  location = var.region
  service  = google_cloud_run_service.ingester_service.name
  role     = "roles/run.invoker"
  member   = "allUsers"
  # Remove this block or change 'allUsers' to specific service accounts for authenticated access.
}

# -----------------------------------------------------------------------------
# Pub/Sub Topics (Main and Dead Letter)
# -----------------------------------------------------------------------------
resource "google_pubsub_topic" "main_events_topic" {
  project = var.project_id
  name    = "main-events-topic"
}

resource "google_pubsub_topic" "dlq_events_topic" {
  project = var.project_id
  name    = "dlq-events-topic"
}

# Pub/Sub Subscription (if Cloud Run pulls from Pub/Sub)
# This example assumes direct HTTP ingestion, but if using Pub/Sub as input,
# you'd create a push subscription to the Cloud Run service here.
/*
resource "google_pubsub_subscription" "cloud_run_push_subscription" {
  project = var.project_id
  name    = "cloud-run-ingester-sub"
  topic   = google_pubsub_topic.main_events_topic.name

  ack_deadline_seconds = 600 # Adjust based on processing time
  message_retention_duration = "604800s" # 7 days

  push_config {
    push_endpoint = google_cloud_run_service.ingester_service.status[0].url
    oidc_token {
      service_account_email = google_service_account.ingester_sa.email
    }
  }

  # Enable Dead Letter Queue
  dead_letter_policy {
    dead_letter_topic     = google_pubsub_topic.dlq_events_topic.id
    max_delivery_attempts = 5
  }

  # Enable exactly-once delivery (requires corresponding client-side support)
  enable_exactly_once_delivery = true
}
*/

# -----------------------------------------------------------------------------
# BigQuery Dataset and Table
# -----------------------------------------------------------------------------
resource "google_bigquery_dataset" "event_dataset" {
  project    = var.project_id
  dataset_id = var.dataset_id
  location   = var.region
  description = "Dataset for storing application event data."
}

resource "google_bigquery_table" "events_table" {
  project    = var.project_id
  dataset_id = google_bigquery_dataset.event_dataset.dataset_id
  table_id   = var.table_id
  deletion_protection = false # Set to true in production for critical tables

  schema = jsonencode([
    {
      name        = "event_id"
      type        = "STRING"
      mode        = "REQUIRED"
      description = "Unique identifier for the event"
    },
    {
      name        = "event_timestamp"
      type        = "TIMESTAMP"
      mode        = "REQUIRED"
      description = "Timestamp when the event occurred"
    },
    {
      name        = "user_id"
      type        = "INTEGER"
      mode        = "NULLABLE"
      description = "Identifier for the user"
    },
    {
      name        = "session_id"
      type        = "STRING"
      mode        = "NULLABLE"
      description = "Identifier for the user session"
    },
    {
      name        = "action"
      type        = "STRING"
      mode        = "NULLABLE"
      description = "Type of action performed"
    },
    {
      name        = "payload"
      type        = "JSON"
      mode        = "NULLABLE"
      description = "JSON payload containing additional event details"
    }
  ])

  time_partitioning {
    type                    = "DAY"
    field                   = "event_timestamp"
    expiration_ms           = 90 * 24 * 60 * 60 * 1000 # 90 days in milliseconds
    require_partition_filter = true
  }

  clustering = ["user_id", "session_id"] # Order matters for clustering

  labels = {
    env = "production"
    app = "ingestion"
  }
}

# -----------------------------------------------------------------------------
# Cloud Run Service (FastAPI Receiver)
# -----------------------------------------------------------------------------
resource "google_cloud_run_service" "ingester_service" {
  project  = var.project_id
  location = var.region
  name     = var.cloud_run_service_name

  template {
    spec {
      service_account_name = google_service_account.ingester_sa.email
      containers {
        image = "gcr.io/${var.project_id}/${var.cloud_run_service_name}:${var.image_tag}"
        env {
          name  = "GCP_PROJECT_ID"
          value = var.project_id
        }
        env {
          name  = "BQ_DATASET_ID"
          value = google_bigquery_dataset.event_dataset.dataset_id
        }
        env {
          name  = "BQ_TABLE_ID"
          value = google_bigquery_table.events_table.table_id
        }
        resources {
          cpu_idle = true # Optimize for CPU usage when idle
          limits = {
            cpu    = "1000m" # 1 CPU
            memory = "2Gi"   # 2 GB RAM
          }
        }
      }
      container_concurrency = 80 # Max concurrent requests per instance
    }

    metadata {
      annotations = {
        "autoscaling.knative.dev/minScale" = "1"
        "autoscaling.knative.dev/maxScale" = "10"
        "run.googleapis.com/client-name" = "terraform"
        "run.googleapis.com/vpc-access-connector" = "" # If using VPC Access
        "run.googleapis.com/vpc-access-egress" = "all" # If using VPC Access
      }
    }
  }

  traffic {
    percent         = 100
    latest_revision = true
  }

  timeouts {
    create = "10m"
    update = "10m"
  }

  lifecycle {
    ignore_changes = [
      template[0].metadata[0].annotations["autoscaling.knative.dev/minScale"],
      template[0].metadata[0].annotations["autoscaling.knative.dev/maxScale"],
    ]
  }
}

# -----------------------------------------------------------------------------
# Cloud Run Job (v2 Worker - e.g., for schema migrations or backfills)
# -----------------------------------------------------------------------------
resource "google_cloud_run_v2_job" "bq_maintenance_job" {
  project  = var.project_id
  location = var.region
  name     = var.cloud_run_job_name

  template {
    template {
      service_account_name = google_service_account.ingester_sa.email
      containers {
        image = "gcr.io/${var.project_id}/${var.cloud_run_job_name}:${var.image_tag}"
        env {
          name  = "GCP_PROJECT_ID"
          value = var.project_id
        }
        env {
          name  = "BQ_DATASET_ID"
          value = google_bigquery_dataset.event_dataset.dataset_id
        }
        env {
          name  = "BQ_TABLE_ID"
          value = google_bigquery_table.events_table.table_id
        }
        resources {
          limits = {
            cpu    = "1000m"
            memory = "512Mi"
          }
        }
      }
      timeout = "3600s" # 1 hour timeout for the job
      task_count = 1 # Number of parallel tasks
    }
    # This example does not define an execution template directly,
    # as it's typically triggered manually or by Cloud Scheduler.
  }
  labels = {
    env = "production"
    app = "bq-maintenance"
  }
}
IAM のベストプラクティス:
roles/bigquery.dataEditor: プロジェクト内の BigQuery テーブルへデータを書き込む権限を付与します。Storage Write API に必要最小限の権限です。roles/run.invoker:allUsersが Cloud Run サービスを呼び出せるようにします。社内向けサービスでは、特定のサービスアカウントやユーザーに限定してください。roles/pubsub.publisher: Cloud Run サービスが Pub/Sub へメッセージを publish する場合 (例えば DLQ 宛) に必要です。roles/pubsub.viewerとroles/pubsub.subscriber: Cloud Run を Pub/Sub のサブスクリプションから pull する構成にした場合に必要です (メインの例には含まれていませんが、Terraform 内ではコメントアウトされています)。
6. コストの内訳
本番システムにとって、コストの理解と最適化は最も重要なテーマの一つです。サービスごとの単価と、具体的な計算例を示します。
サービスごとの単価 (2023 年末時点の概算 | 実際の価格は必ず GCP の料金表で確認してください)
| サービス構成要素 | 単価 | 備考 |
|---|---|---|
| Cloud Run | ||
| CPU (アクティブ) | $0.00002400 / vCPU 秒 | リクエストを処理しているときのみ課金されます。 |
| CPU (アイドル) | $0.00000600 / vCPU 秒 | min-instances 用。インスタンスをウォームに保つ場合の低い単価です。 |
| メモリ (アクティブ) | $0.00000250 / GiB 秒 | リクエストを処理しているときのみ課金されます。 |
| メモリ (アイドル) | $0.000000625 / GiB 秒 | min-instances 用。 |
| リクエスト | $0.40 / 100 万リクエスト | HTTP リクエストを含みます。 |
| ネットワーク egress | 0.12 - 0.23 / GiB (ティア依存) | GCP の外へ出るデータ。 |
| Pub/Sub | ||
| メッセージ ingress/egress | $40 / TiB | 毎月 10 GiB は無料。publish/配信されたメッセージ単位で課金されます。 |
| メッセージストレージ | $10 / GiB 月 | 7 日を超えて保持されるメッセージ用 (DLQ や長期保有サブスクリプションなど)。 |
| BigQuery | ||
| Storage Write API (SA) | $0.05 / GiB | Storage Write API で書き込まれたデータ。 |
| アクティブストレージ | $0.02 / GiB 月 | アクティブストレージ内のデータ。毎月 10 GiB は無料。 |
| 長期ストレージ | $0.01 / GiB 月 | 90 日連続でアクセスされなかったデータ。 |
| オンデマンドクエリ | $6.25 / 走査 TiB | 解析クエリ用 (毎月 1 TiB は無料)。取込自体ではなく下流の用途。 |
月次計算の具体例
具体的な量を仮定してみましょう。
- データ量: 毎月 1 億件。
- イベントサイズ: イベントあたり平均 1 KB (JSON シリアライズ後)。
- Cloud Run: 1 vCPU、2 GiB RAM、
concurrency80、min-instances1、max-instances10。 - BigQuery: パーティション有効期限 90 日。
1. Cloud Run のコスト:
- リクエスト: 100,000,000 リクエスト / 1,000,000 * 0.40 = 40.00
- 処理データ量: 1 億イベント * 1 KB/イベント = 100 GiB。CPU/メモリ利用率を 50% と仮定します。
- CPU: 100 GiB / (80 req/instance * 1KB/req) * (1 vCPU * 0.5 utilization) * (req あたり平均 0.1s) * $0.000024/vCPU 秒 = ほぼゼロ (実際の計算は複雑ですが、高同時実行数かつ 1 リクエストあたりの処理量が小さい場合、CPU コストは往々にして少なくなります)
- 簡略化しましょう: 1 億リクエスト、1 リクエストあたりの平均処理時間 100ms。CPU アクティブ秒数の合計: 1 億 * 0.1s / 同時実行数 80 = 125,000 CPU 秒。
- CPU コスト: 125,000 * 0.000024 = 3.00
- メモリコスト: 125,000 * (2GiB / 3600 秒/時) * 0.00000250/GiB 秒 = 約 0.01
- アイドル状態の
min-instances(1 インスタンス、24 時間 365 日):- アイドル CPU: 1 vCPU * 24 * 30 * 3600 秒/月 * 0.000006 = 15.55
- アイドル メモリ: 2 GiB * 24 * 30 * 3600 秒/月 * 0.000000625 = 3.24
- Cloud Run 合計 (概算): 40 (リクエスト) + 3 (アクティブ CPU) + 0.01 (アクティブ メモリ) + 15.55 (アイドル CPU) + 3.24 (アイドル メモリ) = **約 61.80**
2. BigQuery Storage Write API のコスト:
- 取込データ量: 100 GiB
- コスト: 100 GiB * 0.05/GiB = **5.00**
3. BigQuery ストレージのコスト:
- 保存データ量 (アクティブ): 100 GiB/月 * 3 か月 (90 日保持のため) = 300 GiB。
- コスト (アクティブ): (300 GiB - 無料の 10 GiB) * 0.02/GiB = **5.80**
- 長期ストレージ: 90 日が過ぎるとデータは長期ストレージへ移行します。90 日で保持して失効させるなら、長期ストレージには到達しません。1 年など長く保持する場合、一部のデータが移行します。このシナリオでは、長期ストレージに達する前に失効させると仮定します。
- BigQuery ストレージ合計 (概算): 約 $5.80
4. Pub/Sub のコスト (入力として使う場合):
- データ ingress/egress: 100 GiB。最初の 10 GiB は無料。
- コスト: (100 GiB - 無料の 10 GiB) * 40/TiB = 90 GiB * 0.04/GiB = $3.60
- Pub/Sub 合計 (概算): 約 $3.60
月次推定コスト合計: 61.80 (Cloud Run) + 5.00 (BQ Write API) + 5.80 (BQ ストレージ) + 3.60 (Pub/Sub) = 約 $76.20
これは非常に粗い見積もりです。実際のコストは、処理時間、アイドル利用状況、ネットワーク egress、そして具体的な BigQuery の利用パターンに強く左右されます。
影響度の大きい順に並べたコスト最適化レバー
- BigQuery のパーティショニングとクラスタリング: 影響度 最大。 走査データを最小化することでクエリコストを削減します。解析ワークロードには必須であり、
require_partition_filterは設定しておくべきです。 - BigQuery のパーティション有効期限: 影響度 大。 古いデータを自動的に削除し、BigQuery のストレージコストを直接削減します。データ保持ポリシーと整合させてください。
- BigQuery のスキーマ最適化: 影響度 大。 適切なデータ型を使います (ID は
STRINGではなくINT64、時刻が不要な場合はTIMESTAMPではなくDATE)。不要なカラムは避けます。これによりストレージ使用量とクエリの走査コストの両方が減ります。 - Cloud Run の同時実行数: 影響度 中〜大。 高い同時実行数 (アプリが本当に非同期であれば) により、少ないインスタンスで多くのリクエストを処理でき、CPU/メモリ消費とアイドルコストの全体を削減できます。
- Cloud Run の
min-instances: 影響度 中。 コールドスタートが許容できる重要度の高くないパイプラインではmin-instances=0にすることで、アイドルコストを節約できます。低レイテンシが重要な取込では、小さい値のmin-instancesは正当化される場合が多くあります。 - Storage Write API でのバッチ化: 影響度 中。 1 回の
AppendRowsRequestでより大きな行バッチを送信すると、gRPC 呼び出しの回数とそれに伴うオーバーヘッドが減り、スループットと効率が改善する可能性があります。極小のバッチは避けてください。 - Pub/Sub メッセージの保持期間: 影響度 小〜中。 メッセージ保持期間を必要最小限に抑えます (既定の 7 日で通常は十分です)。特定の復旧要件でのみ延長してください。保持が長いほどストレージコストが発生します。
7. オブザーバビリティ、障害モード、本番運用の強化
本番パイプラインの構築には、コードだけでは足りません。堅牢な運用が必要となります。
Dead Letter Queue (DLQ)
DLQ は、正常に処理できないメッセージを隔離し、管理するために不可欠です。
- Pub/Sub の DLQ: Pub/Sub をイベントソースに使う場合、サブスクリプションに DLQ を設定してください。
max_delivery_attemptsを超えたメッセージは自動的に転送されます。 - Cloud Run アプリケーション側の DLQ: Cloud Run が直接 HTTP リクエストを受ける場合や、BigQuery への書き込み 前 に内部処理エラーが発生した場合、アプリケーション自身が失敗したイベントをログに記録し、可能であれば別の Pub/Sub DLQ トピックへ publish すべきです。
- DLQ メッセージの処理: DLQ から消費する別のプロセス (例えば Cloud Function や Cloud Run Job) を用意し、失敗を分析し、データを修正 (可能なら) した上で、再取込かアーカイブを行います。これにより、ポイズンメッセージがメインパイプラインを塞ぎ続けることを防ぎます。
スキーマドリフトへの対応
データのスキーマは進化していきます。パイプラインは、その変化に耐える必要があります。
- BigQuery のフレキシブルスキーマ: BigQuery はスキーマオンリードです。既存のテーブルに新しい nullable カラムを追加しても、既存のクエリを壊したりダウンタイムを発生させたりせずに済みます。
- アプリケーションレベルの検証: FastAPI の Pydantic モデルが厳格なスキーマ検証を提供します。
- 厳格モード: 受信したフィールドが Pydantic モデルに存在しない場合、そのリクエストは拒否されます。厳密な契約の強制に有効です。
- フレキシブルモード: Pydantic の
extra='allow'やDict[str, Any]を使って未知のフィールドを許可し、後から BigQuery のJSON型カラムへ格納できるようにします。イベントデータではこちらのほうがよく使われるケースが多くあります。
- スキーマ進化の戦略:
- 後方互換の変更: BigQuery のテーブルスキーマに新しい nullable フィールドを追加します。Pydantic モデルにも新フィールド (
Optionalとして) を追加します。 - 破壊的な変更 (リネーム、型の変更など): 可能な限り避けます。避けられない場合は、新しいテーブルを作成し、データを移行したうえで、取込先を切り替えます。
- 不正または不正形なデータ: 別の隔離 (quarantine) テーブルに保存するか、特定の DLQ へ送って人手で確認します。
- 後方互換の変更: BigQuery のテーブルスキーマに新しい nullable フィールドを追加します。Pydantic モデルにも新フィールド (
ポイズンメッセージ
ポイズンメッセージとは、再試行しても処理が失敗し続けるメッセージのことです。
- DLQ の仕組み: Pub/Sub の DLQ とアプリケーションレベルの DLQ が第一防衛線です。設定可能な回数だけ再試行した後も、そのメッセージは移動させられ、メインの処理キューを無期限に塞ぐことを防ぎます。
- 監視とアラート: DLQ のサイズを監視してください。DLQ の肥大は、ポイズンメッセージの問題あるいはシステム全体の問題を示しています。
- 分析: ポイズンメッセージを精査し、根本原因 (不正な JSON、想定外のデータ型、アプリケーションのバグなど) を把握します。
指数バックオフによるクォータと再試行のセマンティクス
GCP のサービスにはクォータがあります。上限を超えると RESOURCE_EXHAUSTED エラーになります。
- BigQuery Storage Write API のクォータ: プロジェクト/リージョンごとの QPS 上限。
- Cloud Run のクォータ: インスタンス数の上限、CPU の上限。
- 再試行ロジック: クライアント (Cloud Run レシーバ) は、指数バックオフとジッタを伴う堅牢な再試行ロジックを実装しなければなりません。
- 指数バックオフ: 再試行ごとの待機時間を指数的に増やします (例えば 1 秒、2 秒、4 秒、8 秒…)。
- ジッタ: 多数のクライアントが同時に再試行したときに、「thundering herd」問題が起きないように、小さなランダムな遅延を加えます。
- 最大再試行回数: リクエストを失敗として扱い DLQ へ送る前の、再試行回数の上限を定めます。
- クライアントライブラリ: Google Cloud のクライアントライブラリには組み込みの再試行仕組みがあることが多いですが、その設定は確認してください。
アラートと SLO
サービスレベル目標 (SLO) を定め、問題を先回りして検知できるようアラートを設定します。
- 主要メトリクス (Cloud Monitoring):
- Cloud Run:
- リクエストレイテンシ (p99、p95)
- エラー率 (5xx HTTP レスポンス)
- リクエスト数
- CPU 利用率、メモリ利用率
- インスタンス数
- BigQuery:
- Storage Write API の
append_rowsレイテンシ - Storage Write API の
append_rowsエラー数 - 取込されたデータ量
- テーブルのストレージサイズ
- Storage Write API の
- Pub/Sub (利用する場合):
- 未配信メッセージ数 (バックログサイズ)
- 最古の未確認メッセージの経過時間
- DLQ のメッセージ数
- Cloud Run:
- SLO:
- 可用性: 取込エンドポイントが 99.9% の時間利用可能 (例えば 5xx エラーが 0.1% 未満)。
- レイテンシ: P99 の取込レイテンシが 5 秒未満。
- スループット: 1 秒あたり X 件のイベントを正常に取り込めること。
- データの鮮度: イベント発生から Y 分以内に BigQuery で可視化されること。
- アラート: SLO を下回ったときに Cloud Monitoring (またはお使いのアラートシステム) でアラートが飛ぶように設定し、オンコールエンジニアに配信してください。
ランブック形式の障害表
ランブックは、よくある障害シナリオに対して明確で実行可能な手順を提供します。
| 障害シナリオ | 症状 | 調査手順 | 対処 |
|---|---|---|---|
| Cloud Run の 5xx エラー | 5xx 比率の増加、レイテンシの上昇、インスタンスクラッシュ | Cloud Run のログで例外を確認。CPU/メモリ利用率を監視。 | コードの誤りを調査。CPU/Memory の上限を引き上げ。concurrency を調整。 |
| Cloud Run が最大インスタンス数に到達 | max_instances に到達し、リクエストがキューイングまたは破棄される | リクエスト率と処理能力の対比を確認。concurrency を監視。 | max_instances を増やす (予算が許せば)。コードを高速化。 |
| BigQuery への書き込み失敗 | BigQueryWriteClient のエラー、BQ にデータの欠落 | BigQuery Storage Write API のクォータを確認。テーブルスキーマを確認。 | クォータ引き上げを依頼。アプリケーションのスキーマを修正。DLQ から失敗バッチを再処理。 |
| Pub/Sub DLQ のバックログ増加 | dlq-events-topic のメッセージ数が増加 | DLQ 内のメッセージを調査。取込アプリのログで頻出エラーを確認。 | ポイズンメッセージの原因を特定。修正をデプロイ。DLQ メッセージを再処理。 |
| BQ にデータが出てこない | テーブルが空または古い、SELECT COUNT(*) が少ない | Cloud Run のログで _write_to_bigquery_sync の成否を確認。ストリームのコミットを検証。 | finalize_write_stream と batch_commit_write_streams が呼ばれているか確認。 |
| BigQuery のクエリコストが上昇 | BigQuery のクエリ利用に対するコストアラート | クエリパターンを分析。パーティショニングやクラスタリングを使っているか確認。 | require_partition_filter を強制。クエリを最適化。スキーマをレビュー。 |
8. 本番チェックリストと結論
サーバーレス取込パイプラインを本番へ投入する前に、次の重要な観点に対応済みであることを確認してください。
本番チェックリスト
- IAM: すべてのコンポーネントに最小権限のサービスアカウントを設定する。
- ネットワーク: VPC Service Controls (セキュリティ境界として必要な場合)。
- 監視とアラート: すべての主要メトリクスと SLO に対する包括的なダッシュボードとアラート。
- ロギング: Cloud Run アプリケーションで構造化ロギングを実装し、Cloud Logging に取り込む。
- エラー処理: 指数バックオフとジッタを伴う堅牢な再試行ロジック。Dead Letter Queue (DLQ) を設定し、監視する。
- スキーマ管理: スキーマの進化と検証を扱う明確な戦略。
- 冪等性: クライアント再試行のためにアプリケーションレベルの冪等性キーを実装する。
- セキュリティ: シークレットを安全に管理する (例: Secret Manager)。ログに機密情報を出さない。
- コスト管理: 予算アラートを設定する。コスト要因を定期的にレビューする。
- 性能テスト: スケーラビリティの検証とボトルネックの特定のため、負荷テストを実施する。
- グレースフルシャットダウン: Cloud Run アプリケーションが
SIGTERMを扱い、処理中の BigQuery ストリームを確定する。 - Terraform: すべてのインフラを Terraform で定義し、レビューとバージョン管理之下にある。重要なリソースでは
deletion_protectionを有効にする。 - ドキュメント: ランブック、アーキテクチャ図、スキーマ定義が最新の状態にある。
結論と主要なトレードオフ
BigQuery と Cloud Run によるサーバーレス取込パイプラインの構築には、大きなメリットがあります。
- スケーラビリティ: 手動の介入なしに、変動する負荷へ自動的にスケールします。
- 信頼性: Pub/Sub のバッファリング、BigQuery Storage Write API の exactly-once セマンティクス、そして堅牢なエラー処理を活用できます。
- コスト効率: 従量課金モデルに加え、効率的なリソース利用と BigQuery のストレージ/クエリ最適化によって最適化されています。
- 運用負荷の削減: 管理、パッチ適用、アップグレードすべきサーバーが存在しません。
一方で、このアプローチにはトレードオフも伴います。
- 分散システムの複雑さ: サーバーレスはインフラを抽象化しますが、分散した状態、最終整合性、複雑なエラーシナリオの扱いは、注意深い設計を必要とします。
- ベンダーロックイン: GCP サービスとの深い統合は、他クラウドへの移行を難易度高くします。
- オブザーバビリティの課題: 分散システムのデバッグはモノリシックなアプリケーションより難しいことがあり、良好なトレーシングと構造化ロギングが求められます。
- コストの可視性: コスト効率は高いものの、利用パターンを注意深く監視・分析しないと、コストの把握と予測は難しくなります。
- コールドスタート:
min-instancesで緩和できますが、管理していなければコールドスタート時にレイテンシのスパイクが発生します。
これらの点を慎重に検討し、本稿で詳述した戦略を実装することで、データ分析と機械学習の取り組みを確実に支える、高度に実効性の高い本番グレードのサーバーレス取込パイプラインを構築できます。このアーキテクチャは現代のデータプラットフォームの礎であり、迅速な反復とスケーラブルなデータドリブンな意思決定を可能にします。
あわせて読みたい記事
- Terraform State Management Best Practices
- Terraform State Lock and Backend Architecture Guide
- Docker Compose for Local Development: A Complete Setup Guide
- Docker BuildKit Cache Mounts: Python uv, Go & Node.js Guide (2026)
知識を確認する(インタラクティブクイズ)
重要なビジネスアプリケーションは、BigQueryに取り込む必要がある大量かつ低レイテンシのイベントを生成します。チームは、イベントをHTTP経由でCloud Runレシーバーに直接送信するか、最初にPub/Subトピックに公開するかを議論しています。プロダクションレベルのシステムを構築するという目標を考えると、パイプラインにPub/Subを導入する主な利点は何ですか?
ブラウザで動く無料の開発者ツール
AI CLIログの整形、Cron式の作成、JWTの解析、chmod権限の計算をオフラインで実行。
関連記事
BigQueryとCloud Runによるサーバーレス分析ウェアハウス:GA4ストリームから自動SEOアラートまで
BigQuery、Google Analytics 4、Cloud Runを使って、スキーマモデリング、スケジュールされたSQL変換、アイドルコストゼロ、自動SEOクエリアラートを備えた自動サーバーレス分析ウェアハウスを構築する方法を紹介します。
続きを読む
実用的なGCPアーキテクチャガイド:実際に使うべきサービスと避けるべきもの
Google Cloud Platformの実践的な本番環境ガイド。Cloud RunがGKEを上回る理由、BigQueryとSecret Managerの活用方法、クラウド予算を食い荒らす5つの隠れたコストの罠を学びます。
続きを読む
2026年に本番で使えるPythonライブラリ完全ガイド
2026年版:Web開発(FastAPI/Django)、データ分析(Polars/pandas)、機械学習(PyTorch/scikit-learn)、LLM(Transformers/LangChain)まで、実際のプロダクションで頼れるPythonライブラリを用途別に厳選。
続きを読む