BigQueryとCloud Runによるサーバーレス分析ウェアハウス:GA4ストリームから自動SEOアラートまで


Table of Contents
トラフィックの多い技術ブログやSaaS製品を運用していると、通常、2つの不完全な分析選択肢に直面します。高価なオブザーバビリティプラットフォームに月額200ドル以上を支払うか、Google Analytics 4の分かりにくいインターフェースを手動でクリックして、どのブログ記事がランキングを落としているのかを解読しようとするかです。
しかし、より優れた、本番環境で実績のある第三の道があります。それは、生のGoogle Analytics 4イベントをBigQueryに直接ストリーミングし、毎日スケジュールされた変換を実行してクリーンな分析マートを作成し、サーバーレスのCloud RunジョブをトリガーしてCTRの異常を計算し、実用的なSEOアラートをSlackやTelegramに直接送信するというものです。
何よりも素晴らしいのは、BigQueryが毎月1TBのクエリ処理と10GBのストレージを無料で提供し、Cloud Runジョブは実行中にのみ課金され(アイドルコストは0)、クラウドスプリントが終了すれば、パイプライン全体が月額0.00ドルで運用できることです。
BigQuery Query Cost & Slot Estimator
Estimate on-demand TB pricing & compute slots before querying
Calculate BigQuery query costs across regions, partition pruning savings, and slot-hour commitments before running expensive analytical warehouse queries.
1. エンドツーエンドのパイプラインアーキテクチャ
このアーキテクチャでは、時間単位のVM料金が発生する常時稼働のPostgreSQLやClickHouseインスタンスをホストする代わりに、コンピューティングとストレージを完全に分離しています。
┌─────────────────┐       ┌─────────────────┐       ┌─────────────────────┐
│  Web / App      │       │ Google Analytics│       │ BigQuery Raw Stream │
│  (Next.js Blog) ├──────►│ 4 (GA4 Events)  ├──────►│ `analytics_xxxxxxx` │
└─────────────────┘       └─────────────────┘       │ (Partitioned Tables)│
                                                    └──────────┬──────────┘
                                                               │
                                                 Daily Scheduled Query / View
                                                               │
                                                               ▼
┌─────────────────┐       ┌─────────────────┐       ┌─────────────────────┐
│  Telegram /     │       │ Cloud Run Job   │       │ Curated Mart:       │
│  Slack Alert    │◄──────┤ (Fast Python    │◄──────┤ `daily_seo_dropoffs`│
│  (Actionable)   │       │  Anomaly Worker)│       │ (Summary Table)     │
└─────────────────┘       └─────────────────┘       └─────────────────────┘
主要コンポーネント:
- GA4ネイティブBigQueryエクスポート: Googleは、GA4からBigQueryへのネイティブでコード不要の継続的なストリーミングおよび日次エクスポートを提供しています。
- パーティション分割およびクラスタリングされたテーブル:
_PARTITIONDATEでパーティション分割され、page_pathでクラスタリングされたBigQueryテーブルにより、高価なフルテーブルスキャンを回避します。 - 日次集計ビュー: アクティブユーザー、0クリックのインプレッションページ、直帰率などの指標を計算します。
- Cloud Runジョブ (
min-instances=0): Cloud Schedulerによって毎日1回起動されます。BigQueryにクエリを実行し、異常(例: 500以上のインプレッションがあるがCTRが1%未満のページ)を評価し、簡単なレポートをプッシュしてすぐに終了します。
2. GA4のBigQueryへのネイティブエクスポートの設定
Google Analyticsの管理コンソールで:
- 管理 → プロダクトのリンク → BigQueryのリンク に移動します。
- リンクをクリックし、GCPプロジェクト(例:
project-cf6c933d-0d23-4aae-af7)を選択します。 - クラウドリージョンを選択します(コンピューティングの場所に応じて
asia-southeast1またはus-central1を選択します)。 - データストリームを設定します:
- 日次エクスポート(完全なサニタイズされたバッチテーブル)にチェックを入れます。
- ストリーミング(リアルタイムの異常検出が必要な場合は数秒以内)にチェックを入れます。
これにより、BigQueryプロジェクトにanalytics_<PROPERTY_ID>という名前のデータセットが作成され、その中にevents_YYYYMMDDとevents_intraday_YYYYMMDDという名前のテーブルが作成されます。
3. SQLデータモデリング: 価値の高いSEOクエリのモデリング
生のGA4データは、繰り返しレコード(例: event_params.keyとevent_params.value)で深くネストされています。すべてのレポートに対して生のイベントを直接クエリすると、コンピューティングクォータが無駄になります。
以下は、ネストを解除して最適化されたサマリーテーブルを作成するための本番環境用SQL変換です。
-- Create or replace curated SEO analytics table
CREATE OR REPLACE TABLE `locionic_analytics.daily_post_performance`
PARTITION BY event_date
CLUSTER BY post_slug, locale AS

WITH raw_events AS (
  SELECT
    PARSE_DATE('%Y%m%d', event_date) AS event_date,
    (SELECT value.string_value FROM UNNEST(event_params) WHERE key = 'page_location') AS full_url,
    (SELECT value.int_value FROM UNNEST(event_params) WHERE key = 'ga_session_id') AS session_id,
    user_pseudo_id,
    event_name
  FROM
    `project-cf6c933d-0d23-4aae-af7.analytics_324892182.events_*`
  WHERE
    _TABLE_SUFFIX = FORMAT_DATE('%Y%m%d', DATE_SUB(CURRENT_DATE(), INTERVAL 1 DAY))
),

parsed_pages AS (
  SELECT
    event_date,
    user_pseudo_id,
    session_id,
    REGEXP_EXTRACT(full_url, r'https?://[^/]+/([^/]+)/blog/([^/?#]+)') AS locale,
    REGEXP_EXTRACT(full_url, r'https?://[^/]+/[^/]+/blog/([^/?#]+)') AS post_slug
  FROM
    raw_events
  WHERE
    event_name = 'page_view'
    AND full_url LIKE '%/blog/%'
)

SELECT
  event_date,
  post_slug,
  COALESCE(locale, 'en') AS locale,
  COUNT(1) AS total_views,
  COUNT(DISTINCT user_pseudo_id) AS unique_readers,
  COUNT(DISTINCT session_id) AS total_sessions
FROM
  parsed_pages
WHERE
  post_slug IS NOT NULL
GROUP BY
  event_date,
  post_slug,
  locale;
4. Cloud Run異常検出ジョブ
高価なダッシュボードを実行する代わりに、軽量なPythonジョブが毎日実行され、トラフィックが急激に減少した投稿を見つけてアラートを送信します。
以下は、完全な本番スクリプト(analyzer.py)です。
import os
import json
import requests
from google.cloud import bigquery

PROJECT_ID = os.environ.get("GOOGLE_CLOUD_PROJECT", "project-cf6c933d-0d23-4aae-af7")
TELEGRAM_BOT_TOKEN = os.environ.get("TELEGRAM_BOT_TOKEN")
TELEGRAM_CHAT_ID = os.environ.get("TELEGRAM_CHAT_ID")

def run_anomaly_check():
    client = bigquery.Client(project=PROJECT_ID)

    # Identify pages where views dropped by >40% compared to 7-day average
    query = """
    WITH seven_day_stats AS (
      SELECT
        post_slug,
        AVG(total_views) AS avg_views_7d
      FROM
        `locionic_analytics.daily_post_performance`
      WHERE
        event_date BETWEEN DATE_SUB(CURRENT_DATE(), INTERVAL 8 DAY) AND DATE_SUB(CURRENT_DATE(), INTERVAL 2 DAY)
      GROUP BY post_slug
      HAVING avg_views_7d >= 10
    ),
    yesterday_stats AS (
      SELECT
        post_slug,
        total_views AS views_yesterday
      FROM
        `locionic_analytics.daily_post_performance`
      WHERE
        event_date = DATE_SUB(CURRENT_DATE(), INTERVAL 1 DAY)
    )
    SELECT
      s.post_slug,
      ROUND(s.avg_views_7d, 1) AS avg_7d,
      COALESCE(y.views_yesterday, 0) AS yesterday,
      ROUND(((COALESCE(y.views_yesterday, 0) - s.avg_views_7d) / s.avg_views_7d) * 100, 1) AS pct_change
    FROM
      seven_day_stats s
    LEFT JOIN
      yesterday_stats y ON s.post_slug = y.post_slug
    WHERE
      COALESCE(y.views_yesterday, 0) < (s.avg_views_7d * 0.6)
    ORDER BY
      pct_change ASC;
    """

    query_job = client.query(query)
    results = list(query_job.result())

    if not results:
        print("No traffic anomalies detected today.")
        return

    lines = ["⚠️ *Locionic SEO Alert: Traffic Drop Detected*"]
    for row in results:
        lines.append(f"• `{row.post_slug}`: {row.yesterday} views vs {row.avg_7d} avg ({row.pct_change}%)")

    message = "\n".join(lines)
    print(message)

    if TELEGRAM_BOT_TOKEN and TELEGRAM_CHAT_ID:
        requests.post(
            f"https://api.telegram.org/bot{TELEGRAM_BOT_TOKEN}/sendMessage",
            json={"chat_id": TELEGRAM_CHAT_ID, "text": message, "parse_mode": "Markdown"},
            timeout=10
        )

if __name__ == "__main__":
    run_anomaly_check()
5. コストガードレールとティアダウンの安全性
Google Cloudクレジットで構築する場合、クレジットの有効期限が切れた後もサービスがプロビジョニングされたままになる危険性があります。このパイプラインを永久に完全に無料で維持する方法を以下に示します。
- Cloud Runジョブとサービス:
gcloud run deployをmin-instances > 0と一緒に使用しないでください。gcloud run jobs deployを使用してください。ジョブはPythonスクリプトの実行中(通常15〜30秒)にのみCPUとメモリを割り当て、その後自動的にゼロにスケールダウンします。
- BigQuery無料枠の保護:
- BigQueryには、毎月10GBのアクティブストレージと1TBのクエリデータ処理が無料で含まれています。
- 1日あたり1,000〜10,000イベントの技術ブログの場合、年間100MB未満のストレージと月間1GB未満のクエリスキャンしか消費しません。
- パーティションプルーニング:
- クエリには常に
WHERE event_date = ...またはWHERE _PARTITIONDATE = ...を含めてください。パーティションプルーニングがないと、BigQueryはすべての履歴パーティションをスキャンし、不必要にクエリクォータを消費します。
- クエリには常に
6. まとめチェックリスト
| Dimension | Traditional Database (Cloud SQL / RDS) | Serverless Warehouse (BigQuery + Cloud Run) |
|---|---|---|
| Monthly Idle Cost | トラフィックが0でも月額30〜100ドルかかる | 月額0.00ドル(無料枠でカバー) |
| Ingestion Bottleneck | コネクションプールのチューニングが必要 | ネイティブストリーミングは数百万イベントにスケール |
| Maintenance | ストレージのアップグレード、OSパッチ、バキューム処理 | メンテナンス不要のサーバーレスエンジン |
| Post-Credit Fate | 継続的な月額料金が発生する | GCP無料枠内で永久に100%運用可能 |
ネイティブGA4ストリーミング、パーティション分割されたBigQueryデータマート、イベント駆動型Cloud Runジョブを組み合わせることで、検索ランキングを自動的に監視し、費用を一切かけずにエンタープライズグレードの分析エンジンを構築できます。
Free In-Browser Developer Tools
Clean AI CLI logs, build cron expressions, decode JWTs, and calculate chmod permissions offline.
Related Articles
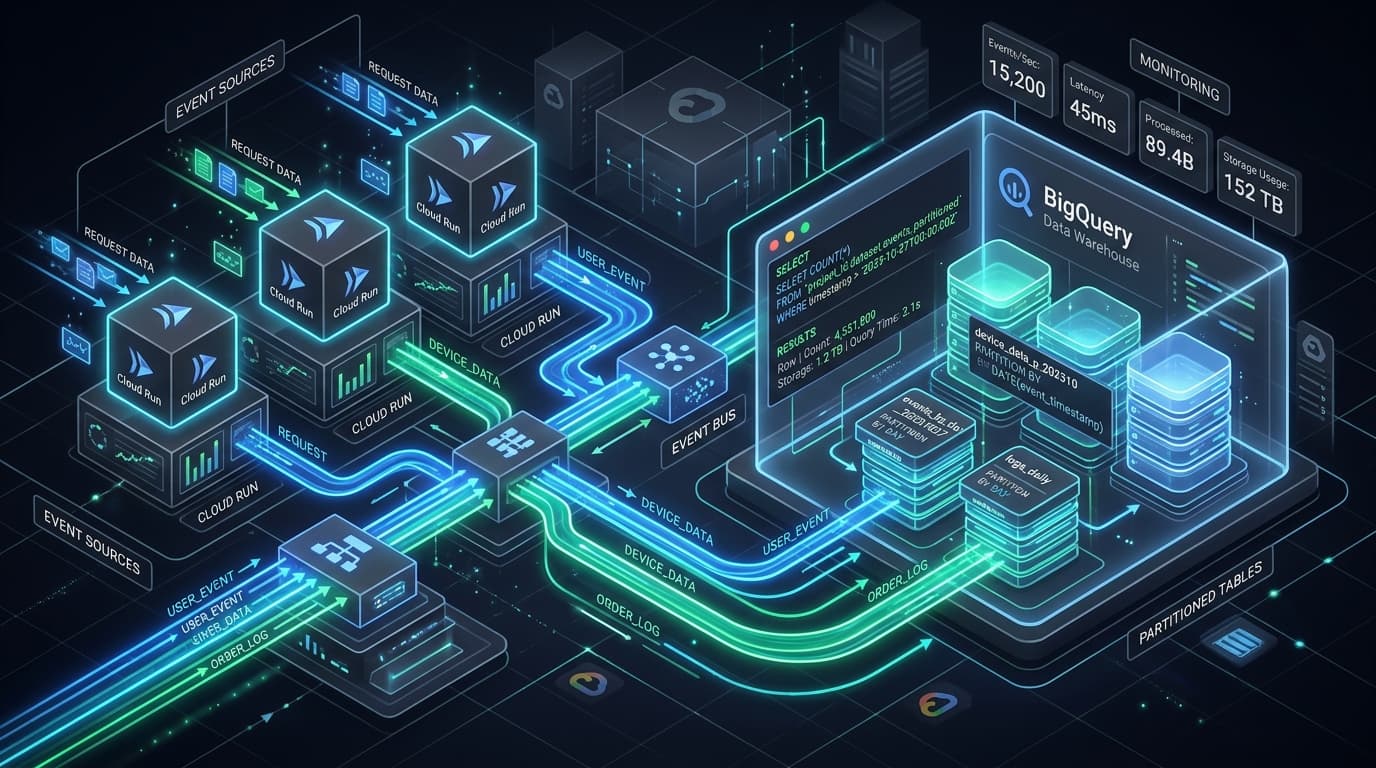
BigQuery + Cloud Run: 本番向けのサーバーレスデータ取込パイプライン構築
Google Cloud 上でサーバーレスなデータ取込を本番品質で構築する実践ガイド。BigQuery Storage Write API、パーティショニングとクラスタリングの設計、Cloud Run 上の非同期 FastAPI レシーバ、Terraform による IaC 全体、実測に基づくコスト分析、そして深夜3時に呼ばれる障害モードまで扱います。
Read more
実用的なGCPアーキテクチャガイド:実際に使うべきサービスと避けるべきもの
Google Cloud Platformの実践的な本番環境ガイド。Cloud RunがGKEを上回る理由、BigQueryとSecret Managerの活用方法、クラウド予算を食い荒らす5つの隠れたコストの罠を学びます。
Read more
Serverlessアーキテクチャの隠れた落とし穴
2026年のServerlessアーキテクチャにおけるコールドスタートレイテンシー、データベース接続枯渇、予期せぬクラウド費用といった隠れた落とし穴と、その対策について解説します。
Read more