·23 min read
Tinh chỉnh DeepSeek R1 với Unsloth & LoRA: Các mô hình suy luận tiết kiệm bộ nhớ
Hướng dẫn toàn diện về tinh chỉnh DeepSeek R1 với Unsloth & LoRA: các mô hình suy luận tiết kiệm bộ nhớ với kiến trúc cấp độ sản xuất và ví dụ mã.
Stories, tutorials, and deep dives spanning across diverse worlds.
Hướng dẫn toàn diện về tinh chỉnh DeepSeek R1 với Unsloth & LoRA: các mô hình suy luận tiết kiệm bộ nhớ với kiến trúc cấp độ sản xuất và ví dụ mã.
Hướng dẫn toàn diện về kiến trúc DeepSeek V3 chuyên sâu: Multi-Head Latent Attention (MLA), DeepSeekMoE & FP8 Mixed Precision với kiến trúc cấp độ sản xuất và ví dụ code.
Đánh giá kiến trúc của Pinecone, Qdrant, Milvus và pgvector cho các pipeline RAG sản xuất: lập chỉ mục HNSW vs IVFFlat, tìm kiếm được lọc một giai đoạn, độ trễ p95 và mức sử dụng bộ nhớ.
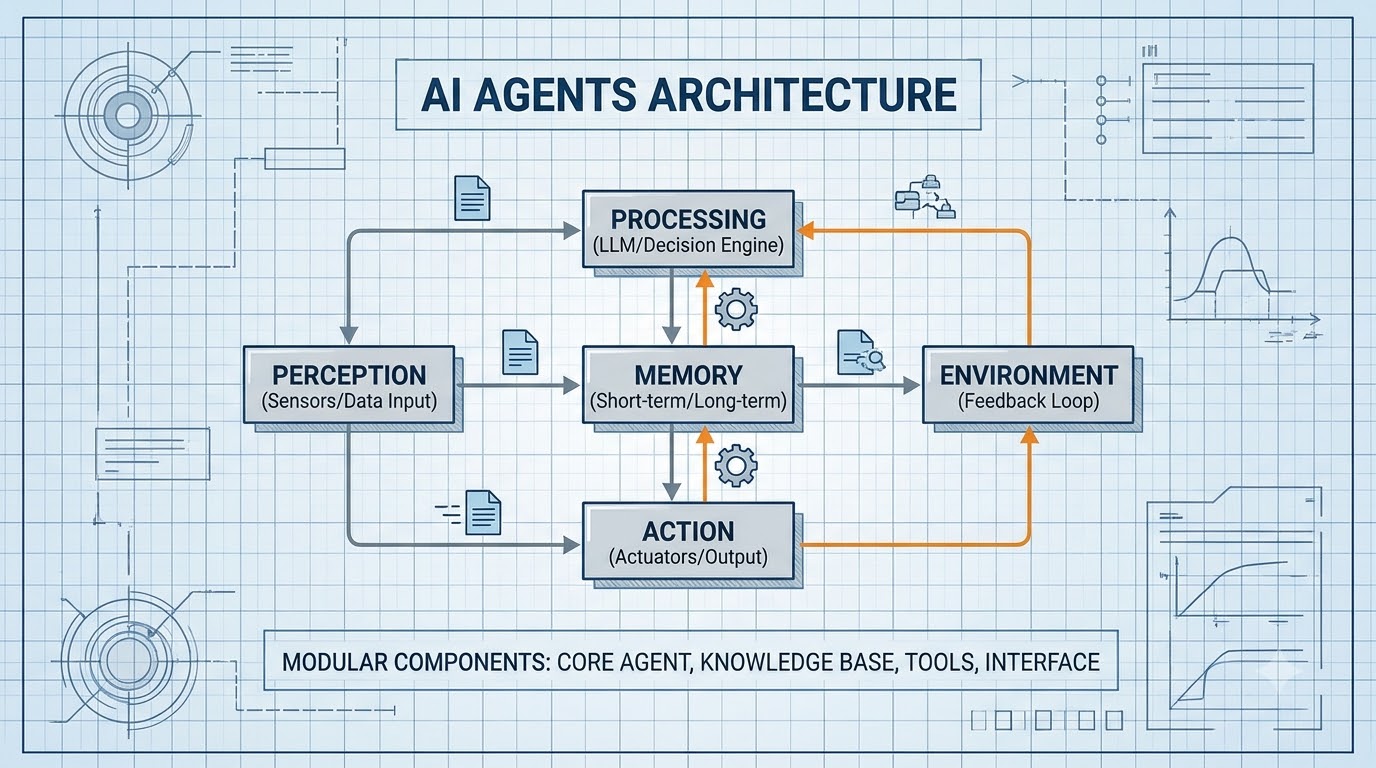
Hướng dẫn thực hành xây dựng hệ thống tác nhân AI vào năm 2026: Vòng lặp ReAct, bộ nhớ vector, các mẫu gọi công cụ, điều phối đa tác nhân và cách kiểm thử các tác nhân thất bại một cách duyên dáng.
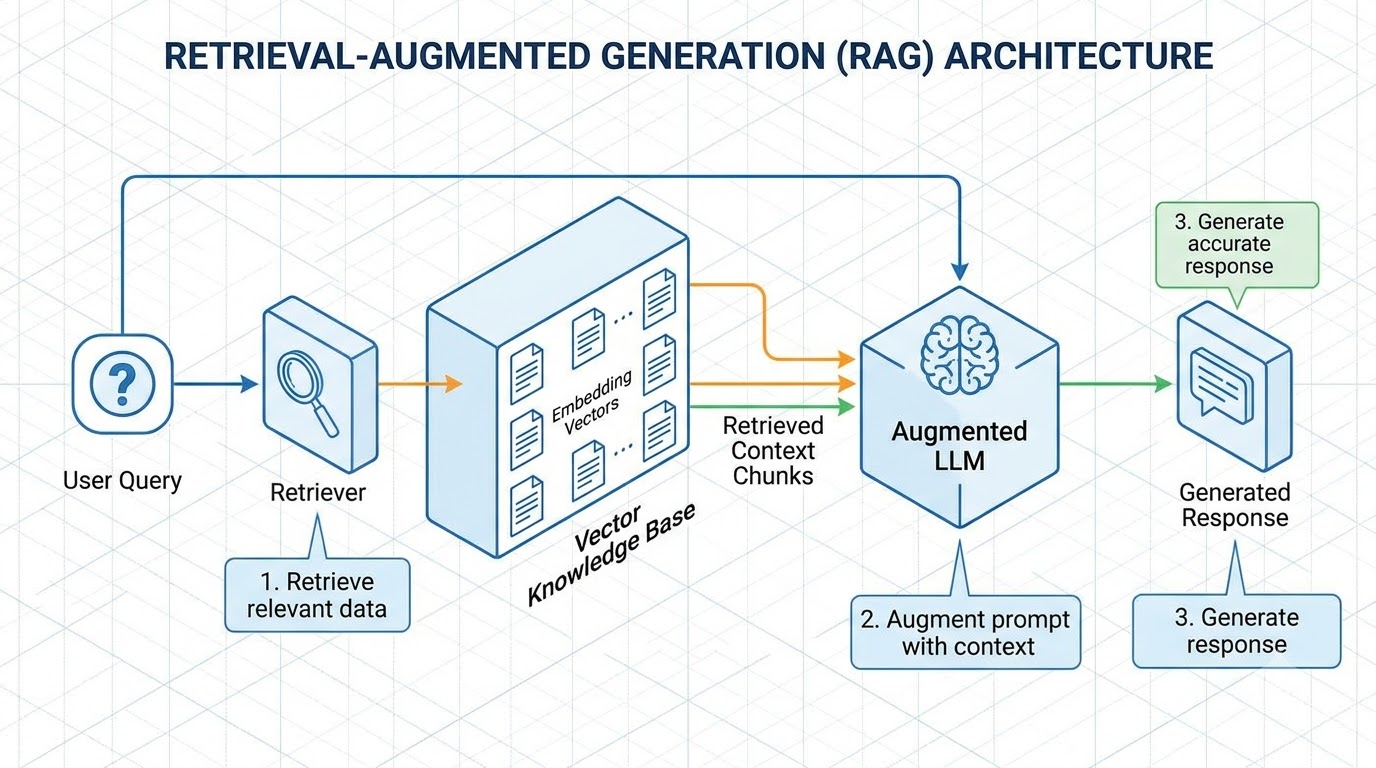
Tìm hiểu sâu về Tạo sinh tăng cường truy xuất (RAG): các chiến lược phân đoạn, nhúng vector, tìm kiếm lai dày đặc-thưa và các pipeline sắp xếp lại.
Ngừng sử dụng độ chính xác trên dữ liệu mất cân bằng: nắm vững đánh đổi Precision-Recall, điểm F-beta, ROC-AUC so với PR-AUC, hiệu chuẩn xác suất (điểm Brier & Platt scaling) và điều chỉnh ngưỡng.
Xe tự lái đang chuyển suy luận AI từ đám mây lên xe. Đây là lý do tại sao độ trễ, quyền riêng tư và an toàn không cho phép lựa chọn nào khác, cùng với các câu hỏi về quy định và xã hội đi kèm.
Những gì tôi đã học được khi xây dựng hệ thống phát hiện gian lận bằng AI sau nhiều năm áp dụng các phương pháp dựa trên quy tắc: ML thực sự hữu ích ở đâu, không hữu ích ở đâu và việc triển khai một model vào sản xuất đã dạy tôi điều gì.
Đây là danh sách các thư viện Python mà mình sẽ ưu tiên cho năm 2026, được nhóm theo đúng điểm mạnh và chọn lọc theo tiêu chí “dùng được đến khi triển khai”.