Các AI Agent trong Kỹ thuật Phần mềm: Các Mô hình Kiến trúc Thực sự Hiệu quả
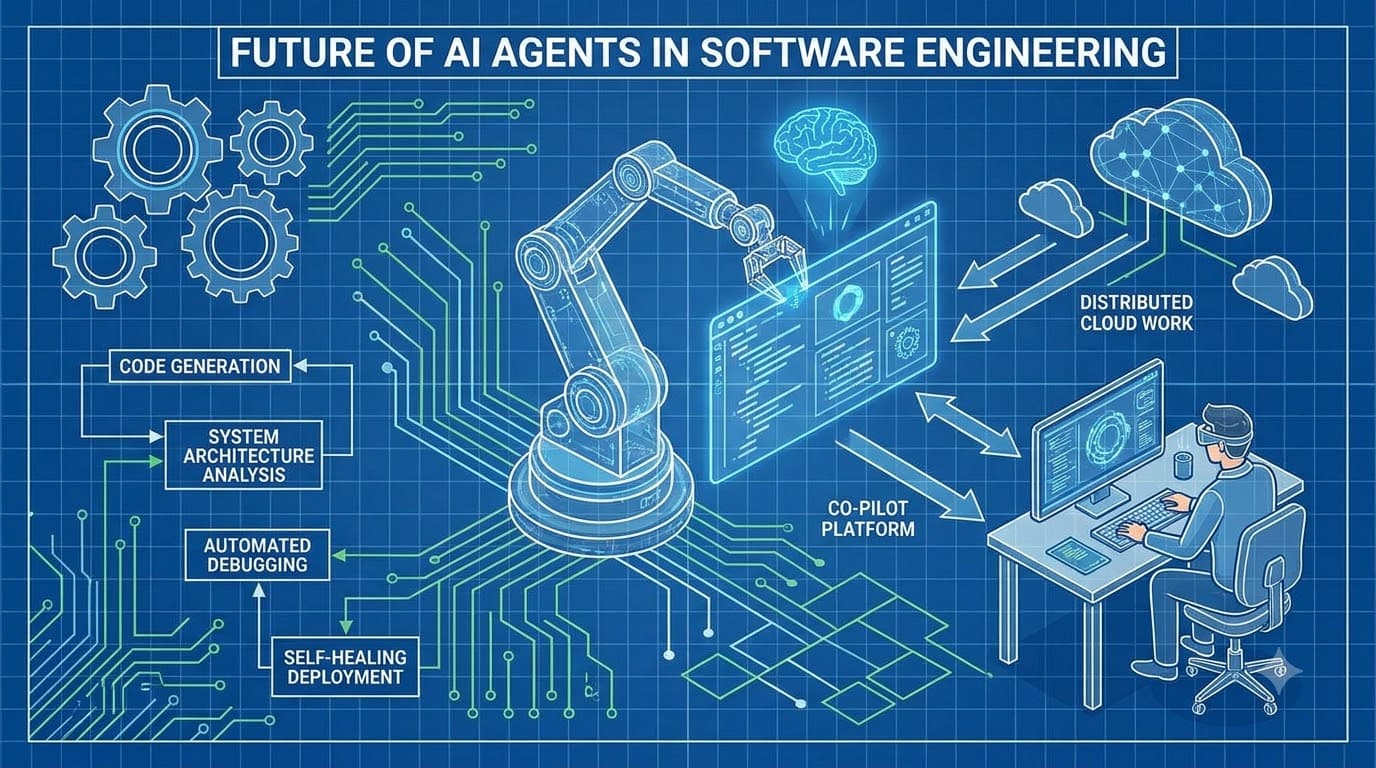

Table of Contents
Sự cường điệu xung quanh các tác nhân AI tập trung vào những gì chúng có thể làm trong tương lai. Bài đăng này tập trung vào những gì đang hoạt động hiện nay — các mẫu kiến trúc đằng sau các hệ thống tác nhân sản xuất, các chế độ lỗi mà các nhóm đang gặp phải và các quyết định về cơ sở hạ tầng bạn cần đưa ra trước khi triển khai một tác nhân tự động chống lại một codebase thực.
Điều gì làm cho một tác nhân khác biệt so với một chatbot
Một chatbot phản hồi các lời nhắc. Một tác nhân thực hiện một vòng lặp:
Observe → Think → Act → Observe (loop until goal met or budget exceeded)
Điểm khác biệt quan trọng là sử dụng công cụ có phản hồi. Một tác nhân không chỉ tạo văn bản — nó gọi các công cụ, nhận kết quả và quyết định làm gì tiếp theo dựa trên những kết quả đó. Điều này tạo ra một vòng lặp phản hồi mà một lời gọi LLM một lần không có.
Cụ thể, một tác nhân có thể:
- Đọc kết quả kiểm thử thất bại
- Tìm kiếm hàm liên quan trong codebase
- Đọc triển khai hàm
- Sửa đổi tệp
- Chạy lại các kiểm thử
- Đọc kết quả mới
- Lặp lại cho đến khi các kiểm thử vượt qua
Mỗi bước đều sử dụng công cụ. LLM quyết định gọi công cụ nào dựa trên ngữ cảnh tích lũy qua các bước. Đây là mẫu ReAct (Reasoning + Acting), được giới thiệu vào năm 2022, là nền tảng của hầu hết các hệ thống tác nhân sản xuất hiện nay.
Vòng lặp gọi công cụ
Ở cấp độ triển khai, một vòng lặp tác nhân tối thiểu trông như thế này:
import anthropic
import json
from typing import Any

client = anthropic.Anthropic()

# Define the tools the agent can use
TOOLS = [
    {
        "name": "read_file",
        "description": "Read the contents of a file",
        "input_schema": {
            "type": "object",
            "properties": {
                "path": {"type": "string", "description": "File path to read"}
            },
            "required": ["path"]
        }
    },
    {
        "name": "run_command",
        "description": "Run a shell command and return stdout/stderr",
        "input_schema": {
            "type": "object",
            "properties": {
                "command": {"type": "string", "description": "Shell command to run"}
            },
            "required": ["command"]
        }
    },
    {
        "name": "write_file",
        "description": "Write content to a file",
        "input_schema": {
            "type": "object",
            "properties": {
                "path": {"type": "string", "description": "File path"},
                "content": {"type": "string", "description": "Content to write"}
            },
            "required": ["path", "content"]
        }
    }
]

def execute_tool(tool_name: str, tool_input: dict) -> str:
    """Execute a tool and return its output as a string."""
    import subprocess
    from pathlib import Path

    if tool_name == "read_file":
        path = Path(tool_input["path"])
        if not path.exists():
            return f"Error: file {path} does not exist"
        return path.read_text()

    elif tool_name == "run_command":
        result = subprocess.run(
            tool_input["command"],
            shell=True,
            capture_output=True,
            text=True,
            timeout=30
        )
        output = result.stdout
        if result.stderr:
            output += f"\nSTDERR:\n{result.stderr}"
        return output or "(no output)"

    elif tool_name == "write_file":
        path = Path(tool_input["path"])
        path.parent.mkdir(parents=True, exist_ok=True)
        path.write_text(tool_input["content"])
        return f"Written {len(tool_input['content'])} bytes to {path}"

    return f"Unknown tool: {tool_name}"

def run_agent(task: str, max_iterations: int = 20) -> str:
    """Run an agent loop until task completion or iteration limit."""
    messages = [{"role": "user", "content": task}]

    for iteration in range(max_iterations):
        response = client.messages.create(
            model="claude-opus-4-5",
            max_tokens=4096,
            tools=TOOLS,
            messages=messages,
        )

        # Add assistant response to history
        messages.append({"role": "assistant", "content": response.content})

        # Check if agent is done
        if response.stop_reason == "end_turn":
            # Extract text response
            for block in response.content:
                if hasattr(block, "text"):
                    return block.text
            return "Task completed"

        # Process tool calls
        if response.stop_reason == "tool_use":
            tool_results = []

            for block in response.content:
                if block.type == "tool_use":
                    print(f"  → Calling {block.name}({json.dumps(block.input)[:100]})")
                    result = execute_tool(block.name, block.input)
                    tool_results.append({
                        "type": "tool_result",
                        "tool_use_id": block.id,
                        "content": result
                    })

            messages.append({"role": "user", "content": tool_results})

    return f"Reached iteration limit ({max_iterations})"
Đây là cốt lõi. Mọi thứ khác — bộ nhớ, phối hợp đa tác nhân, các rào cản an toàn — đều được xây dựng dựa trên vòng lặp này.
Giao thức ngữ cảnh mô hình (MCP): Tiêu chuẩn hóa tích hợp công cụ
Vòng lặp gọi công cụ ở trên định nghĩa các công cụ nội tuyến trong lược đồ JSON. Đối với các nhóm xây dựng nhiều tác nhân chống lại nhiều công cụ, điều này nhanh chóng trở nên lộn xộn. Mỗi tác nhân định nghĩa lại các công cụ giống nhau với các lược đồ hơi khác nhau.
Giao thức ngữ cảnh mô hình (MCP), được Anthropic giới thiệu vào cuối năm 2024, tiêu chuẩn hóa cách các tác nhân kết nối với các hệ thống bên ngoài. Thay vì nhúng định nghĩa công cụ vào mỗi lời nhắc tác nhân, các công cụ nằm trong các máy chủ MCP mà bất kỳ tác nhân tương thích nào cũng có thể truy vấn.
Agent ←→ MCP Client ←→ MCP Server (filesystem, GitHub, databases, etc.)
Một máy chủ MCP hiển thị:
- Công cụ: Các hàm mà tác nhân có thể gọi (ví dụ:
create_file,list_issues) - Tài nguyên: Dữ liệu mà tác nhân có thể đọc (ví dụ: nội dung tệp, bản ghi cơ sở dữ liệu)
- Lời nhắc: Các mẫu lời nhắc có tham số
# Example: connecting an agent to an MCP server
import asyncio
from mcp import ClientSession, StdioServerParameters
from mcp.client.stdio import stdio_client

async def run_agent_with_mcp(task: str) -> str:
    # Connect to a filesystem MCP server
    server_params = StdioServerParameters(
        command="uvx",
        args=["mcp-server-filesystem", "/workspace"]
    )

    async with stdio_client(server_params) as (read, write):
        async with ClientSession(read, write) as session:
            await session.initialize()

            # List available tools from the MCP server
            tools_result = await session.list_tools()
            tools = [t.model_dump() for t in tools_result.tools]

            # Run agent with MCP tools
            # (same loop as above, but tools come from MCP server)
            print(f"Available tools: {[t['name'] for t in tools]}")
            return "task_result"
MCP hiện được Claude, OpenAI, Gemini và hầu hết các framework tác nhân lớn hỗ trợ. Xây dựng lớp công cụ của bạn dưới dạng máy chủ MCP có nghĩa là nó hoạt động trên các nhà cung cấp mô hình.
Bộ nhớ: Phần khó nhất
Các tác nhân có bốn loại bộ nhớ, mỗi loại có những đánh đổi khác nhau:
| Loại | Lưu trữ | Truy xuất | Trường hợp sử dụng |
|---|---|---|---|
| Trong ngữ cảnh | Cửa sổ ngữ cảnh LLM | Tự động (mọi thứ trong ngữ cảnh) | Các tác vụ ngắn, vừa trong cửa sổ |
| Bên ngoài (vector) | Cơ sở dữ liệu vector | Tìm kiếm tương đồng ngữ nghĩa | Các cuộc hội thoại dài, cơ sở tri thức |
| Bên ngoài (có cấu trúc) | Kho SQL/KV | Tra cứu chính xác | Tùy chọn người dùng, trạng thái tác vụ |
| Trong trọng số | Trọng số mô hình | Tự động (được tích hợp sẵn) | Dữ liệu đào tạo, không thể sửa đổi trong thời gian chạy |
Bộ nhớ trong ngữ cảnh
Cách tiếp cận đơn giản nhất: giữ toàn bộ cuộc trò chuyện trong cửa sổ ngữ cảnh. Hoạt động cho đến khi tác vụ của bạn vượt quá giới hạn ngữ cảnh (128K–200K token cho các mô hình hiện tại).
Chiến lược nén: Khi gần đạt giới hạn, tóm tắt các lượt cũ hơn:
def compress_history(messages: list, keep_last_n: int = 10) -> list:
    """Compress old messages when approaching context limit."""
    if len(messages) <= keep_last_n:
        return messages

    # Summarize old messages
    old_messages = messages[:-keep_last_n]
    summary_prompt = f"""Summarize these agent actions and their results concisely:

{json.dumps(old_messages, indent=2)}

Summary (keep all file paths, error messages, and key decisions):"""

    summary_response = client.messages.create(
        model="claude-haiku-4-5",  # cheaper model for summarization
        max_tokens=1000,
        messages=[{"role": "user", "content": summary_prompt}]
    )

    summary = summary_response.content[0].text
    return [{"role": "user", "content": f"[Earlier context summary]: {summary}"}] + messages[-keep_last_n:]
Bộ nhớ vector
Đối với các tác vụ kéo dài nhiều phiên hoặc cần nhớ lại kiến thức trước đó, hãy lưu trữ các quan sát của tác nhân trong cơ sở dữ liệu vector:
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, VectorParams, PointStruct
import anthropic

embed_client = anthropic.Anthropic()

def store_observation(collection: str, text: str, metadata: dict) -> None:
    """Store an agent observation in vector memory."""
    # Get embedding
    response = embed_client.embeddings.create(
        model="voyage-3",
        input=[text]
    )
    vector = response.embeddings[0]

    qdrant = QdrantClient("localhost", port=6333)
    qdrant.upsert(
        collection_name=collection,
        points=[PointStruct(
            id=hash(text) % (2**32),
            vector=vector,
            payload={"text": text, **metadata}
        )]
    )

def recall_relevant(collection: str, query: str, top_k: int = 5) -> list[str]:
    """Retrieve relevant past observations for a query."""
    response = embed_client.embeddings.create(
        model="voyage-3",
        input=[query]
    )
    query_vector = response.embeddings[0]

    qdrant = QdrantClient("localhost", port=6333)
    results = qdrant.search(
        collection_name=collection,
        query_vector=query_vector,
        limit=top_k
    )

    return [r.payload["text"] for r in results]
Phối hợp đa tác nhân
Các tác nhân đơn lẻ gặp giới hạn: kích thước ngữ cảnh, độ phức tạp của tác vụ, nhu cầu chuyên môn hóa. Các kiến trúc đa tác nhân chia nhỏ công việc thành các tác nhân chuyên biệt phối hợp thông qua một trạng thái chia sẻ.
Các mẫu phổ biến:
Người điều phối → Người thực hiện: Một tác nhân chia nhỏ tác vụ, phân công các tác vụ con cho các người thực hiện chuyên biệt, tổng hợp kết quả:
def orchestrator_loop(high_level_task: str) -> str:
    """Orchestrator that delegates to specialized sub-agents."""
    subtasks = decompose_task(high_level_task)  # LLM call

    results = {}
    for subtask in subtasks:
        agent_type = route_to_agent(subtask)  # LLM call

        if agent_type == "code_writer":
            results[subtask] = run_code_agent(subtask)
        elif agent_type == "test_runner":
            results[subtask] = run_test_agent(subtask)
        elif agent_type == "reviewer":
            results[subtask] = run_review_agent(subtask)

    return aggregate_results(results)  # LLM call
Mẫu phê bình: Một tác nhân tạo ra đầu ra, một tác nhân khác phê bình nó:
def generate_with_critique(task: str, max_rounds: int = 3) -> str:
    """Generate output, critique it, revise until acceptable."""
    content = run_agent(task)  # generator agent

    for _ in range(max_rounds):
        critique = run_agent(
            f"Review this output critically:\n\n{content}\n\n"
            f"Original task: {task}\n\n"
            "List specific issues. If acceptable, say 'APPROVED'."
        )

        if "APPROVED" in critique:
            return content

        content = run_agent(
            f"Revise based on this critique:\n\n{critique}\n\n"
            f"Current content:\n\n{content}"
        )

    return content
Ranh giới an toàn: Những gì bạn phải xác định trước khi triển khai
Đây là phần mà hầu hết các hướng dẫn bỏ qua. Các tác nhân có thể sửa đổi tệp, chạy lệnh và gọi các API bên ngoài có thể gây ra thiệt hại nghiêm trọng. Xác định các ràng buộc này trước khi viết mã tác nhân:
1. Ranh giới hệ thống tệp
from pathlib import Path

ALLOWED_WRITE_PATHS = [Path("/workspace"), Path("/tmp/agent")]
FORBIDDEN_PATHS = [Path("/etc"), Path("/root"), Path.home() / ".ssh"]

def safe_write_file(path_str: str, content: str) -> str:
    path = Path(path_str).resolve()

    for forbidden in FORBIDDEN_PATHS:
        if path.is_relative_to(forbidden):
            return f"BLOCKED: cannot write to {forbidden}"

    if not any(path.is_relative_to(allowed) for allowed in ALLOWED_WRITE_PATHS):
        return f"BLOCKED: {path} is outside allowed write paths"

    path.parent.mkdir(parents=True, exist_ok=True)
    path.write_text(content)
    return f"Written to {path}"
2. Danh sách cho phép lệnh
import shlex

ALLOWED_COMMANDS = {"pytest", "ruff", "mypy", "npm", "git diff", "git status"}
FORBIDDEN_COMMAND_PREFIXES = ("rm -rf", "git push", "git reset --hard", "sudo", "curl", "wget")

def safe_run_command(command: str) -> str:
    # Check forbidden prefixes
    stripped = command.strip()
    for forbidden in FORBIDDEN_COMMAND_PREFIXES:
        if stripped.startswith(forbidden):
            return f"BLOCKED: command matches forbidden pattern '{forbidden}'"

    # Check against allowlist (optional — more restrictive)
    cmd_parts = shlex.split(stripped)
    base_cmd = cmd_parts[0] if cmd_parts else ""
    if base_cmd not in ALLOWED_COMMANDS:
        return f"BLOCKED: '{base_cmd}' not in allowed commands. Allowed: {ALLOWED_COMMANDS}"

    # Actually run
    import subprocess
    result = subprocess.run(command, shell=True, capture_output=True, text=True, timeout=60)
    return result.stdout + (f"\nSTDERR:\n{result.stderr}" if result.stderr else "")
3. Ngân sách token và lặp lại
Luôn xác định mức chi tiêu tối đa cho mỗi tác vụ. Ghi lại tất cả các lệnh gọi công cụ để kiểm tra. Cảnh báo về các mẫu bất thường (cùng một lệnh trong một vòng lặp → vấn đề tiềm ẩn).
Các chế độ lỗi thực tế
Những gì bị hỏng trong thực tế:
- Ảo giác gọi công cụ: Tác nhân gọi một công cụ với các tham số không tồn tại trong lược đồ. Khắc phục: xác thực đầu vào trước khi thực thi, trả về lỗi có cấu trúc.
- Ô nhiễm ngữ cảnh: Các thông báo lỗi cũ làm lộn xộn ngữ cảnh liên quan. Khắc phục: nén lịch sử, sử dụng kết quả công cụ có cấu trúc.
- Vòng lặp vô hạn: Tác nhân liên tục thử cùng một cách tiếp cận thất bại. Khắc phục: theo dõi các hành động đã thử, dừng lại khi có các lệnh gọi giống hệt nhau lặp lại.
- Tự tin thái quá: Tác nhân báo cáo thành công mà không xác minh. Khắc phục: luôn xác minh — chạy kiểm thử, kiểm tra nội dung tệp, không tin vào báo cáo tự thân của tác nhân.
- Mở rộng phạm vi: Tác nhân thực hiện các thay đổi "hữu ích" vượt ra ngoài tác vụ ban đầu. Khắc phục: ranh giới tác vụ rõ ràng trong lời nhắc hệ thống, các bản diff được xem xét trước khi commit.
Bạn cũng có thể thích
Free In-Browser Developer Tools
Clean AI CLI logs, build cron expressions, decode JWTs, and calculate chmod permissions offline.
Related Articles
Cơ sở dữ liệu Vector cho RAG sản xuất (2026): Pinecone vs Qdrant vs Milvus vs pgvector
Đánh giá kiến trúc của Pinecone, Qdrant, Milvus và pgvector cho các pipeline RAG sản xuất: lập chỉ mục HNSW vs IVFFlat, tìm kiếm được lọc một giai đoạn, độ trễ p95 và mức sử dụng bộ nhớ.
Read more
Kỹ thuật Phần mềm Xanh: Tối ưu hóa Tải công việc AI để Tiết kiệm Năng lượng vào năm 2026
Các chiến lược khả thi để nhà phát triển lập hồ sơ, đánh giá hiệu năng và giảm lượng khí thải carbon cũng như mức tiêu thụ điện năng trên các tải công việc AI và LLM nặng tính toán — CodeCarbon, lượng tử hóa, phân lô thông minh, dịch chuyển tải công việc theo thời gian và ngân sách carbon CI.
Read more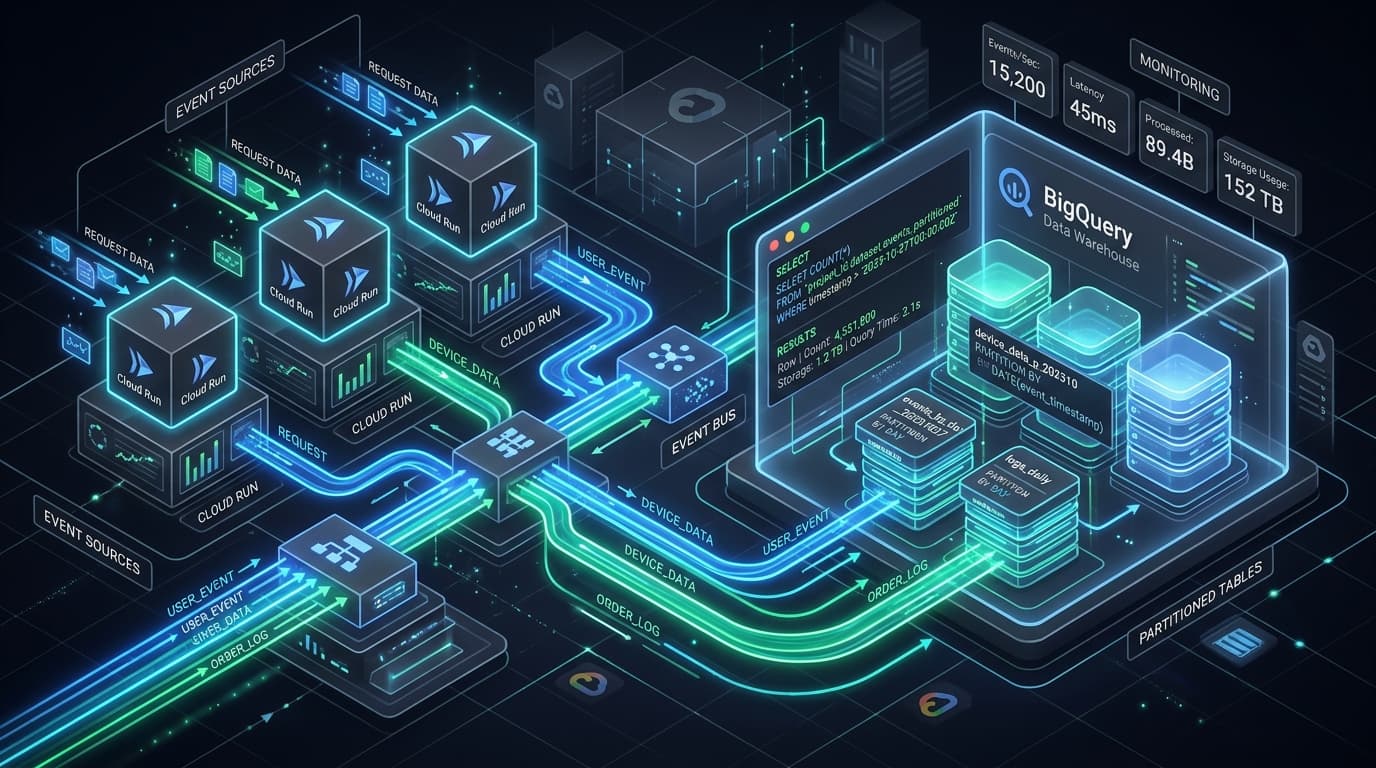
BigQuery + Cloud Run: Xây Dựng Pipeline Nhập Dữ Liệu Serverless Cho Production
Cẩm nang cấp production về nhập dữ liệu serverless trên Google Cloud: BigQuery Storage Write API, chiến lược phân vùng và phân cụm, bộ nhận FastAPI async trên Cloud Run, Terraform đầy đủ, phân tích chi phí thực tế, và những chế độ lỗi gọi bạn lúc 3 giờ sáng.
Read more