•23分で読める
pgvectorとハイブリッド検索でプロダクションRAGを構築する

Locionic(@Locionic)
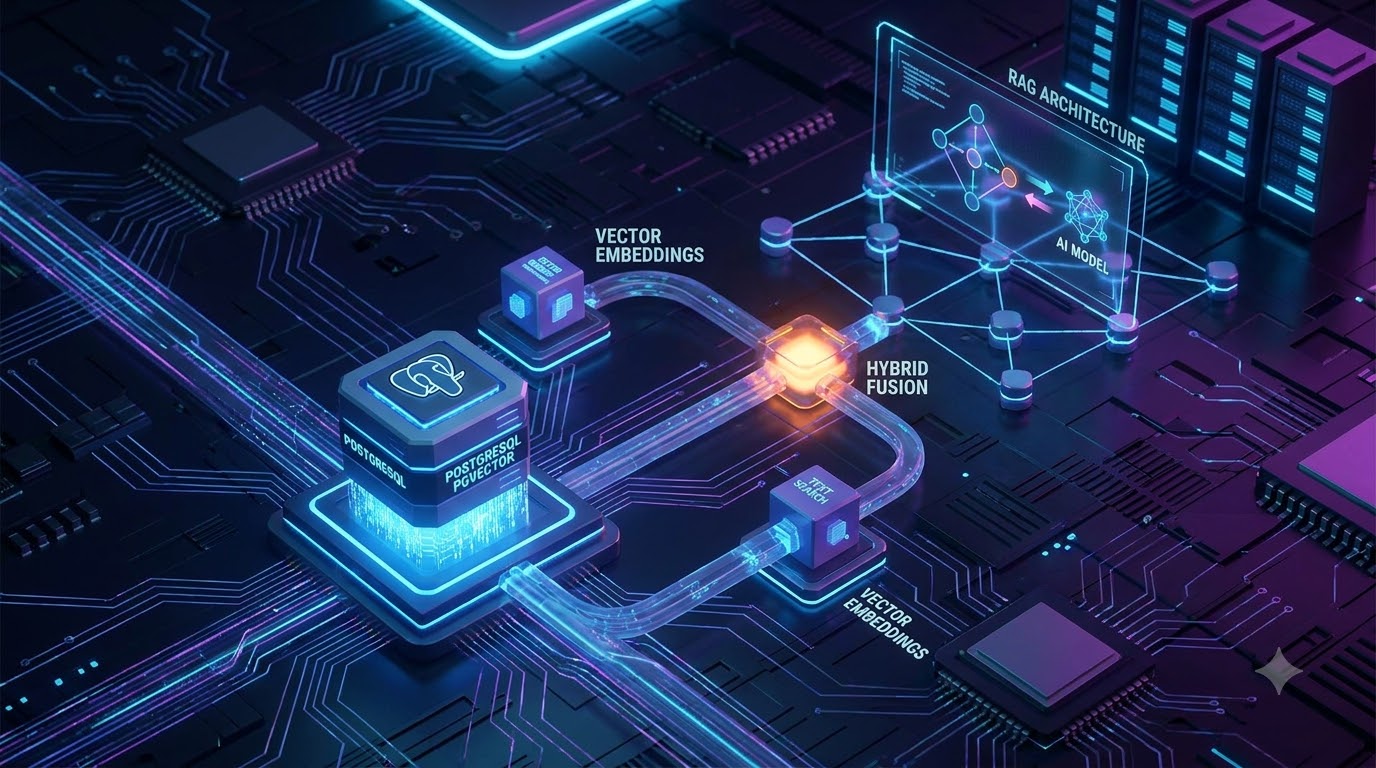
Retrieval-Augmented Generation(RAG)システムを構築する際、検索精度がすべてです。取得されたドキュメントが適切でなければ、LLMの応答も適切ではありません。ここでpgvectorハイブリッド検索が威力を発揮します。従来の全文検索とベクトル埋め込みを組み合わせることで、両方の良いところ取りができます。
このガイドでは、PostgreSQL、pgvector拡張機能、Reciprocal Rank Fusion(RRF)、および完全なPythonクライアントを使用して、本番環境に対応したRAGアーキテクチャを構築する方法を探ります。これには、HNSWチューニング、クエリプラン分析、および本番チェックリストが含まれます。
他のAIスタックコンポーネントを検討している場合は、AIツールの概要もぜひご確認ください。
Audio Briefing• Voice: Google Cloud ja-JP-Neural2-B
0:00 / --:--
Interactive Dev Tool
100% Client-Side & Privatepgvector HNSW Index RAM & Sizing Calculator
Estimate RAM usage, disk index size & maintenance_work_mem
Calculate exact RAM overhead, disk footprint, and indexing parameters (m, ef_construction) for PostgreSQL pgvector HNSW vector indexes. Compare halfvec and quantization savings.
pgvectorHNSW RAM SizingVector Searchhalfvec / int8
RAGアーキテクチャ
ハイブリッド検索RAGアーキテクチャがどのように動作するかを見てみましょう。このシステムは、セマンティックな意味のための高密度ベクトル検索と、厳密な一致のための疎なキーワード検索(BM25)という2つの並行検索を実行します。その後、Reciprocal Rank Fusion(RRF)を使用して結果をマージします。
高密度検索 vs. 疎な検索
なぜハイブリッドアプローチが必要なのでしょうか?セマンティックベクトル検索と従来のキーワードマッチングの違いを詳しく解説します。
セマンティック検索は強力ですが、ユーザーが特定のシリアル番号、頭字語、または厳密な名前を検索する場合に失敗することがあります。PostgreSQLの全文検索と組み合わせることで、厳密な用語と概念的な一致の両方を確実に捉えることができます。
Advertisement
埋め込み次元の選択
スキーマを設定する前に、埋め込みモデルを決定してください。選択した次元は永続的です。変更するには、すべてのドキュメントを再インデックス化する必要があります。
| モデル | 次元 | 注意事項 |
|---|---|---|
OpenAI text-embedding-3-small | 1536 | コストと品質のバランスが良い |
OpenAI text-embedding-3-large | 3072 | 最高品質、ストレージは2倍 |
Cohere embed-english-v3.0 | 1024 | 強力な多言語オプション |
BAAI/bge-m3 (オープンソース) | 1024 | 最高のオープンソース、セルフホスト型 |
all-MiniLM-L6-v2 | 384 | 高速、低メモリ、オンデバイスに最適 |
次元が大きいほど、微妙なセマンティッククエリでの再現率が向上しますが、ストレージと検索レイテンシーの両方でコストがかかります。ほとんどのプロダクションRAGシステムでは、1024または1536がスイートスポットです。
pgvectorのセットアップ
拡張機能の有効化
まず、データベースでpgvectorを有効にします。RDSまたはSupabaseでは、これはデフォルトで利用可能です。
sql
CREATE EXTENSION IF NOT EXISTS vector;
テーブルの作成
ドキュメント、その全文検索ベクトル(BM25用)、および埋め込みを保存するテーブルを作成します。
sql
CREATE TABLE documents (
    id          bigserial PRIMARY KEY,
    content     text      NOT NULL,
    metadata    jsonb     DEFAULT '{}',
    embedding   vector(1536),  -- match your model's dimension
    fts         tsvector  GENERATED ALWAYS AS
                  (to_tsvector('english', content)) STORED,
    created_at  timestamptz DEFAULT now()
);
HNSWインデックスの作成
HNSWは、IVFFlatよりも高速なクエリ時間と優れた再現率を提供します。m(グラフ接続性)とef_construction(構築時検索深度)をワークロードに合わせて調整します。
sql
CREATE INDEX documents_embedding_hnsw_idx
    ON documents
    USING hnsw (embedding vector_cosine_ops)
    WITH (m = 16, ef_construction = 64);
m = 16: ノードあたりの接続数 - 高いほど再現率が向上しますが、より多くのメモリを使用しますef_construction = 64: 構築時の検索深度 - 高いほどインデックス品質が向上しますが、構築に時間がかかります
全文インデックスの作成
BM25スタイルのキーワードクエリを高速化するためにGINインデックスを追加します。
sql
CREATE INDEX documents_fts_gin_idx ON documents USING GIN (fts);
クエリ時HNSWパラメータの設定
クエリ時には、hnsw.ef_searchで再現率とレイテンシーのトレードオフを制御します。値が高いほど、レイテンシーを犠牲にして再現率が向上します。
sql
SET hnsw.ef_search = 100; -- default is 40; 100 is good for production
これをセッションごと、または接続プール構成で設定します。
RRFによるハイブリッド検索の実装
Reciprocal Rank Fusionは、両方の検索からのランク付けされた結果を結合します。ベクトル検索で2位、キーワード検索で3位のドキュメントは、どちらか一方でのみ1位のドキュメントよりも高い融合スコアを獲得します。
sql
WITH vector_search AS (
  SELECT id, content, metadata,
         RANK() OVER (ORDER BY embedding <=> $1) AS rank
  FROM documents
  ORDER BY embedding <=> $1
  LIMIT 50
),
keyword_search AS (
  SELECT id, content, metadata,
         RANK() OVER (
           ORDER BY ts_rank_cd(fts, plainto_tsquery('english', $2)) DESC
         ) AS rank
  FROM documents
  WHERE fts @@ plainto_tsquery('english', $2)
  ORDER BY ts_rank_cd(fts, plainto_tsquery('english', $2)) DESC
  LIMIT 50
)
SELECT
  COALESCE(v.id, k.id)               AS id,
  COALESCE(v.content, k.content)     AS content,
  COALESCE(v.metadata, k.metadata)   AS metadata,
  (
    COALESCE(1.0 / (60 + v.rank), 0.0) +
    COALESCE(1.0 / (60 + k.rank), 0.0)
  )                                   AS rrf_score
FROM vector_search v
FULL OUTER JOIN keyword_search k ON v.id = k.id
ORDER BY rrf_score DESC
LIMIT 10;
-- $1: embedding vector, $2: query text string
分母の定数60はRRF定数kです。これは、上位ランクのドキュメントの重みを減らし、単一のリストが支配的になるのを防ぎます。元のRRF論文で使われている標準値は60です。
クエリプランの検証
本番環境にデプロイする前に、EXPLAIN ANALYZEを実行してHNSWインデックスが使用されていることを確認し、実際の行数と推定行数を比較します。
sql
EXPLAIN (ANALYZE, BUFFERS, FORMAT TEXT)
SELECT id, content, embedding <=> '[0.1, 0.2, ...]' AS dist
FROM documents
ORDER BY embedding <=> '[0.1, 0.2, ...]'
LIMIT 10;
出力でIndex Scan using documents_embedding_hnsw_idxを探してください。シーケンシャルスキャンが表示される場合、ef_searchが高すぎるか、統計情報が更新されていない可能性があります(ANALYZE documents;)。
asyncpgを使用したPythonクライアント
以下は、asyncpgとOpenAI埋め込みを使用した本番環境対応のPython実装です。
python
import asyncpg
import openai
from typing import Any

async def embed(text: str) -> list[float]:
    resp = await openai.AsyncOpenAI().embeddings.create(
        model="text-embedding-3-small",
        input=text,
    )
    return resp.data[0].embedding

async def hybrid_search(
    pool: asyncpg.Pool,
    query: str,
    limit: int = 10,
) -> list[dict[str, Any]]:
    embedding = await embed(query)
    # asyncpg expects vectors as lists of floats
    vector_str = "[" + ",".join(str(x) for x in embedding) + "]"

    rows = await pool.fetch(
        """
        WITH vector_search AS (
          SELECT id, content, metadata,
                 RANK() OVER (ORDER BY embedding <=> $1::vector) AS rank
          FROM documents ORDER BY embedding <=> $1::vector LIMIT 50
        ),
        keyword_search AS (
          SELECT id, content, metadata,
                 RANK() OVER (
                   ORDER BY ts_rank_cd(fts, plainto_tsquery('english', $2)) DESC
                 ) AS rank
          FROM documents
          WHERE fts @@ plainto_tsquery('english', $2)
          LIMIT 50
        )
        SELECT
          COALESCE(v.id, k.id)             AS id,
          COALESCE(v.content, k.content)   AS content,
          COALESCE(v.metadata, k.metadata) AS metadata,
          (COALESCE(1.0/(60+v.rank),0) + COALESCE(1.0/(60+k.rank),0)) AS score
        FROM vector_search v
        FULL OUTER JOIN keyword_search k ON v.id = k.id
        ORDER BY score DESC LIMIT $3
        """,
        vector_str,
        query,
        limit,
    )
    return [dict(r) for r in rows]
チャンキング戦略
埋め込み前にドキュメントをどのように分割するかは、インデックス構成と同じくらい重要です。チャンキングが不適切だと、2つの失敗モードが発生します。
- チャンクが小さすぎる: 埋め込みが概念の一部しか捉えられず、セマンティック検索が文脈を見逃す。
- チャンクが大きすぎる: 単一のチャンクが関連性を希薄化させる - 2,000トークンの中に埋もれた1つの関連する文。
| 戦略 | チャンクサイズ | オーバーラップ | 最適な用途 |
|---|---|---|---|
| 固定トークン | 512トークン | 50トークン | 汎用、実装が簡単 |
| 文境界 | 3-5文 | 1文 | 会話型ドキュメント、QAシステム |
| 段落境界 | 1段落 | - | ブログ記事、記事 |
| セマンティックチャンキング | 可変 | - | 論理的なセクションを持つ長い技術文書 |
ほとんどのRAGアプリケーションでは、50トークンのオーバーラップを持つ512トークンが堅実な出発点となります。オーバーラップにより、チャンク境界をまたいで分割された概念が、少なくとも1つのチャンクのコンテキストウィンドウに確実に表示されます。
オプション: クロスエンコーダによる再ランキング
RRFは優れたフューザーですが、クエリとドキュメントの関係を理解していません。ランキングを結合するだけです。医療、法律、金融などの重要なRAGの場合、検索後にクロスエンコーダによる再ランキングステップを追加します。
python
from sentence_transformers import CrossEncoder

reranker = CrossEncoder('cross-encoder/ms-marco-MiniLM-L-6-v2')

def rerank(query: str, docs: list[dict]) -> list[dict]:
    pairs = [(query, d['content']) for d in docs]
    scores = reranker.predict(pairs)
    ranked = sorted(zip(docs, scores), key=lambda x: x[1], reverse=True)
    return [d for d, _ in ranked]
クロスエンコーダはバイエンコーダよりも遅いため(各クエリとドキュメントのペアを同時に処理するため)、ハイブリッド検索からの上位20〜50件の結果のみを再ランキングし、その後上位5〜10件をLLMに渡します。
知識を確認する(インタラクティブクイズ)
Interactive Quiz
Question 1 of 2
pgvectorとハイブリッド検索を使用するRAGシステムがデプロイされています。ユーザーは、非常に具体的な製品SKU(例: 'XYZ-9000-PRO')と概念的なクエリ(例: 'ネットワーク問題のトラブルシューティング')の両方を頻繁に検索します。初期デプロイ後、一部のユーザーから、SKUの検索が、ドキュメントコーパスにSKUが存在するにもかかわらず、無関係なドキュメントを返すことがあると報告されています。最も可能性の高い原因と、SKUの検索を改善するための最善の即時対策は何ですか?
FAQ
本番チェックリスト
ハイブリッドRAGパイプラインを稼働させる前に:
- ☑ 接続プールで
hnsw.ef_search = 100(またはそれ以上)を設定する - デフォルトの40では再現率が犠牲になりすぎる - ☑
EXPLAIN ANALYZEでHNSWインデックスが使用されていることをクエリプランで確認する - ☑ 大量挿入後に
VACUUM ANALYZE documentsを実行して統計情報を更新する - ☑ 検索後のフィルタリングのために
metadata(ソースURL、セクション、日付)をjsonbに保存する - ☑ ランキング前にソースでフィルタリングするために
WHERE metadata @> '{"source": "docs"}'::jsonbを追加する - ☑ オブザーバビリティスタックで、埋め込みAPIのレイテンシーをDBクエリのレイテンシーとは別に監視する
- ☑ 遅いクエリがLLMパイプラインをブロックしないように、ハイブリッド検索クエリに
statement_timeoutを設定する - ☑
asyncpg接続プールを使用する(最小2、最大20) - リクエストごとに新しい接続を作成しない
これらの方法を組み合わせて、一貫性のあるPostgreSQLハイブリッド検索RAGパイプラインを構築することで、AIアプリケーションの精度と信頼性を劇的に向上させることができます。
こちらもおすすめ
この記事を共有:
開発者ユーティリティ
ブラウザで動く無料の開発者ツール
AI CLIログの整形、Cron式の作成、JWTの解析、chmod権限の計算をオフラインで実行。
Advertisement
関連記事
postgresql
pgvectorを本番環境で使う: PostgreSQLでの高スケールベクトル検索とハイブリッドRRF
PostgreSQLでpgvectorを本番運用するためのガイド:HNSWとIVFFlatインデックスの比較、パラメータチューニング、RRFによるハイブリッド全文検索、メタデータフィルタリングについて解説します。
続きを読む
database
大規模なpgvectorとQdrantの比較:メモリオーバーヘッド、HNSWリコール、テールレイテンシ(2026年)
大規模なpgvectorとQdrantの比較について、メモリオーバーヘッド、HNSWリコール、テールレイテンシ(2026年)を網羅した包括的なガイドで、本番環境レベルのアーキテクチャとコード例を紹介します。
続きを読む
ai
大規模ベクトル検索:pgvectorとSQLite-vecにおけるHNSW対IVFFlatインデックス
pgvectorとsqlite-vecにおけるHNSWとIVFFlatベクトルインデックスアルゴリズムを比較。再現率、構築時間、メモリフットプリント、クエリレイテンシを分析します。
続きを読む