Xây dựng RAG sản xuất với pgvector & Hybrid Search
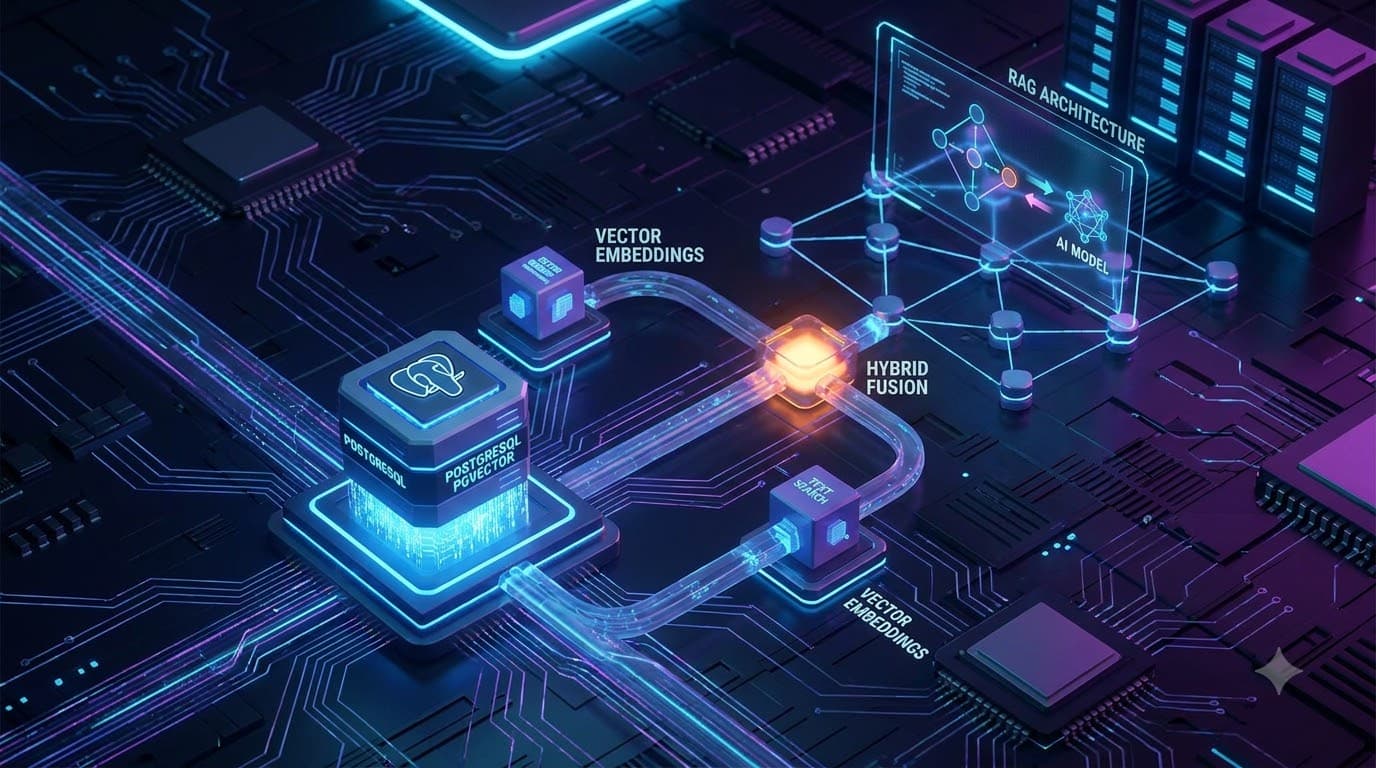

Table of Contents
Khi xây dựng hệ thống Retrieval-Augmented Generation (RAG), độ chính xác của việc truy xuất là tất cả. Nếu các tài liệu được truy xuất không liên quan, phản hồi của LLM của bạn cũng sẽ không liên quan. Đây là lúc tìm kiếm lai pgvector phát huy tác dụng. Bằng cách kết hợp tìm kiếm toàn văn truyền thống với nhúng vector, bạn sẽ có được những điều tốt nhất của cả hai thế giới.
Trong hướng dẫn này, chúng ta sẽ khám phá cách xây dựng kiến trúc RAG sẵn sàng cho sản xuất bằng cách sử dụng PostgreSQL, tiện ích mở rộng pgvector, Reciprocal Rank Fusion (RRF) và một client Python hoàn chỉnh — bao gồm điều chỉnh HNSW, phân tích kế hoạch truy vấn và danh sách kiểm tra sản xuất.
Nếu bạn đang khám phá các thành phần ngăn xếp AI khác, hãy nhớ xem tổng quan của chúng tôi về Công cụ AI.
Kiến trúc RAG
Hãy cùng xem kiến trúc RAG tìm kiếm lai hoạt động như thế nào. Hệ thống thực hiện hai tìm kiếm song song: tìm kiếm vector dày đặc cho ý nghĩa ngữ nghĩa và tìm kiếm từ khóa thưa thớt (BM25) cho các kết quả khớp chính xác. Sau đó, nó hợp nhất các kết quả bằng cách sử dụng Reciprocal Rank Fusion (RRF).
Tìm kiếm dày đặc so với tìm kiếm thưa thớt
Tại sao chúng ta cần một phương pháp tiếp cận lai? Hãy phân tích sự khác biệt giữa tìm kiếm vector ngữ nghĩa và khớp từ khóa truyền thống.
Mặc dù tìm kiếm ngữ nghĩa rất mạnh mẽ, nhưng đôi khi nó thất bại khi người dùng tìm kiếm số sê-ri, từ viết tắt hoặc tên chính xác cụ thể. Kết hợp nó với tìm kiếm toàn văn PostgreSQL đảm bảo bạn nắm bắt cả các thuật ngữ chính xác và các kết quả khớp khái niệm.
Chọn kích thước nhúng của bạn
Trước khi thiết lập lược đồ, hãy quyết định mô hình nhúng của bạn. Kích thước bạn chọn là vĩnh viễn — thay đổi nó yêu cầu lập chỉ mục lại tất cả các tài liệu.
| Mô hình | Kích thước | Ghi chú |
|---|---|---|
OpenAI text-embedding-3-small | 1536 | Cân bằng tốt giữa chi phí và chất lượng |
OpenAI text-embedding-3-large | 3072 | Chất lượng cao nhất, dung lượng lưu trữ gấp 2 lần |
Cohere embed-english-v3.0 | 1024 | Tùy chọn đa ngôn ngữ mạnh mẽ |
BAAI/bge-m3 (mã nguồn mở) | 1024 | Mã nguồn mở tốt nhất, tự lưu trữ |
all-MiniLM-L6-v2 | 384 | Nhanh, ít bộ nhớ, tốt cho thiết bị |
Kích thước lớn hơn cải thiện khả năng thu hồi trên các truy vấn ngữ nghĩa sắc thái nhưng tốn kém hơn cả về lưu trữ và độ trễ tìm kiếm. Đối với hầu hết các hệ thống RAG sản xuất, 1024 hoặc 1536 là điểm tối ưu.
Thiết lập pgvector
Bật tiện ích mở rộng
Đầu tiên, bật pgvector trong cơ sở dữ liệu của bạn. Trên RDS hoặc Supabase, điều này có sẵn theo mặc định.
CREATE EXTENSION IF NOT EXISTS vector;
Tạo bảng
Tạo một bảng lưu trữ các tài liệu của bạn, các vector tìm kiếm toàn văn của chúng (cho BM25) và các nhúng của chúng.
CREATE TABLE documents (
    id          bigserial PRIMARY KEY,
    content     text      NOT NULL,
    metadata    jsonb     DEFAULT '{}',
    embedding   vector(1536),  -- match your model's dimension
    fts         tsvector  GENERATED ALWAYS AS
                  (to_tsvector('english', content)) STORED,
    created_at  timestamptz DEFAULT now()
);
Tạo chỉ mục HNSW
HNSW cung cấp thời gian truy vấn nhanh hơn và khả năng thu hồi tốt hơn IVFFlat. Điều chỉnh m (kết nối đồ thị) và ef_construction (độ sâu tìm kiếm thời gian xây dựng) để phù hợp với khối lượng công việc của bạn.
CREATE INDEX documents_embedding_hnsw_idx
    ON documents
    USING hnsw (embedding vector_cosine_ops)
    WITH (m = 16, ef_construction = 64);
m = 16: số kết nối trên mỗi nút — cao hơn cải thiện khả năng thu hồi nhưng sử dụng nhiều bộ nhớ hơnef_construction = 64: độ sâu tìm kiếm tại thời điểm xây dựng — cao hơn cải thiện chất lượng chỉ mục, xây dựng chậm hơn
Tạo chỉ mục toàn văn
Thêm chỉ mục GIN để tăng tốc các truy vấn từ khóa kiểu BM25.
CREATE INDEX documents_fts_gin_idx ON documents USING GIN (fts);
Đặt tham số HNSW thời gian truy vấn
Tại thời điểm truy vấn, kiểm soát sự đánh đổi giữa khả năng thu hồi và độ trễ với hnsw.ef_search. Giá trị cao hơn cải thiện khả năng thu hồi với chi phí độ trễ.
SET hnsw.ef_search = 100; -- default is 40; 100 is good for production
Đặt giá trị này cho mỗi phiên hoặc trong cấu hình nhóm kết nối của bạn.
Triển khai tìm kiếm lai với RRF
Reciprocal Rank Fusion kết hợp các kết quả được xếp hạng từ cả hai tìm kiếm. Một tài liệu xếp hạng #2 trong tìm kiếm vector và #3 trong tìm kiếm từ khóa sẽ nhận được điểm hợp nhất cao hơn so với một tài liệu xếp hạng #1 chỉ trong một trong số đó.
WITH vector_search AS (
  SELECT id, content, metadata,
         RANK() OVER (ORDER BY embedding <=> $1) AS rank
  FROM documents
  ORDER BY embedding <=> $1
  LIMIT 50
),
keyword_search AS (
  SELECT id, content, metadata,
         RANK() OVER (
           ORDER BY ts_rank_cd(fts, plainto_tsquery('english', $2)) DESC
         ) AS rank
  FROM documents
  WHERE fts @@ plainto_tsquery('english', $2)
  ORDER BY ts_rank_cd(fts, plainto_tsquery('english', $2)) DESC
  LIMIT 50
)
SELECT
  COALESCE(v.id, k.id)               AS id,
  COALESCE(v.content, k.content)     AS content,
  COALESCE(v.metadata, k.metadata)   AS metadata,
  (
    COALESCE(1.0 / (60 + v.rank), 0.0) +
    COALESCE(1.0 / (60 + k.rank), 0.0)
  )                                   AS rrf_score
FROM vector_search v
FULL OUTER JOIN keyword_search k ON v.id = k.id
ORDER BY rrf_score DESC
LIMIT 10;
-- $1: embedding vector, $2: query text string
Hằng số 60 trong mẫu số là hằng số RRF k — nó làm giảm trọng số của các tài liệu được xếp hạng cao nhất và ngăn bất kỳ danh sách nào thống trị. Giá trị 60 là tiêu chuẩn được sử dụng trong bài báo RRF gốc.
Xác minh kế hoạch truy vấn của bạn
Trước khi đưa vào sản xuất, hãy chạy EXPLAIN ANALYZE để xác nhận chỉ mục HNSW đang được sử dụng và kiểm tra số hàng thực tế so với ước tính:
EXPLAIN (ANALYZE, BUFFERS, FORMAT TEXT)
SELECT id, content, embedding <=> '[0.1, 0.2, ...]' AS dist
FROM documents
ORDER BY embedding <=> '[0.1, 0.2, ...]'
LIMIT 10;
Tìm Index Scan using documents_embedding_hnsw_idx trong đầu ra. Nếu bạn thấy một lần quét tuần tự thay vào đó, ef_search của bạn có thể quá cao hoặc số liệu thống kê cần được cập nhật (ANALYZE documents;).
Client Python với asyncpg
Đây là một triển khai Python cấp sản xuất sử dụng asyncpg và nhúng OpenAI:
import asyncpg
import openai
from typing import Any

async def embed(text: str) -> list[float]:
    resp = await openai.AsyncOpenAI().embeddings.create(
        model="text-embedding-3-small",
        input=text,
    )
    return resp.data[0].embedding

async def hybrid_search(
    pool: asyncpg.Pool,
    query: str,
    limit: int = 10,
) -> list[dict[str, Any]]:
    embedding = await embed(query)
    # asyncpg expects vectors as lists of floats
    vector_str = "[" + ",".join(str(x) for x in embedding) + "]"

    rows = await pool.fetch(
        """
        WITH vector_search AS (
          SELECT id, content, metadata,
                 RANK() OVER (ORDER BY embedding <=> $1::vector) AS rank
          FROM documents ORDER BY embedding <=> $1::vector LIMIT 50
        ),
        keyword_search AS (
          SELECT id, content, metadata,
                 RANK() OVER (
                   ORDER BY ts_rank_cd(fts, plainto_tsquery('english', $2)) DESC
                 ) AS rank
          FROM documents
          WHERE fts @@ plainto_tsquery('english', $2)
          LIMIT 50
        )
        SELECT
          COALESCE(v.id, k.id)             AS id,
          COALESCE(v.content, k.content)   AS content,
          COALESCE(v.metadata, k.metadata) AS metadata,
          (COALESCE(1.0/(60+v.rank),0) + COALESCE(1.0/(60+k.rank),0)) AS score
        FROM vector_search v
        FULL OUTER JOIN keyword_search k ON v.id = k.id
        ORDER BY score DESC LIMIT $3
        """,
        vector_str,
        query,
        limit,
    )
    return [dict(r) for r in rows]
Chiến lược phân đoạn
Cách bạn chia tài liệu của mình trước khi nhúng cũng quan trọng như cấu hình chỉ mục. Phân đoạn kém gây ra hai chế độ lỗi:
- Các phân đoạn quá nhỏ: Nhúng chỉ nắm bắt một phần của khái niệm, tìm kiếm ngữ nghĩa bỏ lỡ ngữ cảnh.
- Các phân đoạn quá lớn: Một phân đoạn duy nhất làm loãng mức độ liên quan — một câu liên quan bị chôn vùi trong 2.000 token.
| Chiến lược | Kích thước phân đoạn | Chồng chéo | Tốt nhất cho |
|---|---|---|---|
| Token cố định | 512 token | 50 token | Mục đích chung, dễ triển khai |
| Ranh giới câu | 3-5 câu | 1 câu | Tài liệu đàm thoại, hệ thống QA |
| Ranh giới đoạn văn | 1 đoạn văn | — | Bài đăng trên blog, bài viết |
| Phân đoạn ngữ nghĩa | Biến đổi | — | Tài liệu kỹ thuật dài với các phần logic |
Đối với hầu hết các ứng dụng RAG, 512 token với 50 token chồng chéo là một điểm khởi đầu vững chắc. Chồng chéo đảm bảo một khái niệm được chia trên ranh giới phân đoạn vẫn xuất hiện trong ngữ cảnh của ít nhất một phân đoạn.
Tùy chọn: Xếp hạng lại với bộ mã hóa chéo
RRF là một bộ hợp nhất tốt, nhưng nó không hiểu mối quan hệ truy vấn-tài liệu — nó chỉ kết hợp các xếp hạng. Đối với RAG có tính rủi ro cao (y tế, pháp lý, tài chính), hãy thêm bước xếp hạng lại bộ mã hóa chéo sau khi truy xuất:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder('cross-encoder/ms-marco-MiniLM-L-6-v2')

def rerank(query: str, docs: list[dict]) -> list[dict]:
    pairs = [(query, d['content']) for d in docs]
    scores = reranker.predict(pairs)
    ranked = sorted(zip(docs, scores), key=lambda x: x[1], reverse=True)
    return [d for d, _ in ranked]
Bộ mã hóa chéo chậm hơn bộ mã hóa hai chiều (chúng xử lý từng cặp truy vấn-tài liệu cùng nhau), vì vậy chỉ xếp hạng lại 20-50 kết quả hàng đầu từ tìm kiếm lai, sau đó chuyển 5-10 kết quả hàng đầu cho LLM.
Câu hỏi thường gặp
Danh sách kiểm tra sản xuất
Trước khi đưa pipeline RAG lai của bạn vào hoạt động:
- ☑ Đặt
hnsw.ef_search = 100(hoặc cao hơn) trên nhóm kết nối của bạn — mặc định 40 làm mất quá nhiều khả năng thu hồi - ☑ Xác minh kế hoạch truy vấn sử dụng chỉ mục HNSW với
EXPLAIN ANALYZE - ☑ Chạy
VACUUM ANALYZE documentssau khi chèn hàng loạt để cập nhật số liệu thống kê - ☑ Lưu trữ
metadata(URL nguồn, phần, ngày) trongjsonbđể lọc sau khi truy xuất - ☑ Thêm
WHERE metadata @> '{"source": "docs"}'::jsonbđể lọc theo nguồn trước khi xếp hạng - ☑ Giám sát độ trễ API nhúng riêng biệt với độ trễ truy vấn DB trong ngăn xếp quan sát của bạn
- ☑ Đặt
statement_timeouttrên các truy vấn tìm kiếm lai để tránh các truy vấn chậm chặn pipeline LLM của bạn - ☑ Sử dụng nhóm kết nối
asyncpg(tối thiểu 2, tối đa 20) — tránh tạo kết nối mới cho mỗi yêu cầu
Bằng cách kết hợp các phương pháp này vào một pipeline RAG tìm kiếm lai PostgreSQL gắn kết, bạn cải thiện đáng kể độ chính xác và độ tin cậy của ứng dụng AI của mình.
Bạn cũng có thể thích
Free In-Browser Developer Tools
Clean AI CLI logs, build cron expressions, decode JWTs, and calculate chmod permissions offline.
Related Articles
PostgreSQL Vacuum & Bloat Index: Phát hiện, Giảm thiểu và Tinh chỉnh Tự động
Chẩn đoán và loại bỏ tình trạng phình (bloat) bảng và index trong PostgreSQL. Nắm vững các công thức tinh chỉnh autovacuum, nén dữ liệu không downtime với pg_repack, và cơ chế visibility map của MVCC.
Read more
SQLite trong Môi trường Production: Chế độ WAL, Chịu tải cao, và các PRAGMA đã được kiểm chứng
Làm chủ SQLite trong môi trường production có lưu lượng truy cập cao. Tìm hiểu về Write-Ahead Logging (WAL), tinh chỉnh busy timeout, giới hạn đọc/ghi đồng thời, và các benchmark thực tiễn.
Read moreTìm kiếm Vector ở quy mô lớn: So sánh Chỉ mục HNSW và IVFFlat trong pgvector và SQLite-vec
So sánh các thuật toán chỉ mục vector HNSW và IVFFlat trong pgvector và sqlite-vec. Phân tích độ chính xác recall, thời gian xây dựng, dung lượng bộ nhớ và độ trễ truy vấn.
Read more