•23 phút đọc
Kiến trúc Kafka Tiered Storage: Giảm chi phí lưu trữ EBS với AWS S3 & Google Cloud Storage

Locionic(@Locionic)
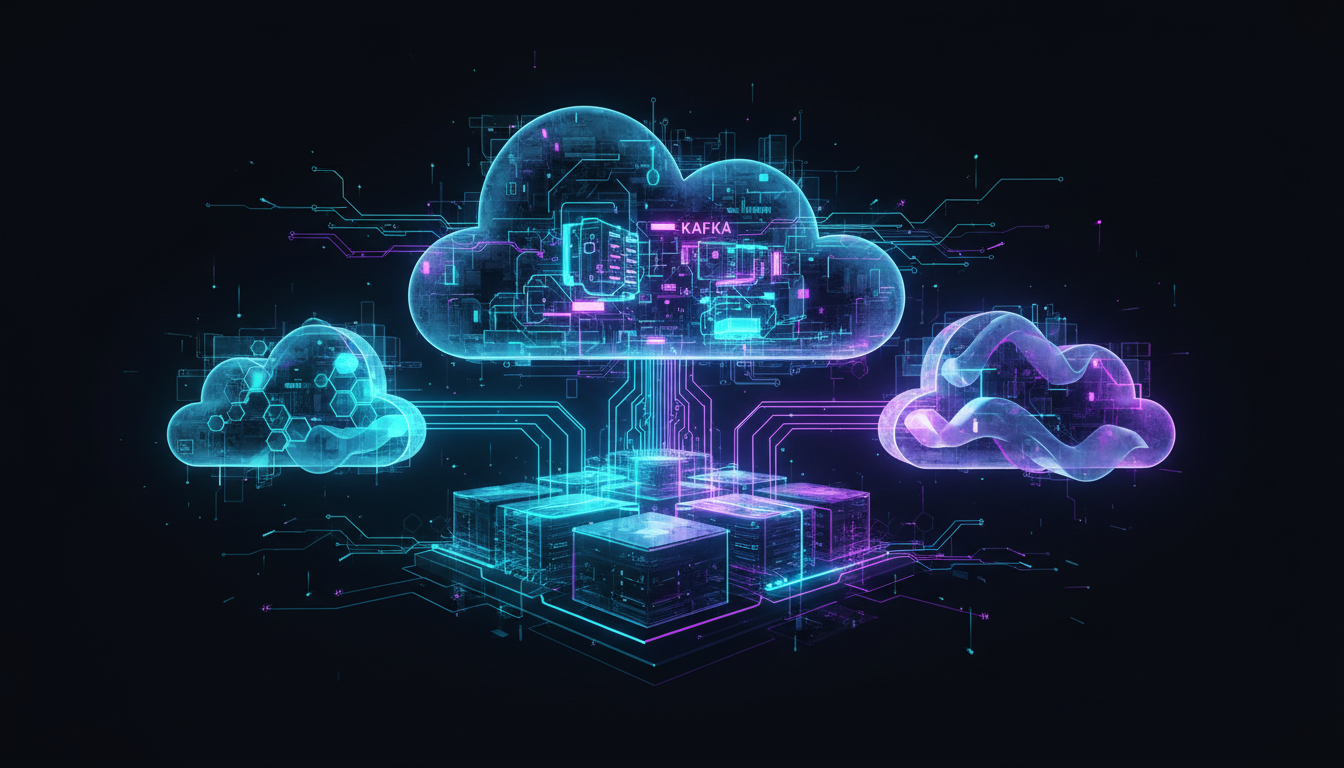
Kiến trúc truyền thống của Apache Kafka gắn chặt tính toán và lưu trữ. Các broker quản lý các phân đoạn nhật ký cục bộ, thường được hỗ trợ bởi bộ nhớ khối hiệu suất cao như AWS EBS hoặc GCP Persistent Disk. Mặc dù thiết kế này mang lại thông lượng vượt trội và truy cập độ trễ thấp cho dữ liệu gần đây, nhưng nó trở nên không bền vững về mặt kinh tế đối với việc lưu giữ dữ liệu dài hạn, đặc biệt khi khối lượng dữ liệu tăng lên đến petabyte. Chi phí IOPS được cấp phát và dung lượng lưu trữ trên các thiết bị khối cho dữ liệu lịch sử, ít được truy cập có thể nhanh chóng chiếm ưu thế trong ngân sách cơ sở hạ tầng.
Kafka Tiered Storage, được giới thiệu dưới dạng KIP-405, tái kiến trúc cơ bản lớp lưu trữ của Kafka. Nó cho phép chuyển liền mạch các phân đoạn nhật ký cũ hơn, ít được truy cập hơn từ bộ nhớ broker cục bộ sang các giải pháp lưu trữ đối tượng hiệu quả về chi phí, có độ bền cao như AWS S3 và Google Cloud Storage (GCS). Việc tách biệt tính toán và lưu trữ này cho phép giảm đáng kể chi phí, tăng cường khả năng mở rộng và đơn giản hóa quản lý vận hành mà không ảnh hưởng đến các đảm bảo cốt lõi của Kafka.
Audio Briefing• Voice: Google Cloud vi-VN-Neural2-A
0:00 / --:--
Tìm hiểu Kafka Tiered Storage (KIP-405)
KIP-405 giới thiệu mô hình lưu trữ hai tầng: một tầng cục bộ trên các broker Kafka và một tầng từ xa trên bộ nhớ đối tượng. Mục tiêu chính là tận dụng hiệu quả chi phí và khả năng mở rộng gần như vô hạn của bộ nhớ đối tượng đám mây cho dữ liệu lịch sử trong khi vẫn giữ được lợi ích hiệu suất của bộ nhớ cục bộ cho dữ liệu nóng.
Các khái niệm cốt lõi
- Tách biệt tính toán và lưu trữ: Các broker không còn chịu trách nhiệm duy nhất trong việc lưu trữ tất cả dữ liệu chủ đề. Chúng chủ yếu phục vụ dữ liệu gần đây từ các đĩa cục bộ và chuyển dữ liệu cũ hơn sang tầng từ xa. Điều này cho phép mở rộng độc lập tính toán (broker) và lưu trữ (bộ nhớ đối tượng).
- Lớp lưu trữ cục bộ: Đây là thư mục nhật ký Kafka truyền thống trên đĩa cục bộ của broker. Nó chứa các phân đoạn nhật ký gần đây nhất, cung cấp quyền truy cập đọc/ghi độ trễ thấp cho các nhà sản xuất và người tiêu dùng đang hoạt động. Thời gian lưu giữ cho lớp này có thể cấu hình được.
- Lớp lưu trữ từ xa: Đây là bộ nhớ đối tượng đám mây (S3, GCS). Khi các phân đoạn nhật ký được coi là "lạnh" dựa trên các chính sách lưu giữ đã cấu hình, chúng sẽ được tải lên bất đồng bộ vào lớp này. Lớp này hoạt động như một kho lưu trữ bất biến, có độ bền cao cho tất cả dữ liệu lịch sử.
- Trình quản lý lưu trữ từ xa: Một thành phần trong broker Kafka chịu trách nhiệm quản lý vòng đời của các phân đoạn nhật ký giữa bộ nhớ cục bộ và từ xa. Nó xử lý việc tải lên các phân đoạn vào bộ nhớ đối tượng và truy xuất các phân đoạn khi người tiêu dùng yêu cầu dữ liệu vượt quá thời gian lưu giữ cục bộ.
- Quản lý siêu dữ liệu: Để cho phép tiêu thụ liền mạch từ cả hai tầng, Kafka duy trì siêu dữ liệu về các phân đoạn nào nằm cục bộ và các phân đoạn nào đã được chuyển sang bộ nhớ từ xa. Siêu dữ liệu này rất quan trọng để người tiêu dùng truy xuất dữ liệu một cách minh bạch bất kể vị trí vật lý của nó.
Lợi ích của Tiered Storage
- Giảm chi phí đáng kể: Bộ nhớ đối tượng rẻ hơn nhiều lần so với bộ nhớ khối (EBS/Persistent Disk) để lưu giữ dài hạn. Đây là động lực chính để áp dụng.
- Khả năng mở rộng nâng cao: Tách lưu trữ khỏi các broker cho phép mở rộng dung lượng lưu trữ gần như vô hạn mà không cần thêm broker hoặc tăng kích thước đĩa cục bộ.
- Vận hành đơn giản hóa: Các broker có thể được cấp phát với các đĩa cục bộ nhỏ hơn, nhanh hơn, giảm thời gian phục hồi trong quá trình lỗi và đơn giản hóa việc quản lý đĩa.
- Lưu giữ dữ liệu mở rộng: Lưu giữ dữ liệu trong nhiều tháng hoặc nhiều năm mà không tốn kém, cho phép các trường hợp sử dụng phân tích mới và các yêu cầu tuân thủ.
- Cải thiện khả năng phục hồi của Broker: Dấu chân đĩa cục bộ nhỏ hơn có nghĩa là sao chép và phục hồi dữ liệu nhanh hơn trong trường hợp broker bị lỗi.
Tìm hiểu sâu về kiến trúc
Kiến trúc lưu trữ theo tầng thay đổi cơ bản cách Kafka quản lý các phân đoạn nhật ký của nó. Hiểu luồng dữ liệu và tương tác thành phần là rất quan trọng để triển khai và tối ưu hóa hiệu quả.
Luồng dữ liệu và tương tác thành phần
- Ghi của nhà sản xuất: Các nhà sản xuất thêm tin nhắn vào các phân vùng chủ đề. Các tin nhắn này được ghi vào phân đoạn nhật ký đang hoạt động trên đĩa cục bộ của broker.
- Chuyển đổi phân đoạn: Khi một phân đoạn nhật ký đang hoạt động đạt đến giới hạn kích thước (
log.segment.bytes) hoặc thời gian (log.segment.ms), nó sẽ được chuyển đổi, trở thành một phân đoạn đóng, bất biến. - Chính sách lưu giữ cục bộ: Broker áp dụng
local.retention.byteshoặclocal.retention.msđể xác định phân đoạn nào sẽ giữ cục bộ. Các phân đoạn cũ hơn chính sách này được đánh dấu để chuyển đi. - Tải lên phân đoạn từ xa:
RemoteLogManagertải lên bất đồng bộ các phân đoạn được đánh dấu này vào nhóm lưu trữ đối tượng đã cấu hình (S3 hoặc GCS). Quá trình này không chặn các hoạt động của broker. - Xóa phân đoạn cục bộ: Khi một phân đoạn được tải lên thành công vào bộ nhớ từ xa và siêu dữ liệu của nó được cập nhật, bản sao cục bộ có thể bị xóa, giải phóng không gian đĩa cục bộ.
- Đọc của người tiêu dùng:
- Dữ liệu nóng: Nếu người tiêu dùng yêu cầu dữ liệu trong cửa sổ lưu giữ cục bộ, broker sẽ phục vụ trực tiếp từ đĩa cục bộ của nó, duy trì độ trễ thấp.
- Dữ liệu lạnh: Nếu người tiêu dùng yêu cầu dữ liệu đã được chuyển sang bộ nhớ từ xa, broker sẽ truy xuất minh bạch các phân đoạn cần thiết từ S3/GCS, lưu trữ tạm thời và phục vụ chúng cho người tiêu dùng. Điều này gây ra độ trễ bổ sung.
Các tham số cấu hình chính
remote.log.storage.enable: Cài đặt broker toàn cầu để bật/tắt lưu trữ theo tầng. Phải làtrue.remote.log.storage.manager.impl.class: Chỉ định lớp triển khai cho trình quản lý lưu trữ từ xa.- Đối với AWS S3:
org.apache.kafka.server.log.remote.metadata.storage.S3RemoteLogMetadataManager - Đối với Google Cloud Storage:
org.apache.kafka.server.log.remote.metadata.storage.GcsRemoteLogMetadataManager
- Đối với AWS S3:
remote.log.storage.manager.impl.prefix: Tiền tố cho tất cả các cấu hình liên quan đến trình quản lý lưu trữ từ xa. Ví dụ:remote.log.storage.manager.impl.aws.region.local.retention.bytes: Số byte tối đa để giữ trên đĩa cục bộ cho mỗi phân vùng. Khi giới hạn này bị vượt quá, các phân đoạn cũ hơn sẽ được chuyển đi.local.retention.ms: Thời gian tối đa (tính bằng mili giây) để giữ các phân đoạn trên đĩa cục bộ cho mỗi phân vùng.log.segment.bytes: Kích thước tối đa của một tệp phân đoạn nhật ký. Các phân đoạn nhỏ hơn có nghĩa là chuyển đổi và tải lên thường xuyên hơn, có khả năng tăng các cuộc gọi API lưu trữ đối tượng.log.segment.ms: Thời gian tối đa trước khi một phân đoạn nhật ký được chuyển đổi.
Advertisement
Cấu hình và triển khai
Triển khai Kafka Tiered Storage yêu cầu cấu hình cẩn thận ở cả cấp độ broker và chủ đề. Chúng tôi sẽ trình bày chi tiết thiết lập cho AWS S3 và Google Cloud Storage.
Điều kiện tiên quyết
- Phiên bản Kafka: Apache Kafka 3.0.0 trở lên cho KIP-405. Đối với sản xuất, 3.3.x trở lên được khuyến nghị để ổn định và có các tính năng.
- Thông tin xác thực đám mây:
- AWS S3: Vai trò IAM hoặc người dùng có quyền
s3:PutObject,s3:GetObject,s3:DeleteObject,s3:ListBucket,s3:GetBucketLocationtrên nhóm S3 mục tiêu. - Google Cloud Storage: Khóa tài khoản dịch vụ với các vai trò
Storage Object AdminhoặcStorage Object CreatorvàStorage Object Viewertrên nhóm GCS mục tiêu.
- AWS S3: Vai trò IAM hoặc người dùng có quyền
- Nhóm đám mây: Một nhóm S3 hoặc nhóm GCS được tạo trong khu vực mong muốn.
Cấu hình Broker (server.properties)
Các tham số sau được thêm vào server.properties trên mỗi broker Kafka.
Cài đặt Tiered Storage chung
properties
# Enable remote storage
remote.log.storage.enable=true

# Set the local retention policy.
# Example: Retain 10GB per partition locally.
# This value should be carefully chosen based on hot data access patterns.
local.retention.bytes=10737418240 # 10 GB

# Alternatively, or in addition to bytes, set time-based local retention.
# Example: Retain 24 hours of data locally.
# local.retention.ms=86400000 # 24 hours

# Configure the segment size and time for optimal offloading.
# Smaller segments mean more frequent uploads but faster local deletion.
log.segment.bytes=1073741824 # 1 GB
log.segment.ms=604800000 # 7 days (default)
Cấu hình dành riêng cho AWS S3
properties
# S3 Remote Log Storage Manager implementation class
remote.log.storage.manager.impl.class=org.apache.kafka.server.log.remote.metadata.storage.S3RemoteLogMetadataManager

# S3 bucket name for remote storage
remote.log.storage.manager.impl.aws.bucket.name=your-kafka-tiered-storage-s3-bucket

# AWS region of the S3 bucket
remote.log.storage.manager.impl.aws.region=us-east-1

# (Optional) AWS endpoint for S3, useful for S3-compatible storage or private endpoints
# remote.log.storage.manager.impl.aws.endpoint=https://s3.us-east-1.amazonaws.com

# (Optional) AWS credentials provider. Default is DefaultAWSCredentialsProviderChain.
# remote.log.storage.manager.impl.aws.credentials.provider.class=com.amazonaws.auth.DefaultAWSCredentialsProviderChain

# (Optional) Number of threads for S3 uploads/downloads
# remote.log.storage.manager.impl.aws.num.client.threads=10
Cấu hình dành riêng cho Google Cloud Storage
properties
# GCS Remote Log Storage Manager implementation class
remote.log.storage.manager.impl.class=org.apache.kafka.server.log.remote.metadata.storage.GcsRemoteLogMetadataManager

# GCS bucket name for remote storage
remote.log.storage.manager.impl.gcp.bucket.name=your-kafka-tiered-storage-gcs-bucket

# GCP Project ID
remote.log.storage.manager.impl.gcp.project.id=your-gcp-project-id

# Path to the service account key file (JSON).
# Ensure this file is accessible by the Kafka broker process.
# Alternatively, if running on GCP, use default credentials via instance service account.
# remote.log.storage.manager.impl.gcp.credentials.file=/path/to/your/gcp-service-account-key.json

# (Optional) Number of threads for GCS uploads/downloads
# remote.log.storage.manager.impl.gcp.num.client.threads=10
Cấu hình chủ đề
Lưu trữ theo tầng có thể được bật và cấu hình ở cấp độ chủ đề, ghi đè các giá trị mặc định ở cấp độ broker.
bash
# Create a new topic with remote storage enabled and specific local retention
kafka-topics.sh --create --topic my-tiered-topic \
  --bootstrap-server localhost:9092 \
  --partitions 3 --replication-factor 3 \
  --config remote.storage.enable=true \
  --config local.retention.bytes=5368709120 # 5 GB local retention for this topic

# Modify an existing topic to enable remote storage
kafka-configs.sh --bootstrap-server localhost:9092 --entity-type topics --entity-name my-existing-topic \
  --alter --add-config remote.storage.enable=true

# Modify local retention for an existing tiered topic
kafka-configs.sh --bootstrap-server localhost:9092 --entity-type topics --entity-name my-existing-topic \
  --alter --add-config local.retention.ms=172800000 # 48 hours local retention
Triển khai Kubernetes với Strimzi
Strimzi đơn giản hóa việc chạy Kafka trên Kubernetes. Để bật lưu trữ theo tầng, bạn sửa đổi tài nguyên tùy chỉnh Kafka.
Ví dụ CR Kafka của Strimzi
yaml
apiVersion: kafka.strimzi.io/v1beta2
kind: Kafka
metadata:
  name: my-kafka-cluster
spec:
  kafka:
    version: 3.6.0 # Ensure Kafka version supports KIP-405
    replicas: 3
    listeners:
      - name: plain
        port: 9092
        type: internal
        tls: false
      - name: tls
        port: 9093
        type: internal
        tls: true
    storage:
      type: jbod
      volumes:
        - id: 0
          type: persistent-claim
          size: 100Gi # Smaller local storage needed due to tiered storage
          deleteClaim: false
    config:
      # Common Tiered Storage Settings
      remote.log.storage.enable: "true"
      local.retention.bytes: "10737418240" # 10 GB
      log.segment.bytes: "1073741824" # 1 GB

      # AWS S3 Specific Configuration
      remote.log.storage.manager.impl.class: "org.apache.kafka.server.log.remote.metadata.storage.S3RemoteLogMetadataManager"
      remote.log.storage.manager.impl.aws.bucket.name: "your-kafka-tiered-storage-s3-bucket"
      remote.log.storage.manager.impl.aws.region: "us-east-1"
      # For AWS, ensure the EC2 instance profile or Kubernetes service account has the necessary IAM role.
      # Strimzi can inject environment variables for AWS_ACCESS_KEY_ID and AWS_SECRET_ACCESS_KEY if needed,
      # but IAM roles are preferred.

      # OR Google Cloud Storage Specific Configuration
      # remote.log.storage.manager.impl.class: "org.apache.kafka.server.log.remote.metadata.storage.GcsRemoteLogMetadataManager"
      # remote.log.storage.manager.impl.gcp.bucket.name: "your-kafka-tiered-storage-gcs-bucket"
      # remote.log.storage.manager.impl.gcp.project.id: "your-gcp-project-id"
      # For GCP, use Workload Identity to bind a Kubernetes Service Account to a GCP Service Account.
      # The GCP Service Account should have Storage Object Admin permissions.
      # Strimzi will automatically pick up credentials if the pod's service account is configured correctly.

    # Example of how to configure a KafkaTopic with remote storage enabled
  entityOperator:
    topicOperator: {}
    userOperator: {}
---
apiVersion: kafka.strimzi.io/v1beta2
kind: KafkaTopic
metadata:
  name: my-tiered-topic
  labels:
    strimzi.io/cluster: my-kafka-cluster
spec:
  partitions: 3
  replicas: 3
  config:
    remote.storage.enable: "true"
    local.retention.bytes: "5368709120" # 5 GB local retention for this topic
Quyền IAM/GCP cho Strimzi
- AWS: Các nút Kubernetes (hoặc các pod broker Kafka cụ thể nếu sử dụng IRSA - IAM Roles for Service Accounts) phải có vai trò IAM được đính kèm cấp quyền
s3:PutObject,s3:GetObject,s3:DeleteObject,s3:ListBucket,s3:GetBucketLocationcho nhóm S3 mục tiêu. - GCP: Sử dụng Workload Identity để liên kết Tài khoản dịch vụ Kubernetes với Tài khoản dịch vụ GCP. Tài khoản dịch vụ GCP yêu cầu
Storage Object Adminhoặc các quyền tương đương trên nhóm GCS.
Phân tích tối ưu hóa chi phí
Động lực chính cho Kafka Tiered Storage là giảm chi phí. Hãy định lượng các khoản tiết kiệm tiềm năng với một kịch bản thực tế.
Kịch bản:
- Dữ liệu được nhập: 10 TB/ngày
- Hệ số sao chép: 3 (tiêu chuẩn cho tính khả dụng cao)
- Tổng dữ liệu thô: 30 TB/ngày
- Chính sách lưu giữ: 30 ngày cho dữ liệu "nóng", 1 năm cho dữ liệu "lạnh".
- Số lượng broker trung bình: 10 broker.
- Khu vực: US East (N. Virginia) -
us-east-1cho AWS,us-east4cho GCP.
Kafka truyền thống (được hỗ trợ bởi EBS)
Để lưu giữ 1 năm, tổng dung lượng lưu trữ cần thiết là 30 TB/ngày * 365 ngày = 10.950 TB (khoảng 11 PB). Đây là một trường hợp cực đoan đối với Kafka truyền thống, thường dẫn đến thời gian lưu giữ ngắn hơn. Hãy giả sử thời gian lưu giữ 30 ngày phổ biến hơn cho Kafka truyền thống do hạn chế về chi phí.
- Tổng dung lượng lưu trữ: 30 TB/ngày * 30 ngày = 900 TB (được sao chép)
- Loại ổ đĩa EBS:
gp3(hiệu quả về chi phí, hiệu suất cân bằng) - Chi phí
gp3của EBS: $0,08/GB-tháng - Tổng chi phí EBS: 900.000 GB *
0,08/GB-tháng = **72.000/tháng**
Tính toán này chỉ bao gồm lưu trữ. Nó không bao gồm chi phí phiên bản EC2, truyền mạng hoặc IOPS. Chi phí lưu trữ cao thường buộc các tổ chức phải giảm đáng kể thời gian lưu giữ.
Kafka Tiered Storage
Với lưu trữ theo tầng, chúng ta có thể giữ 30 ngày cục bộ và 1 năm từ xa.
-
Lưu trữ cục bộ (30 ngày):
- Tổng dung lượng lưu trữ: 900 TB (được sao chép)
- Dung lượng lưu trữ này được phân phối trên các broker. Nếu mỗi broker có 100GiB lưu giữ cục bộ và chúng ta có 10 broker, đó là tổng dung lượng lưu trữ cục bộ 1TB. Đây là một sự đơn giản hóa, vì
local.retention.byteslà trên mỗi phân vùng. Hãy giả sử 100GiB trên mỗi broker cho dữ liệu hoạt động. - 10 broker * 100 GiB/broker = 1000 GiB = 1 TB
- Chi phí
gp3của EBS: 1.000 GB *0,08/GB-tháng = **80/tháng**
-
Lưu trữ từ xa (1 năm):
- Tổng dữ liệu thô: 10 TB/ngày * 365 ngày = 3.650 TB (không được sao chép, vì S3/GCS xử lý độ bền)
- Chi phí tiêu chuẩn AWS S3:
0,023/GB cho 50TB đầu tiên,0,022/GB cho 450TB tiếp theo, v.v. (trung bình $0,022/GB-tháng cho quy mô này) - Tổng chi phí lưu trữ S3: 3.650.000 GB *
0,022/GB-tháng = **80.300/tháng** - Chi phí tiêu chuẩn GCS:
0,020/GB cho 1PB đầu tiên, v.v. (trung bình0,020/GB-tháng cho quy mô này) - Tổng chi phí lưu trữ GCS: 3.650.000 GB *
0,020/GB-tháng = **73.000/tháng**
-
Các cuộc gọi API lưu trữ đối tượng:
- Giả sử các phân đoạn 1GB, 10TB/ngày nhập = 10.000 phân đoạn/ngày.
- Yêu cầu S3 PUT:
0,005 cho 1.000 yêu cầu. 10.000 * 30 ngày = 300.000 PUT. Chi phí:0,005 * 300 = $1,5/tháng. (Không đáng kể) - Yêu cầu S3 GET: Rất biến động. Nếu 10% dữ liệu lạnh được truy cập hàng tháng (ví dụ: 365TB/tháng) và mỗi GET là cho một phân đoạn 1GB: 365.000 GET. Chi phí:
0,0004 cho 1.000 yêu cầu.0,0004 * 365 = $0,146/tháng. (Không đáng kể) - Chi phí hoạt động GCS tương tự, thường thấp hơn một chút.
-
Tổng chi phí Tiered Storage (AWS S3):
80 (EBS cục bộ) +80.300 (Lưu trữ S3) + ~2 (Cuộc gọi API) = **~80.382/tháng** -
Tổng chi phí Tiered Storage (GCS):
80 (EBS cục bộ) +73.000 (Lưu trữ GCS) + ~2 (Cuộc gọi API) = **~73.082/tháng**
Chứng minh tiết kiệm hơn 75%
So sánh này rất khó vì Kafka truyền thống thường không thể chi trả 1 năm lưu giữ. Nếu chúng ta so sánh 30 ngày lưu giữ trên EBS với 1 năm lưu giữ với Tiered Storage:
- Truyền thống (30 ngày EBS): $72.000/tháng
- Theo tầng (1 năm S3): $80.382/tháng
Điều này không cho thấy sự tiết kiệm, nó cho thấy chi phí tăng lên cho thời gian lưu giữ tăng đáng kể. Khoản tiết kiệm thực sự nằm ở chi phí trên mỗi GB-tháng cho dữ liệu dài hạn.
Hãy đánh giá lại kịch bản: Điều gì sẽ xảy ra nếu chúng ta phải lưu trữ 1 năm dữ liệu trên EBS?
- Tổng dung lượng lưu trữ EBS trong 1 năm: 10.950 TB (được sao chép)
- Chi phí
gp3của EBS: 10.950.000 GB *0,08/GB-tháng = **876.000/tháng**
Bây giờ, hãy so sánh điều này với Tiered Storage trong 1 năm:
- Tiered Storage (AWS S3): ~$80.382/tháng
- Tiered Storage (GCS): ~$73.082/tháng
Tính toán tiết kiệm (AWS S3 so với EBS cho 1 năm lưu giữ):
(876.000 - 80.382) / $876.000 = 0,908 = tiết kiệm 90,8%
Tính toán tiết kiệm (GCS so với EBS cho 1 năm lưu giữ):
(876.000 - 73.082) / $876.000 = 0,916 = tiết kiệm 91,6%
Điều này cho thấy rằng đối với việc lưu giữ dài hạn, lưu trữ theo tầng mang lại tiết kiệm hơn 90% chi phí lưu trữ so với giải pháp chỉ dùng EBS. Ngay cả khi bạn chỉ cần 3 tháng lưu giữ trên EBS, chi phí sẽ cao gấp 3 lần so với phương pháp theo tầng 30 ngày EBS + 1 năm S3/GCS.
Hơn nữa, chi phí tính toán cho các broker có thể được giảm. Với yêu cầu đĩa cục bộ nhỏ hơn, bạn có thể sử dụng các loại phiên bản EC2 nhỏ hơn hoặc giảm số lượng broker, góp phần tiết kiệm hơn nữa.
Đặc điểm hiệu suất và đánh đổi
Mặc dù tiết kiệm chi phí là đáng kể, nhưng điều quan trọng là phải hiểu các tác động về hiệu suất của việc giới thiệu một lớp lưu trữ đối tượng.
Độ trễ và thông lượng
- Đọc cục bộ: Đối với dữ liệu trong cửa sổ
local.retention, hiệu suất vẫn giống hệt Kafka truyền thống. Độ trễ thường dưới mili giây. - Đọc từ xa: Khi người tiêu dùng yêu cầu dữ liệu đã được chuyển đi, broker phải truy xuất nó từ S3/GCS. Điều này gây ra độ trễ mạng và chi phí truy xuất bộ nhớ đối tượng.
- Độ trễ điển hình: 50ms - 500ms cho mỗi lần truy xuất phân đoạn, tùy thuộc vào điều kiện mạng, kích thước đối tượng và hiệu suất nhà cung cấp đám mây. Điều này cao hơn đáng kể so với truy cập đĩa cục bộ.
- Tác động: Người tiêu dùng đọc dữ liệu lịch sử sẽ trải nghiệm độ trễ cao hơn và có khả năng thông lượng thấp hơn. Các ứng dụng nhạy cảm với điều này nên đảm bảo tập hợp làm việc của họ vẫn nằm trong thời gian lưu giữ cục bộ.
- Ghi: Hiệu suất ghi của nhà sản xuất hầu như không bị ảnh hưởng vì việc chuyển đi là bất đồng bộ và không chặn.
- CPU/Mạng Broker: Các broker sẽ tiêu thụ thêm CPU để quản lý các phân đoạn từ xa và băng thông mạng để tải lên/tải xuống dữ liệu đến/từ bộ nhớ đối tượng. Điều này cần được tính đến trong việc định cỡ phiên bản.
Độ bền và tính khả dụng
- Độ bền của bộ nhớ đối tượng: AWS S3 và GCS cung cấp độ bền cực cao (11 số 9, 99,999999999%) bằng cách lưu trữ dữ liệu dự phòng trên nhiều cơ sở trong một khu vực. Điều này vượt trội so với các cấu hình RAID EBS điển hình.
- Tính khả dụng của bộ nhớ đối tượng: Cả S3 và GCS đều cung cấp tính khả dụng cao (SLA 99,9% đến 99,99% cho các tầng tiêu chuẩn).
- Độ bền của Kafka: Hệ số sao chép 3x cho các phân đoạn cục bộ vẫn được áp dụng. Khi một phân đoạn được tải lên thành công vào bộ nhớ đối tượng, độ bền của nó được nhà cung cấp đám mây xử lý hiệu quả.
Bảng so sánh: EBS so với S3/GCS cho lưu trữ Kafka
| Tính năng | Kafka truyền thống (EBS/Persistent Disk) | Kafka Tiered Storage (EBS cục bộ + S3/GCS từ xa)
Bạn cũng có thể thích
- Định dạng bảng mở vào năm 2026: Apache Iceberg v2 so với Delta Lake 3.0 trên Cloud Object Storage
- Mở rộng DuckDB: Phân tích không gian, tích hợp Parquet & Iceberg từ xa qua HTTPFS
- Kho dữ liệu phân tích Serverless với BigQuery & Cloud Run: Từ luồng GA4 đến cảnh báo SEO tự động
- BigQuery + Cloud Run: Xây Dựng Pipeline Nhập Dữ Liệu Serverless Cho Production
Kiểm tra kiến thức
Interactive Quiz
Question 1 of 2
Một Kafka cluster sử dụng Tiered Storage (KIP-405) gặp phải tình trạng tăng đột biến, kéo dài trong các yêu cầu của consumer đối với dữ liệu lịch sử (ví dụ: 3 tháng tuổi) đã được offload sang AWS S3. Tác động vận hành tức thời CÓ KHẢ NĂNG NHẤT là gì?
Chia sẻ bài viết:
Tiện ích lập trình viên
Công cụ lập trình trực tiếp trên trình duyệt
Làm sạch log AI CLI, tạo biểu thức cron, giải mã JWT và tính quyền chmod offline.
Advertisement
Bài viết liên quan
cloud
Cẩm Nang Kiến Trúc GCP Thực Dụng: Dịch Vụ Nào Thực Sự Nên Dùng (Và Nên Tránh Điều Gì)
Cẩm nang production đã được kiểm chứng về Google Cloud Platform. Tìm hiểu vì sao Cloud Run thắng GKE trong 90% workload, cách tận dụng BigQuery và Secret Manager, cùng 5 bẫy chi phí ẩn đang làm cạn kiệt ngân sách cloud.
Đọc tiếp
data-engineering
Định dạng bảng mở vào năm 2026: Apache Iceberg v2 so với Delta Lake 3.0 trên Cloud Object Storage
Hướng dẫn toàn diện về các định dạng bảng mở vào năm 2026: apache iceberg v2 so với delta lake 3.0 trên cloud object storage với kiến trúc cấp độ sản xuất và ví dụ mã.
Đọc tiếp
kubernetes
Quan sát bảo mật eBPF với Cilium Tetragon: Thực thi runtime theo thời gian thực trong Kubernetes
Hướng dẫn toàn diện về quan sát bảo mật eBPF với Cilium Tetragon: thực thi runtime theo thời gian thực trong Kubernetes với kiến trúc cấp độ sản xuất và các ví dụ mã.
Đọc tiếp