•18分で読める
pgvectorによるベクトル検索のスケーリング

Locionic(@Locionic)
RAGパイプラインにPinecone、Weaviate、Qdrantのような特殊なベクトルデータベースの契約を結ぶ前に、プライマリデータベースをよく見てください。もしあなたのスタックがすでにPostgreSQLを実行しているなら、専用のベクトルデータベースは必要ないかもしれません。
スタンドアロンのベクトルデータベースを立ち上げるということは、2つの信頼できる情報源を管理し、二重書き込み同期スクリプトを書き、ユーザーがレコードを削除または更新するたびに結果整合性の悪夢に対処することを意味します。
pgvector拡張機能を使えば、埋め込みはリレーショナルテーブルのすぐ隣に配置され、同じACID保証、自動バックアップ、シームレスなハイブリッドSQL結合を共有できます。
ここでは、RAGパイプラインでベクトル検索がどのように機能するか、pgvectorを構成する方法、100万を超える埋め込みにスケールするHNSWインデックスを構築する方法、そしてPostgresを離れることなく高速なコサイン類似度検索を実行する方法を説明します。
Audio Briefing• Voice: Google Cloud ja-JP-Neural2-B
0:00 / --:--
Interactive Dev Tool
100% Client-Side & Privatepgvector HNSW Index RAM & Sizing Calculator
Estimate RAM usage, disk index size & maintenance_work_mem
Calculate exact RAM overhead, disk footprint, and indexing parameters (m, ef_construction) for PostgreSQL pgvector HNSW vector indexes. Compare halfvec and quantization savings.
pgvectorHNSW RAM SizingVector Searchhalfvec / int8
スタンドアロンのベクトルデータベースが失敗する場所
Pinecone、Milvus、Qdrantのような専用のベクトルデータベースは堅牢なツールですが、それをスタックに導入することは次のことを意味します。
- セカンダリデータベースを維持し、二重同期パイプラインを作成する必要があります。
- ユーザーがPostgresでアカウントを削除したり記事を編集したりした場合、ベクトルストアで分散削除/更新を調整する必要があります。
- 権限チェック(
WHERE org_id = $1)は、ぎこちない事前フィルタリングまたは2段階のクエリ処理になります。
pgvectorを使用すると、埋め込みはプライマリデータベースに直接保存されます。挿入はACIDトランザクションです。削除は行とそのベクトルの両方を同時にクリーンアップします。
pgvectorのセットアップ
pgvectorの利用開始は非常に簡単です。最新のマネージドPostgreSQLプロバイダー(AWS RDS、Supabase、Google Cloud SQL、Neonなど)を使用している場合、pgvectorはほぼ確実にすでにサポートされており、有効にするだけで済みます。
PostgreSQLをローカルまたはカスタムサーバーで実行している場合は、ソースからコンパイルしてインストールできます。バイナリがサーバーにインストールされたら、次のSQLコマンドを実行してデータベースで拡張機能を有効にします。
sql
-- Enable the pgvector extension in your database
CREATE EXTENSION IF NOT EXISTS vector;
拡張機能が正常に有効になったので、新しいvectorデータ型を利用できるようになりました。テキストドキュメントのチャンクとそれに対応する埋め込みを保存するテーブルを作成しましょう。たとえば、OpenAIの標準埋め込みを使用している場合、次元数は通常1536です。
sql
-- Create a table to store documents, metadata, and their vector embeddings
CREATE TABLE documents (
    id bigserial PRIMARY KEY,
    content text NOT NULL,
    metadata jsonb,
    -- Store a vector array with precisely 1536 dimensions
    embedding vector(1536)
);
このテーブルへのデータの挿入は、他のPostgresテーブルへの挿入と同じくらい簡単です。アプリケーションコードから、ベクトルをフォーマットされた文字列または標準配列として提供するだけです。
sql
-- Insert a sample document and its semantic embedding
INSERT INTO documents (content, metadata, embedding)
VALUES (
    'Vector search enables semantic matching based on meaning, rather than keywords.',
    '{"author": "Jane Doe", "category": "AI", "tenant_id": 101}',
    '[0.012, -0.045, 0.088, ..., 0.011]'
);
Advertisement
コサイン類似度検索の実行
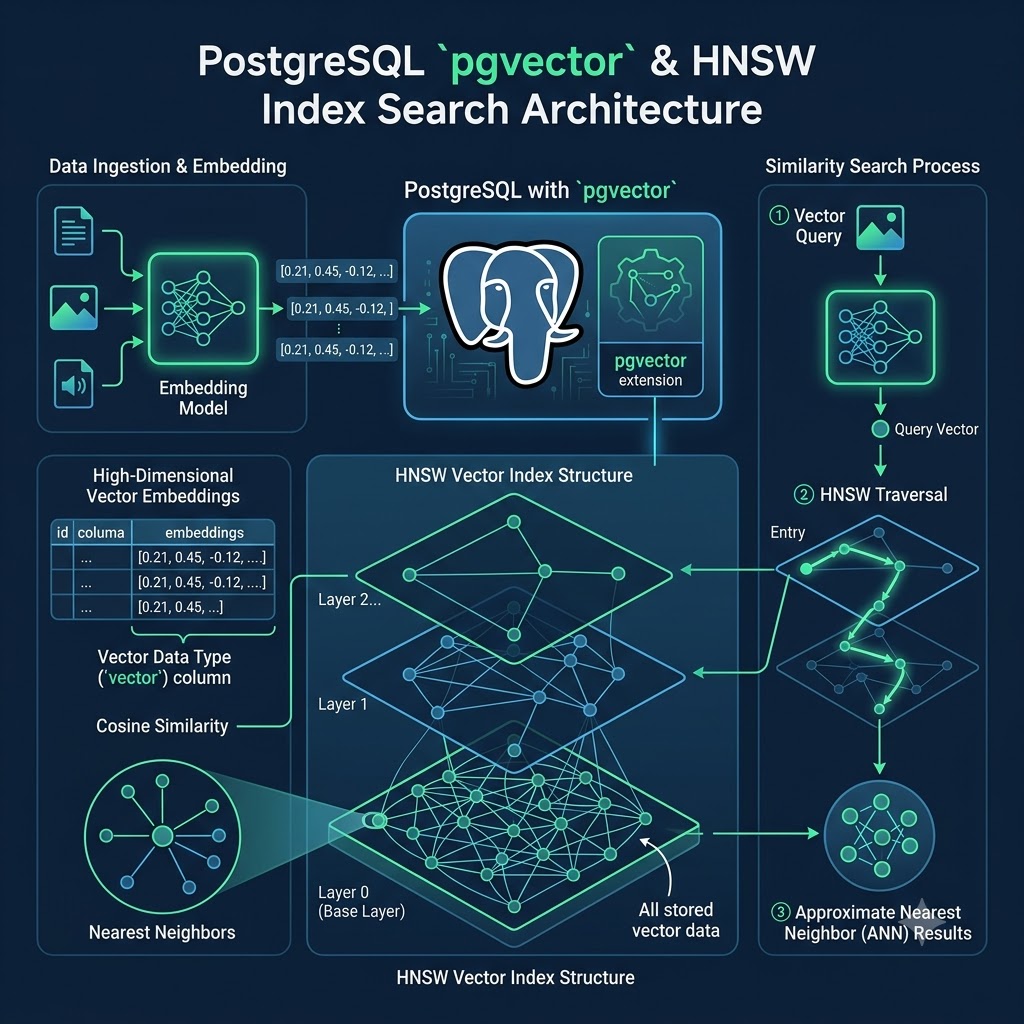
特定のクエリに最も関連性の高いドキュメントを見つけるには、まずユーザーのプレーンテキストクエリをまったく同じ埋め込みモデルを使用して埋め込みに変換し、次にデータベースで最も近いベクトルを検索する必要があります。pgvectorは、ユークリッド距離(<->)、内積(<#>)、コサイン距離(<=>)を含むいくつかの距離メトリックをネイティブにサポートしています。
ほとんどの最新のLLM埋め込み(プロバイダーによって正規化されていることが多い)では、コサイン距離が標準的で推奨されるメトリックです。ここでは、K-Nearest Neighbors(KNN)検索を実行して、セマンティックに最も類似した上位5つのドキュメントを迅速に見つける方法を示します。
sql
-- Find the 5 most semantically similar documents to a user's query vector
SELECT
    id,
    content,
    -- Calculate cosine similarity by subtracting distance from 1
    1 - (embedding <=> '[0.015, -0.042, 0.091, ..., 0.021]') AS similarity_score
FROM documents
ORDER BY embedding <=> '[0.015, -0.042, 0.091, ..., 0.021]'
LIMIT 5;
カスタム演算子<=>がコサイン距離を計算していることに注目してください。コサイン類似度は数学的に1 - cosine_distanceとして定義されているため、直感的な類似度スコアを取得するために、SELECT句で距離を1から減算するだけです。
HNSWインデックスによるスケーリング
上記のような標準的なKNNクエリは、テーブル内のすべての行を調べて正確な距離を計算するシーケンシャルスキャンを実行します。このExact Nearest Neighbor(ENN)アプローチは完璧な精度を保証しますが、データセットが数十万または数百万行に増加すると、信じられないほど遅くなります。
ベクトル検索をエンタープライズレベルにスケールするには、Approximate Nearest Neighbor(ANN)アルゴリズムを使用する必要があります。これらのアルゴリズムは、わずかでしばしば知覚できない精度の低下(再現率)と引き換えに、大規模な対数的なパフォーマンス向上をもたらします。バージョン0.5.0以降、pgvectorはHNSW(Hierarchical Navigable Small World)インデックスの堅牢なサポートを導入しました。これは、今日のベクトル検索のゴールドスタンダードアルゴリズムとして広く認識されています。
HNSWは、各ノードがベクトルを表す多層グラフを構築します。検索は最も高く、最も疎な層から始まり、ベクトル空間を大きくジャンプして近傍を迅速に絞り込み、徐々に低く、より密な層にドリルダウンしてきめ細かいナビゲーションを行います。
ここでは、pgvectorでHNSWインデックスを作成し、コサイン距離に明示的に最適化する方法を示します。
sql
-- Create an HNSW index optimized for cosine distance calculations
CREATE INDEX documents_embedding_hnsw_idx
ON documents
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);
パフォーマンスチューニング: mとef_construction
HNSWインデックス作成コマンドは、ビルド時間、メモリフットプリント、検索再現率のトレードオフを正確に調整できる2つの重要なパラメータを受け入れます。
m: グラフ構築中に各要素に対して作成される双方向リンクの最大数。mが高いほど(例:32、64、または96)、高次元データ(1536次元ベクトルなど)の再現率が向上しますが、ディスクとRAM上のインデックスサイズ、およびビルド時間が大幅に増加します。デフォルトは16ですが、重い本番ワークロードでは64が推奨されることがよくあります。ef_construction: インデックス構築時に使用される動的候補リストのサイズ。この値を増やすと(例:128、256、または512)、細心の注意を払って構築された高品質のグラフとより良い再現率が得られますが、インデックス作成時間が大幅に長くなるという明確なコストがかかります。これはクエリ時間ではなく、インデックスビルド時間にのみ影響します。
さらに、クエリ実行中に、現在のトランザクションまたはセッションのef_searchを動的に調整して、検索フェーズで考慮される候補の数を制御できます。値が高いほど再現率が向上しますが、検索速度がわずかに低下します。
sql
-- Adjust ef_search for the current session to prioritize recall (default is 40)
SET hnsw.ef_search = 100;
ハイブリッド検索:Postgresの究極の利点
スタンドアロンのベクトルデータベースではなくpgvectorを使用する最も説得力のある理由の1つは、複雑なハイブリッド検索を実行できることです。ベクトル類似性と従来のSQLフィルターおよび結合をシームレスかつトランザクション的に組み合わせることができます。たとえば、特定の著者、テナントID、または厳密な日付範囲でドキュメントを簡単にフィルタリングし、残りのサブセットをセマンティックな関連性でランク付けできます。
sql
SELECT
    content,
    metadata->>'author' AS author,
    1 - (embedding <=> '[0.015, -0.042, 0.091, ..., 0.021]') AS similarity
FROM documents
WHERE metadata->>'category' = 'AI'
  AND (metadata->>'tenant_id')::int = 101
ORDER BY embedding <=> '[0.015, -0.042, 0.091, ..., 0.021]'
LIMIT 5;
標準カラムが適切にインデックス化されている場合(例:metadata JSONBカラムにB-TreeまたはGINインデックスを使用)、PostgreSQLの洗練されたクエリプランナーは、データセットを積極的に最初にフィルタリングし、高価なベクトル検索を関連性の高い、ターゲットを絞ったサブセットにのみ適用できます。これは、リレーショナルメタデータがPostgresに存在し、ベクトルが完全に分離された別のデータベースシステムに存在する分割アーキテクチャでは、効率的に達成することが非常に困難で、遅延が大きく、エラーが発生しやすいことで知られています。
スケールする前の運用上の経験則
HNSWを使用するpgvectorは数百万のベクトルを簡単に処理しますが、これらの実用的な制限に留意してください。
- RAMの制約: HNSWインデックスはメモリに収まる必要があります。
m = 32を持つ100万個の1536次元ベクトルは、インデックスだけで約2.5GBから3GBのRAMを消費します。インデックスがディスクにスピルアウトすると、クエリのレイテンシは8msから200ms以上に跳ね上がります。shared_buffersとRAMをそれに応じてサイズ設定してください。 - リードレプリカ: ベクトル検索はCPUとメモリを大量に消費します。検索トラフィックが増加したら、ベクトルクエリ専用のPostgresリードレプリカを立ち上げて、プライマリOLTP接続プールを枯渇させないようにしてください。
- フィルタリングされたANN再現率: 大量のマルチテナントフィルター(
WHERE tenant_id = $1)を実行する場合、再現率の低下を防ぐために、テナントごとの部分HNSWインデックスまたはpgvector 0.7の反復インデックススキャンを検討してください。
1000万未満のベクトルがある場合は、Postgresから始めてください。これにより、スタックがシンプルになり、運用オーバーヘッドがほぼゼロになります。
こちらもおすすめ
- 2026年版ScyllaDB対ApacheCassandra: P99レイテンシー、C++Seastar、TCOベンチマーク
- ScyllaDBとSeastarのアーキテクチャ:スレッドパーコア実行、Shared-Nothing C++、P99レイテンシ
- ClickHouseのMaterializedViewとReplacingMergeTree:サブ秒リアルタイム分析
- 2026年のClickHouseとDuckDB:インメモリ組み込みOLAP対分散型ベクトル化ウェアハウス
知識を確認する(インタラクティブクイズ)
Interactive Quiz
Question 1 of 2
RAGパイプライン構築において、Pinecone等の専用ベクトルDBと比較した際のPostgreSQL + `pgvector`のプロダクションにおける最大の優位性を示すシナリオはどれですか?
この記事を共有:
開発者ユーティリティ
ブラウザで動く無料の開発者ツール
AI CLIログの整形、Cron式の作成、JWTの解析、chmod権限の計算をオフラインで実行。
Advertisement
関連記事
postgresql
pgvectorを本番環境で使う: PostgreSQLでの高スケールベクトル検索とハイブリッドRRF
PostgreSQLでpgvectorを本番運用するためのガイド:HNSWとIVFFlatインデックスの比較、パラメータチューニング、RRFによるハイブリッド全文検索、メタデータフィルタリングについて解説します。
続きを読む
ai
大規模ベクトル検索:pgvectorとSQLite-vecにおけるHNSW対IVFFlatインデックス
pgvectorとsqlite-vecにおけるHNSWとIVFFlatベクトルインデックスアルゴリズムを比較。再現率、構築時間、メモリフットプリント、クエリレイテンシを分析します。
続きを読む
ai
本番RAG向けVectorDatabase (2026): Pinecone vs Qdrant vs Milvus vs pgvector
本番RAGパイプライン向けにPinecone、Qdrant、Milvus、pgvectorのアーキテクチャを、HNSW vs IVFFlatインデックス、単段フィルタリング検索、p95レイテンシ、メモリフットプリントでベンチマークします。
続きを読む