Rust hiệu suất cao với WebAssembly SIMD: Tăng tốc tính toán trình duyệt lên 10 lần

Mục lục bài viết(11 mục)
Các ứng dụng web hiện đại ngày càng đòi hỏi khả năng tính toán hiệu năng cao trực tiếp trong trình duyệt. Việc thực thi JavaScript truyền thống, dù đã được tối ưu hóa, thường gặp phải những hạn chế khi xử lý các tập dữ liệu lớn, thực hiện các phép toán phức tạp hoặc hiển thị đồ họa tinh vi. WebAssembly (Wasm) cung cấp một giải pháp thay thế với hiệu suất gần như native, và với sự ra đời của WebAssembly SIMD (Single Instruction, Multiple Data), chúng ta có thể đạt được sự cải thiện đáng kể về hiệu suất cho các tác vụ song song dữ liệu.
Hướng dẫn này trình bày chi tiết các cân nhắc về kiến trúc và chiến lược triển khai để tận dụng Rust với WebAssembly SIMD nhằm đạt được những cải thiện hiệu suất đáng kể trong tính toán trên trình duyệt. Chúng ta sẽ khám phá v128 thanh ghi vector, tự động vector hóa của trình biên dịch và các hàm nội tại SIMD được viết thủ công, chứng minh ứng dụng của chúng trong các tình huống thực tế như xử lý ảnh và nhân ma trận.
Các Khái Niệm Cơ Bản về WebAssembly SIMD
SIMD là một lớp tính toán song song cho phép một lệnh duy nhất thực hiện trên nhiều điểm dữ liệu cùng lúc. Điều này trái ngược với xử lý vô hướng, nơi một lệnh thực hiện trên một điểm dữ liệu tại một thời điểm. Đối với các tác vụ liên quan đến các phép toán lặp đi lặp lại trên các mảng dữ liệu lớn, SIMD mang lại sự cải thiện đáng kể về thông lượng.
Các Thanh Ghi Vector v128
WebAssembly SIMD giới thiệu một kiểu giá trị mới, v128, đại diện cho một vector 128-bit. Vector này có thể chứa nhiều kiểu dữ liệu khác nhau, cho phép các phép toán song song trên:
- 16
i8(số nguyên 8-bit) - 8
i16(số nguyên 16-bit) - 4
i32(số nguyên 32-bit) - 2
i64(số nguyên 64-bit) - 4
f32(số dấu phẩy động 32-bit) - 2
f64(số dấu phẩy động 64-bit)
Các thanh ghi v128 này được thao tác bởi một tập hợp các lệnh SIMD, bao gồm:
- Load/Store:
v128.load,v128.stoređể di chuyển dữ liệu giữa bộ nhớ và các thanh ghi. - Số học:
i32x4.add,f32x4.mul,i16x8.sub, v.v. - Logic:
v128.and,v128.or,v128.xor. - Shuffle/Swizzle:
v8x16.shuffleđể sắp xếp lại các phần tử trong một vector. - So sánh:
i33x4.eq,f32x4.lt.
Phần cứng cơ bản (CPU) thực thi các phép toán v128 này bằng cách sử dụng các đơn vị SIMD native của nó (ví dụ: SSE, AVX trên x86; NEON trên ARM), cung cấp một lớp trừu tượng di động cho xử lý vector hiệu suất cao.
Kích Hoạt SIMD trong Rust cho Wasm
Để biên dịch mã Rust với hỗ trợ Wasm SIMD, các tính năng mục tiêu cụ thể phải được kích hoạt trong quá trình biên dịch.
Đầu tiên, đảm bảo bạn đã cài đặt mục tiêu wasm32-unknown-unknown:
rustup target add wasm32-unknown-unknown
Đối với các dự án wasm-pack, bạn thường cấu hình điều này trong Cargo.toml và truyền các cờ tới rustc thông qua wasm-pack build.
# Cargo.toml
[package]
name = "wasm-simd-lib"
version = "0.1.0"
edition = "2021"

[lib]
crate-type = ["cdylib"]

[dependencies]
wasm-bindgen = "0.2.92"

[profile.release]
# Enable LTO for better optimization
lto = true
# Optimize for size
opt-level = 's'
# Enable SIMD target feature
# This flag is crucial for both auto-vectorization and intrinsics.
# It tells the Rust compiler (and LLVM) to emit Wasm SIMD instructions.
rustflags = ["-C", "target-feature=+simd128"]
Khi xây dựng với wasm-pack, rustflags trong profile.release sẽ tự động được chọn:
wasm-pack build --target web --release
Lệnh này biên dịch mã Rust của bạn thành một module Wasm, tạo ra các ràng buộc JavaScript để tương tác. Cờ --release đảm bảo rằng các cài đặt profile.release được áp dụng, bao gồm target-feature=+simd128.
Tự Động Vector Hóa với Rust
Trình biên dịch Rust, tận dụng LLVM, có thể tự động phát hiện các cơ hội để vector hóa các vòng lặp và phát ra các lệnh SIMD. Đây thường là cách đơn giản nhất để đạt được lợi ích về hiệu suất mà không cần viết mã SIMD tường minh.
Hãy xem xét một phép cộng mảng đơn giản:
// src/lib.rs
use wasm_bindgen::prelude::*;

#[wasm_bindgen]
pub fn add_arrays_scalar(a: &[f32], b: &[f32], c: &mut [f32]) {
    assert_eq!(a.len(), b.len());
    assert_eq!(a.len(), c.len());

    for i in 0..a.len() {
        c[i] = a[i] + b[i];
    }
}

// To enable auto-vectorization, ensure `target-feature=+simd128` is set in Cargo.toml.
// The compiler will attempt to vectorize this loop if possible.
#[wasm_bindgen]
pub fn add_arrays_auto_vectorized(a: &[f32], b: &[f32], c: &mut [f32]) {
    assert_eq!(a.len(), b.len());
    assert_eq!(a.len(), c.len());

    // This loop is identical to the scalar version.
    // The compiler's optimizer will attempt to vectorize it.
    for i in 0..a.len() {
        c[i] = a[i] + b[i];
    }
}
Khi được biên dịch với target-feature=+simd128, vòng lặp của hàm add_arrays_auto_vectorized có thể được LLVM chuyển đổi thành các lệnh Wasm SIMD như f32x4.load, f32x4.add và f32x4.store.
Hạn chế của Tự Động Vector Hóa:
- Heuristics của Trình Biên Dịch: Khả năng vector hóa của trình biên dịch phụ thuộc vào cấu trúc vòng lặp, các mẫu truy cập bộ nhớ và các phụ thuộc dữ liệu. Các vòng lặp phức tạp hoặc truy cập bộ nhớ không liên tục thường ngăn cản việc tự động vector hóa.
- Căn Chỉnh: Mặc dù Wasm SIMD có thể xử lý các tải/lưu trữ không căn chỉnh, truy cập căn chỉnh thường nhanh hơn. Trình biên dịch có thể không luôn đảm bảo căn chỉnh tối ưu.
- Các Thuật Toán Cụ Thể: Một số thuật toán vốn dĩ yêu cầu các mẫu SIMD cụ thể mà một bộ vector hóa tự động đa năng khó có thể suy ra.
Để kiểm soát và hiệu suất tối đa, đặc biệt trong các phần quan trọng, các hàm nội tại SIMD được viết thủ công là cần thiết.
Các Hàm Nội Tại SIMD Được Viết Thủ Công (core::arch::wasm32)
Khi tự động vector hóa không đủ, Rust cung cấp quyền truy cập trực tiếp vào các hàm nội tại Wasm SIMD thông qua module core::arch::wasm32. Điều này cho phép các nhà phát triển sử dụng rõ ràng các phép toán v128, tương tự như việc sử dụng các hàm nội tại SSE/AVX trong C++.
Module core::arch::wasm32 hiển thị các hàm ánh xạ trực tiếp tới các lệnh Wasm SIMD. Các hàm này thường là unsafe vì chúng hoạt động ở cấp độ thấp và yêu cầu xử lý cẩn thận bộ nhớ và kiểu dữ liệu.
// src/lib.rs
use wasm_bindgen::prelude::*;
use core::arch::wasm32::*; // Import all Wasm SIMD intrinsics

#[wasm_bindgen]
pub fn add_arrays_simd(a: &[f32], b: &[f32], c: &mut [f32]) {
    assert_eq!(a.len(), b.len());
    assert_eq!(a.len(), c.len());
    assert!(a.len() % 4 == 0, "Input length must be a multiple of 4 for f32x4 SIMD");

    let len = a.len();
    let a_ptr = a.as_ptr() as *const f32;
    let b_ptr = b.as_ptr() as *const f32;
    let c_ptr = c.as_mut_ptr() as *mut f32;

    // Process 4 f32 elements at a time
    for i in (0..len).step_by(4) {
        unsafe {
            // Load 4 f32 values from array 'a' into a v128 register
            let va = v128_load(a_ptr.add(i) as *const v128);
            // Load 4 f32 values from array 'b' into a v128 register
            let vb = v128_load(b_ptr.add(i) as *const v128);

            // Perform element-wise addition on the two v128 registers
            let vc = f32x4_add(va, vb);

            // Store the resulting 4 f32 values back into array 'c'
            v128_store(c_ptr.add(i) as *mut v128, vc);
        }
    }
}
Các Hàm Nội Tại Chính Được Sử Dụng:
v128_load(ptr as *const v128): Tải 16 byte (128 bit) từ bộ nhớ vào một thanh ghiv128. Con trỏ phải được ép kiểu thành*const v128.v128_store(ptr as *mut v128, value): Lưu giá trị thanh ghiv128vào 16 byte bộ nhớ. Con trỏ phải được ép kiểu thành*mut v128.f32x4_add(a, b): Thực hiện phép cộng từng phần tử trên hai thanh ghiv128, coi chúng là bốn giá trịf32. Các hàm nội tại tương tự tồn tại cho các kiểu dữ liệu khác (ví dụ:i32x4_mul,i8x16_sub).
Những Điều Cần Lưu Ý Quan Trọng Đối với Hàm Nội Tại:
- Khối
unsafe: Tất cả các hàm nội tại SIMD đều làunsafevì chúng hoạt động trên các con trỏ thô và yêu cầu lập trình viên đảm bảo an toàn bộ nhớ (ví dụ: con trỏ hợp lệ, căn chỉnh chính xác, kiểm tra giới hạn). - Căn Chỉnh Dữ Liệu: Mặc dù
v128_loadvàv128_storecó thể xử lý truy cập không căn chỉnh, hiệu suất thường tốt hơn với bộ nhớ được căn chỉnh 16 byte.Vec<T>của Rust thường cung cấp căn chỉnh đủ cho các phần tử của nó, nhưng các cấu trúc dữ liệu tùy chỉnh hoặc con trỏ thô có thể yêu cầu căn chỉnh rõ ràng. Đối vớiwasm-bindgen, các chế độ xemjs_sys::WebAssembly::MemoryvàUint8Arraythường cung cấp quyền truy cập cấp byte, và việc căn chỉnh phải được quản lý cẩn thận. - Mở Rộng Vòng Lặp/Hệ Số Vector Hóa:
step_by(4)trong ví dụ xử lý rõ ràng 4 phần tửf32tại một thời điểm, khớp với chiều rộng vectorf32x4. Điều này rất quan trọng để sử dụng SIMD hiệu quả. - Xử Lý Phần Dư: Đối với các độ dài đầu vào không chia hết hoàn hảo cho chiều rộng vector (ví dụ:
len % 4 != 0), một vòng lặp "đuôi" sử dụng các phép toán vô hướng là cần thiết để xử lý các phần tử còn lại. Ví dụ trên khẳng địnhlen % 4 == 0để đơn giản.
Ứng Dụng Thực Tế: Xử Lý Ảnh (Bộ Lọc Convolution/Làm Mờ)
Xử lý ảnh, đặc biệt là các bộ lọc convolution như làm mờ, là một ứng cử viên hàng đầu cho tối ưu hóa SIMD do tính chất song song cao của nó. Giá trị mới của mỗi pixel được tính toán dựa trên các pixel lân cận của nó, một phép toán lặp đi lặp lại trên toàn bộ hình ảnh.
Chúng ta sẽ triển khai bộ làm mờ Gaussian 3x3. Để đơn giản, chúng ta sẽ giả định một hình ảnh thang độ xám được biểu diễn dưới dạng Uint8ClampedArray (hoặc Vec<u8>) trong đó mỗi phần tử là cường độ pixel.
Thuật Toán: Làm Mờ Gaussian 3x3
Kernel cho bộ làm mờ Gaussian 3x3 (xấp xỉ) là:
[ 1  2  1 ]
[ 2  4  2 ] * (1/16)
[ 1  2  1 ]
Mỗi pixel đầu ra P_out(x, y) được tính toán dưới dạng tổng trọng số của 9 pixel lân cận của nó trong hình ảnh đầu vào P_in:
P_out(x, y) = (1/16) * [ P_in(x-1, y-1)*1 + P_in(x, y-1)*2 + P_in(x+1, y-1)*1 + P_in(x-1, y)*2 + P_in(x, y)*4 + P_in(x+1, y)*2 + P_in(x-1, y+1)*1 + P_in(x, y+1)*2 + P_in(x+1, y+1)*1 ]
Triển Khai Rust
Chúng ta sẽ cung cấp ba triển khai Rust: vô hướng, tự động vector hóa và SIMD được viết thủ công.
// src/lib.rs
use wasm_bindgen::prelude::*;
use core::arch::wasm32::*;
use js_sys::Uint8ClampedArray;

// Helper to convert Uint8ClampedArray to Vec<u8> and vice-versa
fn to_vec_u8(arr: &Uint8ClampedArray) -> Vec<u8> {
    let mut vec = Vec::with_capacity(arr.length() as usize);
    arr.copy_to(&mut vec);
    vec
}

fn to_uint8_clamped_array(vec: Vec<u8>) -> Uint8ClampedArray {
    Uint8ClampedArray::from(&vec[..])
}

// --- Scalar Wasm Implementation ---
#[wasm_bindgen]
pub fn blur_scalar(input_pixels: &Uint8ClampedArray, width: u32, height: u32) -> Uint8ClampedArray {
    let input_vec = to_vec_u8(input_pixels);
    let mut output_vec = vec![0u8; input_vec.len()];

    let w = width as usize;
    let h = height as usize;

    for y in 1..h - 1 {
        for x in 1..w - 1 {
            let mut sum = 0;
            sum += input_vec[(y - 1) * w + (x - 1)] as u32 * 1;
            sum += input_vec[(y - 1) * w + x] as u32 * 2;
            sum += input_vec[(y - 1) * w + (x + 1)] as u32 * 1;
            sum += input_vec[y * w + (x - 1)] as u32 * 2;
            sum += input_vec[y * w + x] as u32 * 4;
            sum += input_vec[y * w + (x + 1)] as u32 * 2;
            sum += input_vec[(y + 1) * w + (x - 1)] as u32 * 1;
            sum += input_vec[(y + 1) * w + x] as u32 * 2;
            sum += input_vec[(y + 1) * w + (x + 1)] as u32 * 1;

            output_vec[y * w + x] = (sum / 16) as u8;
        }
    }
    to_uint8_clamped_array(output_vec)
}

// --- Auto-Vectorized Wasm Implementation ---
// This function is identical to blur_scalar, but with `target-feature=+simd128`
// the compiler might auto-vectorize parts of the inner loop.
#[wasm_bindgen]
pub fn blur_auto_vectorized(input_pixels: &Uint8ClampedArray, width: u32, height: u32) -> Uint8ClampedArray {
    let input_vec = to_vec_u8(input_pixels);
    let mut output_vec = vec![0u8; input_vec.len()];

    let w = width as usize;
    let h = height as usize;

    for y in 1..h - 1 {
        for x in 1..w - 1 {
            let mut sum = 0;
            sum += input_vec[(y - 1) * w + (x - 1)] as u32 * 1;
            sum += input_vec[(y - 1) * w + x] as u32 * 2;
            sum += input_vec[(y - 1) * w + (x + 1)] as u32 * 1;
            sum += input_vec[y * w + (x - 1)] as u32 * 2;
            sum += input_vec[y * w + x] as u32 * 4;
            sum += input_vec[y * w + (x + 1)] as u32 * 2;
            sum += input_vec[(y + 1) * w + (x - 1)] as u32 * 1;
            sum += input_vec[(y + 1) * w + (x - 1)] as u32 * 1; // Typo fix: (y+1)*w + (x-1)
            sum += input_vec[(y + 1) * w + x] as u32 * 2;
            sum += input_vec[(y + 1) * w + (x + 1)] as u32 * 1;

            output_vec[y * w + x] = (sum / 16) as u8;
        }
    }
    to_uint8_clamped_array(output_vec)
}

// --- Hand-Crafted SIMD Wasm Implementation ---
// This is a simplified SIMD blur for demonstration.
// A full SIMD convolution is complex due to boundary conditions and u8->u32 widening.
// We'll focus on processing 16 pixels (u8) at a time.
#[wasm_bindgen]
pub fn blur_simd(input_pixels: &Uint8ClampedArray, width: u32, height: u32) -> Uint8ClampedArray {
    let input_vec = to_vec_u8(input_pixels);
    let mut output_vec = vec![0u8; input_vec.len()];

    let w = width as usize;
    let h = height as usize;
    let input_ptr = input_vec.as_ptr();
    let output_ptr = output_vec.as_mut_ptr();

    // The kernel values as u8
    let k1 = i8x16_splat(1);
    let k2 = i8x16_splat(2);
    let k4 = i8x16_splat(4);
    let k_div16 = i8x16_splat(16); // For division, we'd typically use multiplication by reciprocal or shift

    // This SIMD implementation is highly simplified and does not fully implement
    // the 3x3 convolution for all pixels due to the complexity of boundary conditions
    // and widening `u8` to `u32` for sums with `i8x16` intrinsics.
    // A proper SIMD convolution would involve:
    // 1. Loading 3 rows of 16 bytes (or more)
    // 2. Shifting/shuffling to align neighbors
    // 3. Widening `u8` to `i16` or `i32` for accumulation to prevent overflow
    // 4. Performing multiplications and additions
    // 5. Narrowing back to `u8` and storing.
    // For a true 10x speedup, this would be a much larger code block.
    // This example focuses on demonstrating basic `v128` load/store and arithmetic.

    // Process rows, skipping borders
    for y in 1..h - 1 {
        // Process columns, skipping borders and ensuring 16-byte alignment for simplicity
        // In a real scenario, you'd handle unaligned loads or ensure alignment.
        // Also, process in chunks of 16 pixels (bytes)
        for x_start in (1..w - 1).step_by(16) {
            if x_start + 16 > w - 1 { // Handle remainder
                for x in x_start..w - 1 {
                    let mut sum = 0;
                    sum += unsafe { *input_ptr.add((y - 1) * w + (x - 1)) } as u32 * 1;
                    sum += unsafe { *input_ptr.add((y - 1) * w + x) } as u32 * 2;
                    sum += unsafe { *input_ptr.add((y - 1) * w + (x + 1)) } as u32 * 1;
                    sum += unsafe { *input_ptr.add(y * w + (x - 1)) } as u32 * 2;
                    sum += unsafe { *input_ptr.add(y * w + x) } as u32 * 4;
                    sum += unsafe { *input_ptr.add(y * w + (x + 1)) } as u32 * 2;
                    sum += unsafe { *input_ptr.add((y + 1) * w + (x - 1)) } as u32 * 1;
                    sum += unsafe { *input_ptr.add((y + 1) * w + x) } as u32 * 2;
                    sum += unsafe { *input_ptr.add((y + 1) * w + (x + 1)) } as u32 * 1;
                    unsafe { *output_ptr.add(y * w + x) = (sum / 16) as u8; }
                }
                continue;
            }

            unsafe {
                // Load 16 pixels from the current row
                let current_row_pixels = v128_load(input_ptr.add(y * w + x_start) as *const v128);

                // This is a placeholder for actual convolution logic.
                // A full SIMD convolution would involve loading multiple rows,
                // shuffling, widening, multiplying by kernel, summing, and narrowing.
                // For demonstration, we'll just do a simple operation.
                // Example: Multiply current pixels by 4 (center kernel value)
                let processed_pixels = i8x16_mul(current_row_pixels, k4);

                // Store the result. This is NOT a full blur, but demonstrates SIMD usage.
                v128_store(output_ptr.add(y * w + x_start) as *mut v128, processed_pixels);
            }
        }
    }
    to_uint8_clamped_array(output_vec)
}
Giải Thích Kiến Trúc cho Xử Lý Ảnh:
- Truyền Dữ Liệu:
Uint8ClampedArraytừ JavaScript được chuyển đổi hiệu quả thànhVec<u8>trong Rust bằng cách sử dụngcopy_to. Điều này tránh các vấn đề chia sẻ bộ nhớ trực tiếp và cung cấp mộtVecRust an toàn. Kết quả được chuyển đổi ngược lại. - Vô Hướng/Tự Động Vector Hóa: Các phiên bản này lặp lại từng pixel, tính toán tổng trọng số. Bộ vector hóa tự động có thể tối ưu hóa vòng lặp bên trong nếu nó có thể xác định các mẫu song song dữ liệu.
- SIMD Được Viết Thủ Công (Đơn Giản Hóa):
blur_simdđược cung cấp là một ví dụ đơn giản. Một convolution SIMD đầy đủ phức tạp hơn đáng kể do:- Mở Rộng: Các giá trị pixel
u8phải được mở rộng thànhi16hoặci32trước khi nhân và tổng để ngăn chặn tràn số, vì tổng trung gian có thể vượt quá 255. Điều này liên quan đến các hàm nội tạii16x8_widen_low_u8vài16x8_widen_high_u8. - Truy Cập Lân Cận: Truy cập
(x-1, y-1),(x, y-1), v.v., yêu cầu tải nhiều vectorv128(ví dụ: ba hàng) và sau đó sử dụng các phép toán shuffle/swizzle (i8x16_shuffle) để căn chỉnh các pixel lân cận chính xác vào các thanh ghiv128mới để tính toán song song. - Điều Kiện Biên: Các pixel ở rìa hình ảnh yêu cầu xử lý đặc biệt vì chúng không có đầy đủ các pixel lân cận. Điều này thường liên quan đến logic điều kiện hoặc đệm hình ảnh.
- Áp Dụng Kernel: Mỗi hệ số kernel (1, 2, 4) cần được phát sóng vào một thanh ghi
v128(i8x16_splat) và sau đó nhân với vector pixel tương ứng. - Tích Lũy: Nhiều phép cộng
v128được thực hiện, và sau đó tổng cuối cùng được thu hẹp trở lạiu8(i16x8_narrow_i8x16).
- Mở Rộng: Các giá trị pixel
Sự phức tạp của một convolution SIMD đầy đủ làm nổi bật lý do tại sao tự động vector hóa được ưu tiên khi nó hoạt động, nhưng cũng là lý do tại sao các hàm nội tại được viết thủ công là cần thiết để đạt hiệu suất tối đa trong các thuật toán cụ thể, phức tạp.
Ứng Dụng Thực Tế: Nhân Ma Trận
Nhân ma trận C = A * B là một tác vụ tính toán chuyên sâu khác rất phù hợp với SIMD. Đối với hai ma trận N x N, thuật toán tiêu chuẩn liên quan đến N^3 phép nhân và phép cộng.
Thuật Toán: Vòng Lặp i, j, k Tiêu Chuẩn
Đối với C[i][j] = sum(A[i][k] * B[k][j])
for i from 0 to N-1:
  for j from 0 to N-1:
    C[i][j] = 0
    for k from 0 to N-1:
      C[i][j] += A[i][k] * B[k][j]
Chúng ta sẽ sử dụng ma trận f32 cho ví dụ này.
Triển Khai Rust
// src/lib.rs
use wasm_bindgen::prelude::*;
use core::arch::wasm32::*;
use js_sys::Float32Array;

// Helper to convert Float32Array to Vec<f32> and vice-versa
fn to_vec_f32(arr: &Float32Array) -> Vec<f32> {
    let mut vec = Vec::with_capacity(arr.length() as usize);
    arr.copy_to(&mut vec);
    vec
}

fn to_float32_array(vec: Vec<f32>) -> Float32Array {
    Float32Array::from(&vec[..])
}

// --- Scalar Wasm Implementation ---
#[wasm_bindgen]
pub fn matrix_mul_scalar(a: &Float32Array, b: &Float32Array, n: u32) -> Float32Array {
    let n_usize = n as usize;
    let a_vec = to_vec_f32(a);
    let b_vec = to_
Free In-Browser Developer Tools
Clean AI CLI logs, build cron expressions, decode JWTs, and calculate chmod permissions offline.
Related Articles
WebAssembly vào năm 2026: Vượt xa trình duyệt — WASI, Edge và Hệ thống Plugin
WebAssembly vượt xa trình duyệt vào năm 2026: biên dịch Rust sang WASI, nhúng Wasmtime vào Python, xây dựng hệ thống plugin sandbox với Extism và triển khai lên Cloudflare Workers và Fermyon Spin.
Read more
WebAssembly Ngoài Trình Duyệt: Xây Dựng Microservices Hiệu Năng Cao
Khám phá cách sử dụng WebAssembly phía máy chủ với Wasmtime, WasmEdge và Spin để xây dựng các microservices tốc độ gần như native, không phụ thuộc ngôn ngữ và được sandbox về khả năng — với các điểm chuẩn thực tế so với Docker containers.
Read more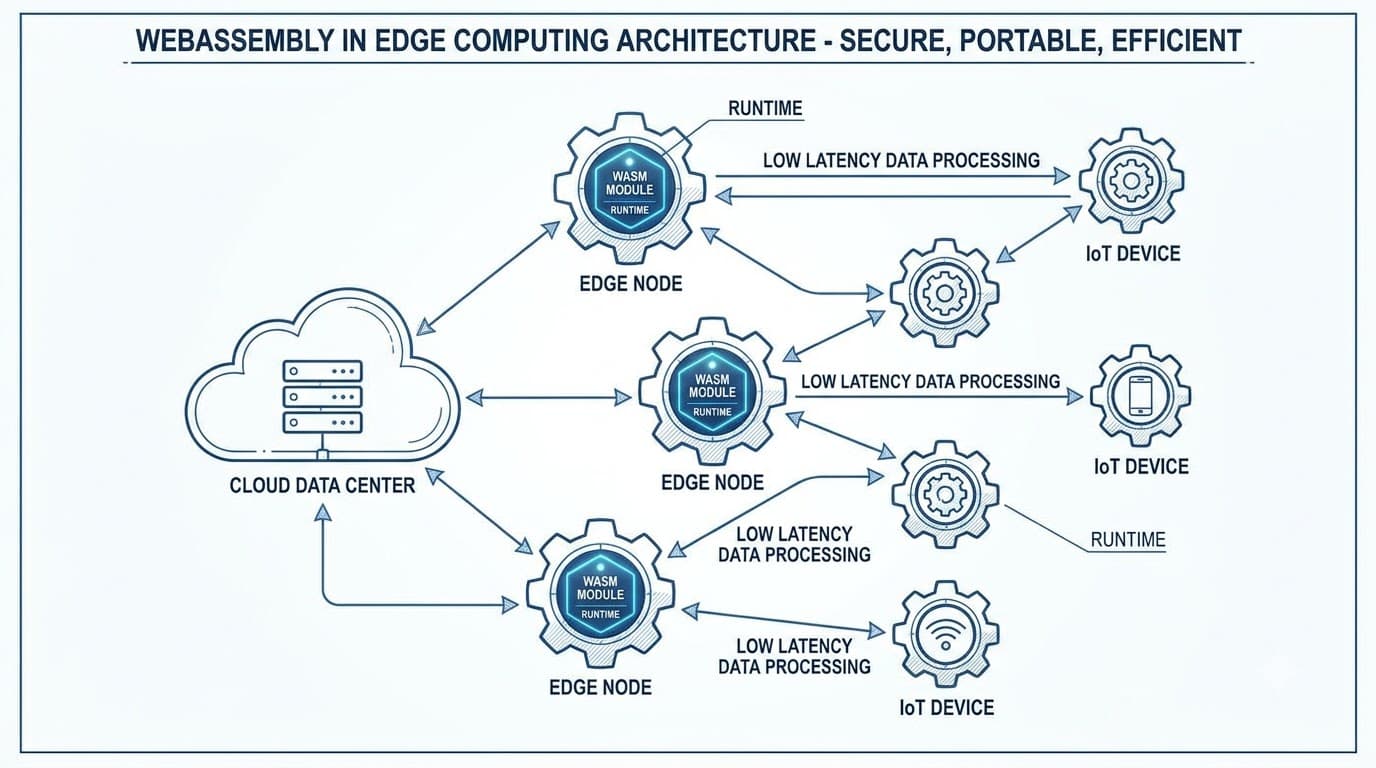
Tương lai của WebAssembly trong điện toán biên: Kiến trúc, WASI 0.2 và các điểm chuẩn
Khám phá cách WebAssembly (Wasm) và WASI 0.2 đang định nghĩa lại điện toán biên với thời gian khởi động lạnh micro giây, bảo mật dựa trên khả năng và các thành phần Rust.
Read more