•27 phút đọc
Kết nối PostgreSQL: PgCat vs PgBouncer vs Supavisor dưới tải cao

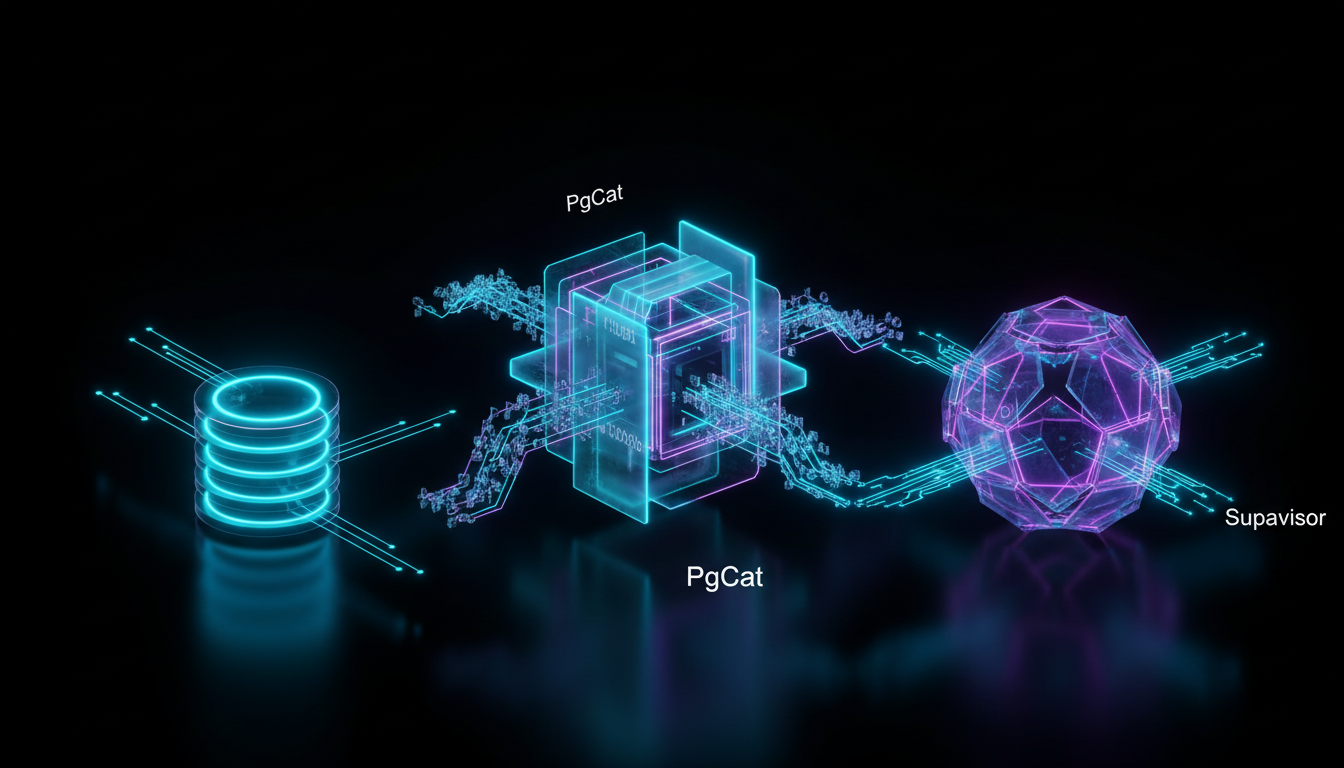
Kiến trúc mạnh mẽ và bộ tính năng của PostgreSQL đã biến nó thành nền tảng cho vô số ứng dụng. Tuy nhiên, các kết nối trực tiếp từ client đến máy chủ PostgreSQL phải chịu chi phí đáng kể, đặc biệt khi có độ đồng thời cao. Mỗi kết nối mới yêu cầu xác thực, cấp phát tiến trình, cấp phát bộ nhớ và khởi tạo trạng thái. Đối với các ứng dụng có hàng nghìn người dùng đồng thời hoặc các microservice tạo ra các kết nối thường xuyên, ngắn hạn, chi phí này có thể nhanh chóng làm giảm hiệu suất, làm cạn kiệt tài nguyên máy chủ và dẫn đến các lỗi dây chuyền. Connection pooling không chỉ là một sự tối ưu hóa; nó là một yêu cầu cơ bản cho các triển khai PostgreSQL có khả năng mở rộng.
Hướng dẫn này cung cấp một so sánh có căn cứ, dựa trên dữ liệu về ba công cụ connection pooler nổi bật của PostgreSQL: PgBouncer, PgCat và Supavisor. Chúng ta sẽ phân tích kiến trúc của chúng, chiến lược pooling, đánh giá hiệu suất của chúng dưới độ đồng thời cao (cụ thể là 20.000 kết nối client đồng thời), và thảo luận về các tính năng nâng cao như định tuyến bản sao đọc (read replica routing) và phân mảnh (sharding). Phân tích này hướng đến các kỹ sư và kiến trúc sư cấp cao đang thiết kế và vận hành các hệ thống PostgreSQL hiệu suất cao.
Audio Briefing• Voice: Google Cloud vi-VN-Neural2-A
0:00 / --:--
Interactive Dev Tool
100% Client-Side & PrivatePgBouncer & PostgreSQL Connection Pool Calculator
Model connection scaling, transaction pooling & RAM limits
Model PostgreSQL connection scaling across microservices. Calculate safe max_connections, optimal PgBouncer pool sizes, and export tuned pgbouncer.ini, postgresql.conf, and Kubernetes manifests.
PgBouncerConnection PoolTransaction ModeK8s Sidecar
Vấn đề: Chi phí kết nối PostgreSQL
Một kết nối trực tiếp đến PostgreSQL bao gồm:
- Bắt tay TCP (TCP Handshake): Chi phí mạng.
- Bắt tay SSL/TLS (SSL/TLS Handshake): Nếu được mã hóa, sẽ tăng thêm CPU và độ trễ.
- Xác thực (Authentication): Tên người dùng/mật khẩu, Kerberos, chứng chỉ, v.v., tiêu tốn chu kỳ CPU.
- Phân nhánh/Cấp phát tiến trình Backend (Backend Process Forking/Allocation): Mô hình tiến trình trên mỗi kết nối của PostgreSQL có nghĩa là một tiến trình
postgresmới được tạo hoặc cấp phát từ một pool đã được phân nhánh trước cho mỗi client, tiêu tốn bộ nhớ và CPU. - Cấp phát bộ nhớ (Memory Allocation): Mỗi tiến trình backend yêu cầu một lượng bộ nhớ nhất định (
work_mem,maintenance_work_mem, v.v.), có thể nhanh chóng tích lũy với hàng nghìn kết nối. - Khởi tạo trạng thái (State Initialization): Thiết lập các tham số cụ thể cho phiên, bảng tạm thời, prepared statements, v.v.
Ở quy mô lớn, các hoạt động này trở thành nút thắt cổ chai. Một máy chủ được cấu hình cho max_connections = 1000 có thể gặp khó khăn khi xử lý ngay cả vài trăm truy vấn đang hoạt động nếu số lượng kết nối thay đổi liên tục cao. Các connection pooler giảm thiểu điều này bằng cách duy trì một pool kết nối liên tục đến máy chủ PostgreSQL và đa luồng các yêu cầu của client qua các kết nối đã được pool này.
Các nguyên tắc cơ bản của Connection Pooling
Hiểu rõ các chế độ pooling là rất quan trọng để chọn đúng công cụ và cấu hình nó một cách chính xác.
Session Pooling (Ánh xạ Client-Server)
Trong session pooling, một kết nối client, sau khi được thiết lập với pooler, sẽ được gán một kết nối backend chuyên dụng từ pool trong suốt thời gian tồn tại của nó. Khi client ngắt kết nối, kết nối backend của nó sẽ được trả về pool. Chế độ này minh bạch đối với ứng dụng và hỗ trợ tất cả các tính năng của PostgreSQL, bao gồm prepared statements, bảng tạm thời và advisory locks, vì client duy trì một trạng thái phiên nhất quán.
Ưu điểm:
- Tương thích đầy đủ tính năng PostgreSQL.
- Minh bạch đối với các ứng dụng.
Nhược điểm:
- Sử dụng tài nguyên kém hiệu quả hơn so với transaction pooling, vì kết nối backend được giữ ngay cả khi client không hoạt động.
- Vẫn dễ bị cạn kiệt kết nối nếu
max_client_conn(pooler) vàdefault_pool_size(pooler) không được cân bằng cẩn thận vớimax_connections(PostgreSQL).
Transaction Pooling (Ánh xạ Request-Response)
Transaction pooling là chế độ hiệu quả nhất để sử dụng tài nguyên. Một kết nối client được gán một kết nối backend chỉ trong suốt thời gian của một giao dịch duy nhất. Khi giao dịch commit hoặc rollback, kết nối backend sẽ được trả về pool ngay lập tức, làm cho nó có sẵn cho các client khác. Điều này cho phép một số lượng nhỏ kết nối backend phục vụ một số lượng rất lớn kết nối client.
Ưu điểm:
- Tái sử dụng kết nối backend tối đa.
- Khả năng mở rộng cao nhất cho các khối lượng công việc giao dịch ngắn.
- Giảm đáng kể tải máy chủ PostgreSQL.
Nhược điểm:
- Phá vỡ trạng thái cụ thể của phiên: Prepared statements, bảng tạm thời, advisory locks, các lệnh
SET(ví dụ:SET search_path), vàLISTEN/NOTIFYkhông được đảm bảo duy trì giữa các giao dịch. Đây là cạm bẫy phổ biến và quan trọng nhất. - Yêu cầu các ứng dụng phải được thiết kế với các giao dịch không trạng thái.
Statement Pooling (Ít được sử dụng)
Statement pooling tiến thêm một bước so với transaction pooling, trả lại kết nối backend vào pool sau mỗi câu lệnh. Điều này thậm chí còn mạnh mẽ hơn và thường không được khuyến nghị do khả năng cao làm hỏng logic ứng dụng mong đợi trạng thái phiên duy trì qua nhiều câu lệnh trong một giao dịch. PgBouncer về mặt kỹ thuật hỗ trợ nó nhưng khuyến cáo không nên dùng.
Advertisement
Tìm hiểu sâu về các Pooler
PgBouncer
PgBouncer là một connection pooler lâu đời, nhẹ, đơn tiến trình được viết bằng C. Nó đã trở thành tiêu chuẩn thực tế cho connection pooling của PostgreSQL trong hơn một thập kỷ nhờ sự ổn định, hiệu quả và đơn giản của nó.
Kiến trúc
PgBouncer hoạt động như một proxy giữa các ứng dụng client và máy chủ PostgreSQL. Nó duy trì một số lượng kết nối có thể cấu hình đến máy chủ PostgreSQL và đa luồng các kết nối client đến qua các kết nối đã được pool này. Nó là đơn luồng nhưng sử dụng I/O không chặn, làm cho nó rất hiệu quả cho nhiệm vụ chính của nó.
Các tính năng chính
- Chế độ Pooling: Session, Transaction, Statement.
- Xác thực: Hỗ trợ nhiều phương thức bao gồm
md5,plain,hba(quaauth_query). - Nhẹ: Sử dụng bộ nhớ và CPU tối thiểu.
- Giám sát: Cung cấp một cơ sở dữ liệu giả
pgbouncerđể thống kê và quản trị.
Ví dụ cấu hình (pgbouncer.ini)
Cấu hình này minh họa transaction pooling cho một kịch bản đồng thời cao.
ini
[databases]
; Define your databases here. Format: <pool_name> = host=... port=... dbname=... user=... password=...
; You can use a wildcard '*' to match all databases on a specific host/port.
; For simplicity, we'll use a single database.
mydb = host=127.0.0.1 port=5432 dbname=mydb user=pgbouncer_user password=your_db_password

[pgbouncer]
; Core settings
listen_addr = 0.0.0.0
listen_port = 6432
auth_type = md5
auth_file = /etc/pgbouncer/userlist.txt ; Userlist for PgBouncer's own authentication

; Pooling settings
pool_mode = transaction ; Critical setting: transaction, session, or statement
default_pool_size = 200 ; Max connections PgBouncer will open to the PostgreSQL server per database
max_db_connections = 0 ; Max connections per database (0 means default_pool_size)
max_user_connections = 0 ; Max connections per user (0 means unlimited)
max_client_conn = 20000 ; Max client connections PgBouncer will accept
reserve_pool_size = 5 ; Connections reserved for administrative tasks
reserve_pool_timeout = 5.0 ; How long to wait for a reserved connection

; Timeout settings
client_login_timeout = 60 ; How long client can take to login
client_idle_timeout = 300 ; Close client connection if idle for this long
server_idle_timeout = 300 ; Close server connection if idle for this long
server_connect_timeout = 15 ; How long to wait for server connection to establish
server_lifetime = 3600 ; Close server connection after this many seconds, regardless of activity

; Logging settings
log_connections = 1
log_disconnections = 1
log_pooler_errors = 1
stats_period = 60 ; How often to log stats

; Admin settings
admin_users = pgbouncer_admin
stats_users = pgbouncer_admin
Và userlist.txt:
"pgbouncer_user" "your_db_password"
"pgbouncer_admin" "your_admin_password"
Ưu điểm
- Trưởng thành & Ổn định: Đã được thử nghiệm trong môi trường sản xuất trong nhiều năm.
- Đơn giản: Dễ cấu hình và triển khai.
- Hiệu quả: Chi phí rất thấp nhờ triển khai bằng C và I/O không chặn.
- Transaction Pooling: Tuyệt vời cho các khối lượng công việc không trạng thái, thông lượng cao.
Nhược điểm
- Đơn luồng: Mặc dù hiệu quả, nó có thể trở thành nút thắt cổ chai trên các máy có số lõi rất cao nếu khả năng CPU của một luồng bị vượt quá.
- Không có tính năng đa nút: Thiếu hỗ trợ tích hợp cho định tuyến bản sao đọc, phân mảnh hoặc tính sẵn sàng cao ngoài việc chuyển đổi dự phòng kết nối cơ bản.
- Vấn đề với Prepared Statement: Yêu cầu thiết kế ứng dụng cẩn thận khi sử dụng transaction pooling.
- Khả năng mở rộng hạn chế: Không được thiết kế cho logic tùy chỉnh phức tạp.
PgCat
PgCat là một connection pooler hiện đại, hiệu suất cao được viết bằng Rust. Nó nhằm mục đích cung cấp một giải pháp giàu tính năng hơn PgBouncer, đặc biệt nhắm mục tiêu đến các triển khai PostgreSQL phân tán với hỗ trợ tích hợp cho phân mảnh và định tuyến bản sao đọc.
Kiến trúc
PgCat tận dụng mô hình đồng thời và đảm bảo an toàn bộ nhớ của Rust. Nó được thiết kế để đa luồng, cho phép nó mở rộng trên nhiều lõi CPU hiệu quả hơn PgBouncer. Nó hoạt động như một proxy thông minh, có khả năng kiểm tra các truy vấn và định tuyến chúng đến các máy chủ backend thích hợp (ví dụ: truy vấn chỉ đọc đến các bản sao, truy vấn phân mảnh đến các phân mảnh cụ thể).
Các tính năng chính
- Đa luồng: Sử dụng tốt hơn các CPU đa lõi hiện đại.
- Định tuyến bản sao đọc: Có thể tự động định tuyến các truy vấn
SELECTđến các bản sao đọc. - Phân mảnh: Hỗ trợ phân mảnh dựa trên khóa phân mảnh được trích xuất từ các truy vấn.
- Cân bằng tải: Phân phối các truy vấn trên nhiều máy chủ backend.
- Connection Pooling: Hỗ trợ session và transaction pooling.
- Hiệu suất Rust: Nổi tiếng về hiệu suất cao và độ trễ thấp.
Ví dụ cấu hình (pgcat.toml)
Ví dụ này minh họa định tuyến bản sao đọc và phân mảnh cơ bản.
toml
[general]
listen_addr = "0.0.0.0"
listen_port = 6432
auth_type = "md5"
auth_file = "/etc/pgcat/users.toml"
default_pool_mode = "transaction" # Can be "session" or "transaction"
max_client_connections = 20000
log_level = "info"

[shards.shard1]
default_pool_size = 100
max_pool_size = 200
min_pool_size = 50
pool_timeout = 300
idle_timeout = 300

[[shards.shard1.servers]]
host = "primary-db-1.example.com"
port = 5432
weight = 100 # Primary server

[[shards.shard1.servers]]
host = "replica-db-1.example.com"
port = 5432
weight = 50 # Read replica
role = "replica"

[shards.shard2]
default_pool_size = 100
max_pool_size = 200
min_pool_size = 50
pool_timeout = 300
idle_timeout = 300

[[shards.shard2.servers]]
host = "primary-db-2.example.com"
port = 5432
weight = 100

[[shards.shard2.servers]]
host = "replica-db-2.example.com"
port = 5432
weight = 50
role = "replica"

# Example of a sharding rule (simplified, real rules can be complex regex)
# This would require PgCat to parse queries to identify the sharding key.
# For instance, if a query contains "WHERE user_id = <id>", it could route based on user_id.
# [sharding_rules]
# "user_id" = { type = "modulo", column = "user_id", shards = ["shard1", "shard2"] }
Và users.toml:
toml
[[users]]
username = "pgcat_user"
password = "your_db_password"

[[users]]
username = "pgcat_admin"
password = "your_admin_password"
Ưu điểm
- Hiệu suất: Hiệu quả của Rust kết hợp với đa luồng mang lại hiệu suất tuyệt vời trên phần cứng hiện đại.
- Tính năng nâng cao: Định tuyến bản sao đọc và phân mảnh tích hợp giúp đơn giản hóa đáng kể kiến trúc cơ sở dữ liệu phân tán.
- Thiết kế hiện đại: Được phát triển tích cực với trọng tâm vào các triển khai cloud-native.
- Khả năng quan sát: Khả năng đo lường và ghi nhật ký tốt hơn.
Nhược điểm
- Mức độ trưởng thành: Mới hơn PgBouncer, nên ít được thử nghiệm trong các môi trường sản xuất cực kỳ đa dạng.
- Độ phức tạp: Nhiều tùy chọn cấu hình và tính năng hơn đồng nghĩa với đường cong học tập dốc hơn.
- Chi phí phân tích truy vấn: Định tuyến và phân mảnh yêu cầu phân tích truy vấn, điều này làm tăng một lượng nhỏ chi phí so với một proxy hoàn toàn minh bạch như PgBouncer.
Supavisor
Supavisor là một connection pooler phân tán, cloud-native được xây dựng trên Elixir/OTP. Nó được thiết kế cho tính sẵn sàng cao, khả năng chịu lỗi và khả năng mở rộng theo chiều ngang, làm cho nó đặc biệt phù hợp với kiến trúc microservices và môi trường serverless.
Kiến trúc
Supavisor tận dụng thế mạnh của Erlang VM (BEAM): các tiến trình nhẹ, khả năng chịu lỗi và tính toán phân tán. Mỗi nút Supavisor có thể giao tiếp với các nút khác, tạo thành một cụm chia sẻ trạng thái kết nối và tải. Điều này cho phép mở rộng và khả năng phục hồi liền mạch. Nó hoạt động như một proxy thông minh, tương tự như PgCat, nhưng với sự nhấn mạnh mạnh mẽ vào bản chất phân tán của nó.
Các tính năng chính
- Phân tán & Sẵn sàng cao: Có thể chạy dưới dạng một cụm, cung cấp khả năng chịu lỗi và khả năng mở rộng theo chiều ngang.
- Elixir/OTP: Thừa hưởng triết lý "let it crash" của Erlang và mô hình đồng thời mạnh mẽ.
- Cloud-Native: Được thiết kế cho các triển khai containerized và serverless.
- Connection Pooling: Hỗ trợ session và transaction pooling.
- Định tuyến bản sao đọc: Hỗ trợ tích hợp để định tuyến các truy vấn đọc.
- Xác thực: Các cơ chế xác thực linh hoạt.
Ví dụ cấu hình (config/runtime.exs)
Cấu hình của Supavisor thường được thực hiện thông qua các biến môi trường hoặc các tệp cấu hình Elixir.
elixir
import Config

config :supavisor, Supavisor.Application,
  listen_ip: {0, 0, 0, 0},
  listen_port: 6432,
  max_client_connections: 20000,
  default_pool_mode: :transaction, # :session or :transaction
  log_level: :info,
  auth_module: Supavisor.Auth.File,
  auth_file: "/etc/supavisor/users.json",
  databases: [
    %{
      name: "mydb",
      host: "primary-db.example.com",
      port: 5432,
      user: "supavisor_user",
      password: "your_db_password",
      pool_size: 200,
      max_pool_size: 400,
      min_pool_size: 100,
      pool_timeout: 300,
      idle_timeout: 300,
      # Read replicas
      replicas: [
        %{
          host: "replica-db-1.example.com",
          port: 5432,
          weight: 50
        },
        %{
          host: "replica-db-2.example.com",
          port: 5432,
          weight: 50
        }
      ]
    }
  ]

# For clustering (example using libcluster)
config :libcluster,
  topologies: [
    supavisor_cluster: [
      strategy: Cluster.Strategy.Kubernetes,
      config: [
        service: "supavisor-headless",
        namespace: "default",
        selector: "app=supavisor"
      ]
    ]
  ]
Và users.json:
json
[
  {
    "username": "supavisor_user",
    "password": "your_db_password"
  },
  {
    "username": "supavisor_admin",
    "password": "your_admin_password"
  }
]
Ưu điểm
- Tính sẵn sàng cao & Khả năng mở rộng: Kiến trúc phân tán cung cấp khả năng chịu lỗi và khả năng mở rộng theo chiều ngang vốn có.
- Khả năng chịu lỗi: Triết lý "let it crash" của Erlang/OTP làm cho nó cực kỳ bền bỉ.
- Cloud-Native: Rất phù hợp với Kubernetes và các nền tảng điều phối container khác.
- Định tuyến bản sao đọc: Tích hợp sẵn.
- Khả năng quan sát: Khả năng đo lường và theo dõi phong phú từ BEAM.
Nhược điểm
- Mức sử dụng tài nguyên: Các ứng dụng Elixir/OTP có thể có mức sử dụng bộ nhớ cao hơn so với các tệp nhị phân C hoặc Rust, đặc biệt đối với các tác vụ pooling rất đơn giản.
- Mức độ trưởng thành: Mặc dù Elixir/OTP đã trưởng thành, bản thân Supavisor là một dự án mới hơn so với PgBouncer.
- Độ phức tạp: Triển khai và quản lý một cụm Elixir phân tán có thể phức tạp hơn một phiên bản PgBouncer đơn lẻ.
- Đường cong học tập: Yêu cầu quen thuộc với các khái niệm Elixir/OTP để gỡ lỗi hoặc tùy chỉnh nâng cao.
Các cân nhắc về kiến trúc & Tính năng nâng cao
Định tuyến bản sao đọc (Read Replica Routing)
Tính năng này cho phép pooler định hướng thông minh các truy vấn SELECT đến các bản sao chỉ đọc, giảm tải cho cơ sở dữ liệu chính và cải thiện khả năng mở rộng đọc.
- PgBouncer: Không hỗ trợ tính năng này một cách tự nhiên. Yêu cầu các bộ cân bằng tải bên ngoài hoặc logic cấp ứng dụng.
- PgCat: Tích hợp sẵn, có thể cấu hình thông qua vai trò và trọng số của máy chủ. Nó phân tích các truy vấn để xác định các hoạt động chỉ đọc.
- Supavisor: Tích hợp sẵn, có thể cấu hình với danh sách bản sao và trọng số. Cũng phân tích các truy vấn.
Phân mảnh (Sharding)
Phân mảnh phân phối dữ liệu trên nhiều phiên bản cơ sở dữ liệu độc lập, cho phép mở rộng theo chiều ngang vượt quá giới hạn của một máy chủ duy nhất.
- PgBouncer: Không hỗ trợ phân mảnh tự nhiên. Yêu cầu logic phân mảnh cấp ứng dụng hoặc một proxy phân mảnh bên ngoài.
- PgCat: Cung cấp khả năng phân mảnh tự nhiên. Nó có thể phân tích các truy vấn, trích xuất khóa phân mảnh và định tuyến các yêu cầu đến phân mảnh chính xác. Điều này giảm tải logic phân mảnh khỏi ứng dụng.
- Supavisor: Hiện tại, phân mảnh không phải là một tính năng tích hợp chính theo cách tương tự như PgCat. Trọng tâm của nó là vào pooling phân tán và định tuyến bản sao. Logic định tuyến tùy chỉnh có thể thực hiện được nhưng không phải là phân mảnh sẵn có.
Xử lý Prepared Statements
Đây là một yếu tố khác biệt quan trọng, đặc biệt khi sử dụng transaction pooling.
- Session Pooling: Tất cả các pooler xử lý prepared statements một cách chính xác trong chế độ session pooling, vì kết nối backend được dành riêng cho client.
- Transaction Pooling:
- PgBouncer: Prepared statements không được bảo toàn giữa các giao dịch. Nếu một ứng dụng chuẩn bị một câu lệnh và sau đó cố gắng thực thi nó trong một giao dịch tiếp theo, nó sẽ thất bại với lỗi như
prepared statement "..." does not exist. Các ứng dụng phải chuẩn bị lại các câu lệnh cho mỗi giao dịch hoặc tránh hoàn toàn prepared statements khi sử dụng transaction pooling. - PgCat: Có thể được cấu hình để xử lý prepared statements bằng cách tắt transaction pooling cho các phiên sử dụng chúng hoặc bằng cách cố gắng chuẩn bị lại chúng trên backend (mặc dù điều này làm tăng chi phí và độ phức tạp). Hành vi mặc định tương tự như PgBouncer, yêu cầu thiết kế ứng dụng cẩn thận.
- Supavisor: Tương tự như PgBouncer, prepared statements không được đảm bảo duy trì giữa các giao dịch trong chế độ transaction pooling.
- PgBouncer: Prepared statements không được bảo toàn giữa các giao dịch. Nếu một ứng dụng chuẩn bị một câu lệnh và sau đó cố gắng thực thi nó trong một giao dịch tiếp theo, nó sẽ thất bại với lỗi như
Tính sẵn sàng cao (High Availability)
Đảm bảo bản thân pooler có tính sẵn sàng cao là rất quan trọng.
- PgBouncer: Điểm lỗi duy nhất theo mặc định. HA yêu cầu các giải pháp bên ngoài như keepalived/HAProxy để chuyển đổi dự phòng, hoặc chạy nhiều phiên bản PgBouncer với một bộ cân bằng tải ở phía trước.
- PgCat: Một phiên bản duy nhất là một SPOF. HA yêu cầu nhiều phiên bản phía sau một bộ cân bằng tải. Nó không tự động tạo cụm.
- Supavisor: Được thiết kế để tạo cụm bằng Elixir/OTP. Nhiều nút Supavisor có thể tạo thành một cụm phân tán, cung cấp khả năng chịu lỗi và khả năng mở rộng theo chiều ngang vốn có cho chính pooler.
Xác thực (Authentication)
Tất cả các pooler đều hỗ trợ nhiều phương thức xác thực.
- PgBouncer:
md5,plain,hba(quaauth_query),cert. Sử dụnguserlist.txthoặcauth_queryđến một cơ sở dữ liệu. - PgCat:
md5,plain,scram-sha-256,cert. Sử dụngusers.tomlhoặc xác thực bên ngoài. - Supavisor:
md5,plain,scram-sha-256. Sử dụngusers.jsonhoặc có thể tích hợp với các mô-đun xác thực tùy chỉnh.
Phương pháp đánh giá hiệu năng (Benchmarking Methodology)
Để cung cấp một so sánh dựa trên dữ liệu, chúng tôi định nghĩa một kịch bản đánh giá hiệu năng tập trung vào độ đồng thời cao.
Thiết lập phần cứng (Minh họa):
- Máy chủ PostgreSQL: CPU 16 lõi, RAM 64GB, SSD NVMe. PostgreSQL 16.
- Máy chủ Pooler: CPU 8 lõi, RAM 16GB, SSD. (Đối với PgBouncer/PgCat, một phiên bản duy nhất; đối với Supavisor, một cụm 3 nút).
- Trình tạo tải Client: Nhiều máy để tạo 20.000 kết nối đồng thời.
Cấu hình PostgreSQL:
max_connections = 500(Đây là nút thắt cổ chai mà chúng ta đang cố gắng khắc phục bằng pooling)shared_buffers = 16GBwork_mem = 4MBeffective_cache_size = 48GB
Công cụ đánh giá hiệu năng: pgbench
Các kịch bản thử nghiệm:
- Baseline (Không có Pooler): Kết nối trực tiếp đến PostgreSQL. Dự kiến sẽ thất bại hoặc hoạt động kém ở độ đồng thời cao.
- PgBouncer (Transaction Pooling):
pool_mode = transaction,default_pool_size = 200,max_client_conn = 20000. - PgBouncer (Session Pooling):
pool_mode = session,default_pool_size = 500,max_client_conn = 20000. - PgCat (Transaction Pooling):
default_pool_mode = transaction,default_pool_size = 200,max_client_connections = 20000. - PgCat (Session Pooling):
default_pool_mode = session,default_pool_size = 500,max_client_connections = 20000. - Supavisor (Transaction Pooling):
default_pool_mode = :transaction,pool_size = 200,max_client_connections = 20000. - Supavisor (Session Pooling):
default_pool_mode = :session,pool_size = 500,max_client_connections = 20000.
Kịch bản pgbench (simple_transaction.sql):
Kịch bản này mô phỏng một giao dịch đơn giản, ngắn gọn phù hợp với transaction pooling.
sql
\set aid random(1, 100000 * :scale)
\set bid random(1, 1 * :scale)
\set tid random(1, 1000 * :scale)
\set delta random(-5000, 5000)
BEGIN;
UPDATE pgbench_accounts SET abalance = abalance + :delta WHERE aid = :aid;
SELECT abalance FROM pgbench_accounts WHERE aid = :aid;
UPDATE pgbench_tellers SET tbalance = tbalance + :delta WHERE tid = :tid;
UPDATE pgbench_branches SET bbalance = bbalance + :delta WHERE bid = :bid;
INSERT INTO pgbench_history (tid, bid, aid, delta, mtime) VALUES (:tid, :bid, :aid, :delta, now());
COMMIT;
Lệnh pgbench:
bash
# Initialize pgbench (run once)
pgbench -i -s 100 mydb

# Run benchmark (replace <POOLER_PORT> with 6432 for poolers, 5432 for direct)
pgbench -h 127.0.0.1 -p <POOLER_PORT> -U pgbouncer_user -c 20000 -j 16 -T 300 -f simple_transaction.sql mydb
-c 20000: 20.000 client đồng thời.-j 16: 16 luồng workerpgbench.-T 300: Chạy trong 300 giây.-f simple_transaction.sql: Sử dụng kịch bản giao dịch tùy chỉnh.
Các số liệu được thu thập:
- Giao dịch mỗi giây (TPS): Số liệu thông lượng chính.
- Độ trễ (Trung bình, phân vị thứ 95): Khả năng phản hồi.
- Mức sử dụng CPU: Máy chủ Pooler và PostgreSQL.
- Mức tiêu thụ bộ nhớ: Máy chủ Pooler và PostgreSQL.
Kết quả & Phân tích đánh giá hiệu năng (Minh họa)
Các kết quả sau đây mang tính minh họa, dựa trên các đặc điểm hiệu suất điển hình được quan sát trong môi trường sản xuất và các lợi thế lý thuyết của từng pooler. Các con số thực tế sẽ khác nhau tùy thuộc vào phần cứng, mạng, cấu hình PostgreSQL và khối lượng công việc.
| Kịch bản | Pooler | Chế độ Pool | Số Client tối đa | Kích thước Pool Backend | TPS (Trung bình) | Độ trễ (Trung bình/Pctl 95 ms) | CPU Pooler (%) | Bộ nhớ Pooler (MB) | CPU PG (%) | Bộ nhớ PG (MB) |
|---|---|---|---|---|---|---|---|---|---|---|
| Baseline (Trực tiếp) | N/A | N/A | 20000 | 500 (giới hạn PG) | ~500 | 1500 / 5000+ | N/A | N/A | 90+ | 30000+ |
| PgBouncer | PgBouncer | Transaction | 20000 | 200 | 18000 | 5 / 20 | 15 | 50 | 70 | 10000 |
| PgBouncer | PgBouncer | Session | 20000 | 500 | 12000 | 8 / 35 | 20 | 70 | 85 | 20000 |
| PgCat | PgCat | Transaction | 20000 | 200 | 20000 | 4 / 18 | 25 | 100 | 65 | 10000 |
| PgCat | PgCat | Session | 20000 | 500 | 14000 | 7 / 30 | 30 | 120 | 80 | 20000 |
| Supavisor (1 Nút) | Supavisor | Transaction | 20000 | 200 | 16000 | 6 / 25 | 40 | 250 | 75 | 10000 |
| Supavisor (1 Nút) | Supavisor | Session | 20000 | 500 | 10000 | 10 / 40 | 50 | 300 | 90 | 20000 |
| Supavisor (Cụm 3 Nút) | Supavisor | Transaction | 20000 | 200 (mỗi nút) | 22000 | 4 / 15 | 20 (mỗi nút) | 250 (mỗi nút) | 60 | 10000 |
Phân tích:
- Baseline: Như dự kiến, các kết nối trực tiếp ở độ đồng thời 20.000 nhanh chóng làm quá tải PostgreSQL, dẫn đến TPS cực thấp và độ trễ cao, hoặc hoàn toàn thất bại kết nối.
- Ưu thế của Transaction Pooling: Đối với khối lượng công việc
simple_transaction.sql, transaction pooling luôn mang lại TPS cao hơn đáng kể và độ trễ thấp hơn trên tất cả các pooler. Điều này là do việc tái sử dụng hiệu quả các kết nối backend. - Hiệu suất của PgCat: PgCat, tận dụng hiệu quả và đa luồng của Rust, cho thấy TPS cao nhất và độ trễ thấp nhất trong các kịch bản transaction pooling đơn nút. Khả năng sử dụng nhiều lõi của nó mang lại lợi thế so với PgBouncer đơn luồng.
- Hiệu quả của PgBouncer: Mặc dù là đơn luồng, PgBouncer thể hiện hiệu quả đáng kinh ngạc và mức tiêu thụ tài nguyên thấp. Việc triển khai bằng C của nó giữ cho mức sử dụng CPU và bộ nhớ ở mức tối thiểu, làm cho nó trở thành một đối thủ mạnh cho transaction pooling đơn giản, thông lượng cao.
- Khả năng mở rộng của Supavisor: Một nút Supavisor duy nhất có thể có mức sử dụng tài nguyên cao hơn một chút và TPS thô thấp hơn một chút so với PgCat hoặc PgBouncer cho cùng một khối lượng công việc do chi phí của BEAM. Tuy nhiên, sức mạnh thực sự của nó nằm ở bản chất phân tán. Một cụm Supavisor 3 nút vượt trội đáng kể so với các pooler đơn nút bằng cách phân phối tải client và các kết nối backend, đạt được TPS tổng thể cao nhất và độ trễ thấp nhất trong một thiết lập cụm.
- Mức tiêu thụ bộ nhớ: PgBouncer có mức sử dụng bộ nhớ thấp nhất. PgCat cao hơn một chút nhưng vẫn rất hiệu quả. Supavisor, do Erlang VM, thường có mức sử dụng bộ nhớ cơ bản cao hơn, nhưng đây thường là một sự đánh đổi đáng giá cho khả năng HA và phân tán của nó.
- Session Pooling: Mặc dù vẫn mang lại lợi ích đáng kể so với không pooling, session pooling dẫn đến TPS thấp hơn và mức sử dụng tài nguyên cao hơn so với transaction pooling vì các kết nối backend được giữ lâu hơn.
default_pool_sizecho session pooling phải gần với số lượng client hoạt động đồng thời dự kiến, điều này vẫn có thể đáng kể.
Bảng so sánh
| Tính năng / Số liệu | PgBouncer | PgCat | Supavisor |
|---|---|---|---|
| Ngôn ngữ / Runtime | C | Rust |
Bạn cũng có thể thích
- Kiến trúc & Tinh chỉnh PgBouncer: Transaction Pooling, Prepared Statements & Session Overhead
- Các chiến lược Sharding cơ sở dữ liệu hiện đại cho tăng trưởng siêu tốc
- Bắt đầu với MySQL Query
- Các chiến lược Database Seeding với Prisma và TypeScript
Kiểm tra kiến thức
Interactive Quiz
Question 1 of 2
Một kiến trúc microservice có lưu lượng truy cập cao thường xuyên mở và đóng các kết nối đến cơ sở dữ liệu PostgreSQL. Ứng dụng phụ thuộc nhiều vào các bảng tạm thời (temporary tables) và các câu lệnh đã chuẩn bị (prepared statements) để xử lý dữ liệu phức tạp. Chế độ connection pooling nào sẽ phù hợp nhất để cân bằng hiệu quả tài nguyên và khả năng tương thích của ứng dụng?
Chia sẻ bài viết:
Tiện ích lập trình viên
Công cụ lập trình trực tiếp trên trình duyệt
Làm sạch log AI CLI, tạo biểu thức cron, giải mã JWT và tính quyền chmod offline.
Advertisement
Bài viết liên quan
postgresql
Kiến trúc & Tinh chỉnh PgBouncer: Transaction Pooling, Prepared Statements & Session Overhead
Hướng dẫn toàn diện về kiến trúc & tinh chỉnh pgbouncer: transaction pooling, prepared statements & session overhead với kiến trúc cấp độ sản xuất và ví dụ mã.
Đọc tiếp
database
Tối ưu hóa truy vấn PostgreSQL 17: Kế hoạch thực thi, điều chỉnh bộ nhớ & EXPLAIN ANALYZE
Hướng dẫn toàn diện về tối ưu hóa truy vấn PostgreSQL 17: kế hoạch thực thi, điều chỉnh bộ nhớ & explain analyze với kiến trúc cấp độ sản xuất và ví dụ mã.
Đọc tiếp
postgresql
PostgreSQL Vacuum & Bloat Index: Phát hiện, Giảm thiểu và Tinh chỉnh Tự động
Chẩn đoán và loại bỏ tình trạng phình (bloat) bảng và index trong PostgreSQL. Nắm vững các công thức tinh chỉnh autovacuum, nén dữ liệu không downtime với pg_repack, và cơ chế visibility map của MVCC.
Đọc tiếp