KubernetesにおけるLinuxcgroupsv2:PSI、メモリ制限、OOMシールド

目次(16 項目)
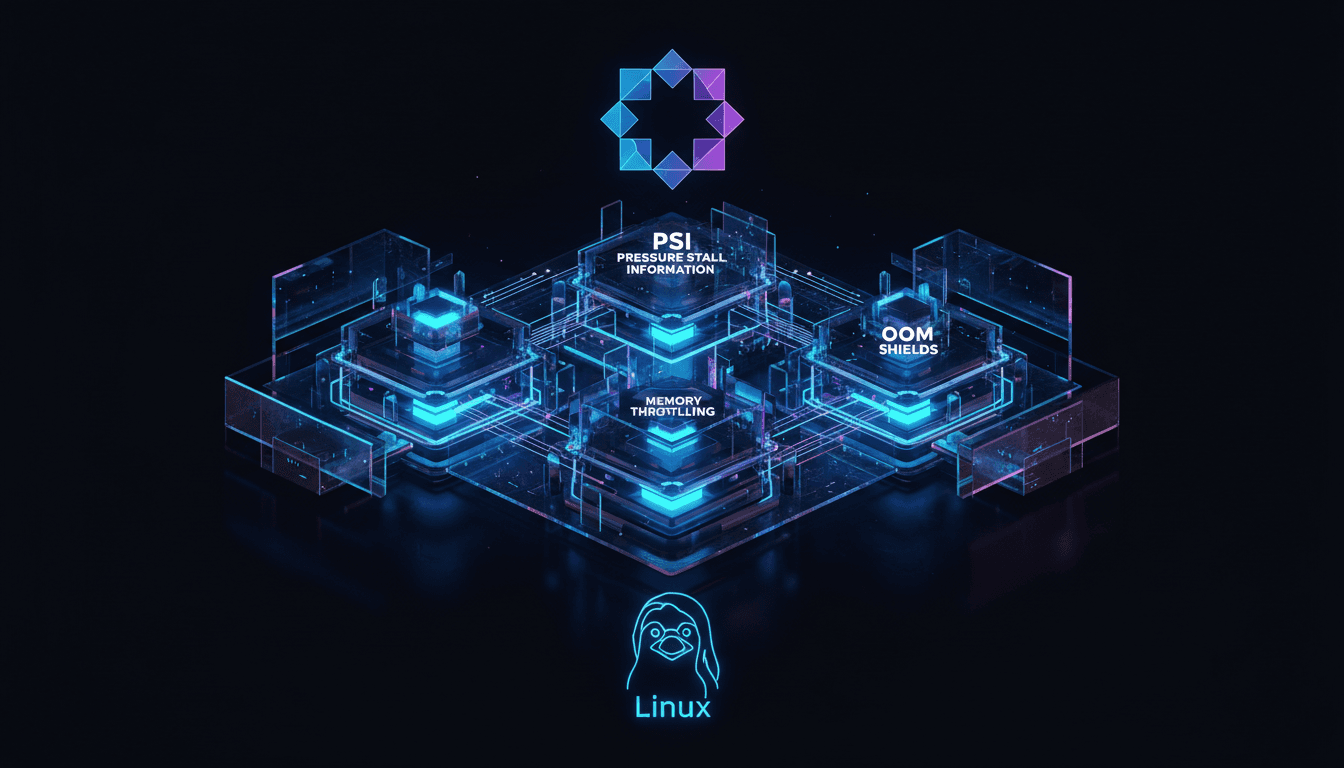
Linux cgroups v2は、リソース管理における根本的なアーキテクチャの変革を意味します。v1の断片化された階層から、統一されたツリー状の構造へと移行しました。この進化は、Kubernetesのような最新のコンテナオーケストレーションプラットフォームにとって極めて重要であり、より正確で予測可能なリソース分離を可能にします。このガイドでは、cgroups v2の運用上の影響について、メモリ管理、PSI(Pressure Stall Information)、およびKubernetesにおけるOOM保護戦略に焦点を当てて詳しく説明します。
Cgroups v1 vs. v2: アーキテクチャのパラダイムシフト
Cgroups v1は、断片化された階層の問題を抱えていました。各コントローラー(例: cpu、memory、blkio)はそれぞれ独立した階層を持つことができ、単一のプロセスに対して複雑でしばしば競合するリソース割り当てを引き起こしていました。プロセスは異なるリソースタイプに対して異なるcgroupに属することができ、一貫したリソース管理を困難にしていました。
Cgroups v2は、統一された階層を導入します。すべてのコントローラーは単一のツリー状の階層にアタッチされます。プロセスはこの階層内の厳密に1つのcgroupに属し、そのcgroupに適用されるすべてのリソースコントローラーがプロセスに適用されます。この簡素化により、より一貫性があり堅牢なリソース管理モデルが提供されます。
主要なアーキテクチャの違い
| 機能 | Cgroups v1 | Cgroups v2 |
|---|---|---|
| 階層 | 複数、独立 | 単一、統一 |
| プロセスメンバーシップ | 複数のcgroup(コントローラーごとに1つ) | 単一のcgroup |
| コントローラーのアタッチ | 任意のcgroup | リーフノードのみ(例外あり) |
| 委譲 | 複雑、エラーが発生しやすい | 簡素化、明示的 |
| リソースファイル | 一貫性のない命名 | 標準化された命名(cgroup.<controller>.<metric>) |
| メモリアカウンティング | 精度が低い | より詳細、memory.stat |
| PSI | 利用不可 | 統合済み |
v2の統一された階層は、委譲とリソースアカウンティングを簡素化します。親cgroupはサブツリーを子に委譲でき、子は階層の他の部分に影響を与えることなく、そのサブツリー内のリソース管理を完全に制御できます。これは、個々のPodやコンテナのcgroupを管理するcontainerdやCRI-Oのようなコンテナランタイムにとって非常に重要です。
Cgroups v2におけるメモリ管理
Cgroups v2は、プログレッシブなスロットリングのためのmemory.highの導入と、OOM動作の改善により、メモリ管理機能を大幅に強化します。
memory.max: ハードリミット
memory.maxは、cgroupの絶対的なメモリ制限を定義します。cgroupのメモリ使用量がこの値を超えると、カーネルのOOMキラーが呼び出され、そのcgroup内のプロセスが終了されます。これはcgroups v1のmemory.limit_in_bytesに相当します。
memory.high: ソフトリミットとスロットリングメカニズム
memory.highはcgroups v2における重要な追加機能です。これはソフトメモリリミットとして機能します。cgroupのメモリ使用量がmemory.highを超えると、カーネルはmemory.maxに達する前にそのcgroupからメモリを再利用しようとします。これは以下の方法で達成されます。
- ページキャッシュの排出: クリーンなページキャッシュページを積極的に破棄します。
- スワップアウト: 匿名メモリページをディスクにスワップします(スワップが有効な場合)。
- 直接再利用: cgroup内のプロセスにメモリを同期的に再利用するよう強制します。
このプログレッシブなスロットリングメカニズムは、メモリを大量に消費するプロセスの速度を落とすことでOOMキルを防ぎ、フットプリントを削減する機会を与えたり、他のプロセスがリソースを解放するのを可能にしたりすることを目的としています。これは、memory.maxによってトリガーされる突然のOOMキルと比較して、メモリプレッシャー下でのより優雅な劣化を提供します。
実践例: メモリ制限の設定
メモリリクエストとリミットを持つKubernetes Podを考えてみましょう。Kubernetesはこれらをcgroup v2の設定に変換します。
apiVersion: v1
kind: Pod
metadata:
  name: memory-intensive-app
spec:
  containers:
  - name: app
    image: busybox
    command: ["sh", "-c", "while true; do sleep 1; done"]
    resources:
      requests:
        memory: "256Mi"
      limits:
        memory: "512Mi"
cgroup v2が有効なシステムと、cgroups v2を使用するように設定されたkubeletを前提とすると、コンテナランタイム(例: containerd)はこのPodのcgroupを作成します。コンテナのcgroupのmemory.maxは512Miに設定されます。memory.highの値は通常、memory.requestまたはmemory.maxのパーセンテージから派生します。これはコンテナランタイムの設定によります。containerdの場合、memory.highは明示的に設定されていないか、memory.requestが指定されていない限り、デフォルトでmemory.maxに設定されることがよくあります。
実行中のコンテナのcgroup v2設定を手動で確認してみましょう。
# Find the cgroup path for a container (e.g., from a pod named 'memory-intensive-app')
# First, get the container ID
CONTAINER_ID=$(kubectl get pod memory-intensive-app -o jsonpath='{.status.containerStatuses[0].containerID}' | cut -d'/' -f2)

# Assuming containerd, the cgroup path is typically under /sys/fs/cgroup/system.slice/containerd.service/
# and then a path derived from the container ID.
# A more robust way is to use systemd-cgls or findmnt
CGROUP_PATH=$(find /sys/fs/cgroup -name "*${CONTAINER_ID}*" -type d | head -n 1)

echo "Cgroup path: $CGROUP_PATH"

# Read memory limits
cat "${CGROUP_PATH}/memory.max"
cat "${CGROUP_PATH}/memory.high"
cat "${CGROUP_PATH}/memory.current"
cat "${CGROUP_PATH}/memory.stat"
memory.statファイルは、anon(匿名メモリ)、file(ページキャッシュ)、kernel_stack、slab、その他様々なメトリックを含む詳細なメモリアカウンティングを提供します。この詳細なデータは、メモリ問題のデバッグに非常に役立ちます。
PSI(Pressure Stall Information)
PSIは、Linux 4.20で導入されたカーネル機能で、タスクがCPU、メモリ、I/Oリソースを待機するのに費やした時間の集計メトリックを提供します。リソース使用率(例: CPU使用率)を示す従来のメトリックとは異なり、PSIはリソース競合とスタベーションを定量化します。「リソースが利用できないために、私のプロセスはどれくらいの時間停止しているのか?」という問いに答えます。
PSIメトリックは/proc/pressure/およびcgroup v2ディレクトリ内で公開されます。
PSIメトリックの説明
各リソース(CPU、メモリ、I/O)について、PSIは3つのメトリックを提供します。
some: 少なくとも1つのタスクがこのリソースを待機して停止していた時間の割合。full: すべてのタスクがこのリソースを待機して停止していた時間の割合。これは、システム全体またはcgroup全体の完全なボトルネックを示します。total: タスクが停止していた累積時間(マイクロ秒単位)。
/proc/pressure/memoryからの出力例:
some avg10=0.00 avg60=0.00 avg300=0.00 total=0
full avg10=0.00 avg60=0.00 avg300=0.00 total=0
ここで、avg10、avg60、avg300はそれぞれ10秒、60秒、300秒間の平均停止割合を表します。
Cgroups v2におけるPSI
各cgroup v2ディレクトリには、cpu.pressure、memory.pressure、およびio.pressureファイルが含まれています。これらのファイルは、そのcgroupとその子孫内のタスクに特化したPSIメトリックを報告します。これにより、個々のPodやアプリケーション内のリソース競合をきめ細かく監視できます。
# Example: Read memory pressure for a specific cgroup
cat "${CGROUP_PATH}/memory.pressure"
可観測性のためのPSIの利用
PSIは、OOMキルやアプリケーションの応答不能といった壊滅的な障害につながる前にリソースボトルネックを検出するための強力なシグナルです。
- 高い
memory.pressure some: cgroup内の一部のプロセスがメモリ競合を経験していることを示します。これはmemory.highスロットリング、さらにはOOMキルの前兆となる可能性があります。 - 高い
memory.pressure full: cgroup全体が深刻なメモリ不足に陥っており、アプリケーションのフリーズにつながる可能性があることを示唆しています。 - 高い
cpu.pressure some: 一部のタスクがCPUを待機しています。CPUスロットリングまたはCPUの過負荷を示している可能性があります。 - 高い
io.pressure full: すべてのタスクがI/Oを待機しています。I/Oボトルネックの明確な兆候です。
KubernetesでPSIメトリックを監視することで、リソース飽和に対する早期警告を提供し、プロアクティブなスケーリングやリソース調整を可能にします。Prometheusエクスポーターは、集中監視のためにcgroupパスからこれらのメトリックをスクレイピングできます。
OOMシールドとsystemd-oomd
memory.highはスロットリングメカニズムを提供しますが、深刻なメモリプレッシャーは依然としてOOMキルにつながる可能性があります。Kubernetesクラスターでは、重要なシステムデーモン(例: kubelet、containerd、kube-proxy、node-exporter)をユーザーワークロードによるOOMキルから保護する必要があります。
ノードアロケータブルとクリティカルPod
Kubernetesは「ノードアロケータブル(Node Allocatable)」機能を使用して、システムデーモンのリソースを予約します。これはkubeletフラグを介して設定されます。
--kube-reserved: Kubernetesシステムデーモン(例:kubelet、kube-proxy)のために予約されたリソース。--system-reserved: OSシステムデーモン(例:sshd、journald)のために予約されたリソース。--eviction-hard: エビクションのしきい値を定義します。
これらの予約は、Podリクエストの合計がアロケータブル容量を超えないようにし、重要なコンポーネントのための余裕を確保します。しかし、これはスケジューリングメカニズムであり、厳密なOOM保護ではありません。ユーザーPodがその制限を超えて消費したり、システムデーモン自体がメモリリークを起こしたりした場合でも、OOMは発生する可能性があります。
systemd-oomd: プロアクティブなOOM防止
systemd-oomdは、cgroups v2とPSIと連携して動作するユーザー空間OOMキラーです。カーネルOOMキラー(リアクティブでしばしば「間違った」プロセスをキルする)を待つのではなく、systemd-oomdはPSIメトリックとmemory.highイベントを使用してcgroupのメモリプレッシャーを監視します。持続的なメモリプレッシャーを検出すると、設定可能なポリシーに基づいて、プレッシャーに最も貢献しているプロセスまたはcgroupをプロアクティブに終了します。
systemd-oomdは以下のように設定できます。
- 特定のcgroupを監視: 重要なシステムcgroupを保護します。
- OOMしきい値を定義: PSI
someまたはfullの割合、またはmemory.highイベントに基づきます。 - キルポリシーを指定: どのプロセスを最初にキルするか(例: 最大のメモリ消費者、最も古いプロセス)。
systemd-oomd設定例(/etc/systemd/oomd.conf)
[OOM]
# Enable oomd
Enable=true

# Global memory pressure thresholds
# If memory.pressure.some reaches 20% for 30s, consider action
MemoryPressureDurationSec=30s
MemoryPressureThreshold=20%

# Action to take when pressure is detected
# Can be 'kill', 'warn', 'none'
DefaultMemoryPressureAction=kill

# Protect system services from being killed by oomd
# This is crucial for Kubernetes nodes
ProtectSystem=true

# Protect specific cgroups (e.g., kubelet)
# This is typically handled by ProtectSystem=true if kubelet is a systemd service
# or by configuring specific cgroup paths.
# Example: Protect the cgroup for kubelet.service
# CGroup=/system.slice/kubelet.service
Kubernetesの場合、systemd-oomdはkubelet.service、containerd.service、およびその他の重要なコンポーネントのcgroupを保護するように設定できます。これにより、ユーザーワークロードからの深刻なメモリプレッシャー下でも、コントロールプレーンとノードインフラストラクチャが安定した状態を保つことができます。
systemd-oomdとKubernetesの統合
- cgroups v2を有効にする: Linuxディストリビューションとカーネルがcgroups v2をサポートし、設定されていることを確認します。ほとんどの最新ディストリビューション(例: Fedora 31+、Ubuntu 20.04+、RHEL 8+)はデフォルトでcgroups v2を使用するか、サポートしています。
- 確認:
stat -f /sys/fs/cgroupはType: cgroup2fsと表示されるはずです。 kubeletがcgroup v2モードで実行されていることを確認:kubeletログでcgroupfsドライバーとsystemdcgroupドライバーを確認します。
- 確認:
systemd-oomdのインストールと設定:systemd-oomdパッケージをインストールします。システムサービスを保護するように/etc/systemd/oomd.confを設定します。- PSIの監視: PSIメトリックを監視スタック(例: Prometheus Node Exporter)に統合します。高い
memory.pressure値でアラートを設定します。 - ノードアロケータブル: 重要なコンポーネントのリソースを予約するために、
--kube-reservedと--system-reservedをkubeletで適切に設定します。
本番環境での落とし穴とトラブルシューティング
-
Cgroups v1とv2の不一致:
- 症状:
kubeletが起動しない、またはコンテナがcgroupエラーで起動しない。kubectl describe nodeにcgroupドライバーの警告が表示される。 - 原因: ホストOSがcgroups v1で実行されているが、
kubeletがv2用に設定されている、またはその逆。あるいは、カーネルはv2だが、kubeletがcgroupfsドライバーではなくsystemdドライバー用に設定されている。 - 修正: ホストOSがcgroups v2(カーネル5.x+)で実行されていることを確認します。
kubeletをcgroups v2に推奨されるsystemdcgroupドライバーを使用するように設定します。必要に応じて、cgroupモードの変更後にノードを再起動します。yaml# /etc/kubernetes/kubelet.conf (or similar kubelet config file) apiVersion: kubelet.config.k8s.io/v1beta1 kind: KubeletConfiguration cgroupDriver: systemd
- 症状:
-
積極的な
memory.highスロットリング:- 症状: アプリケーションが中程度のメモリ負荷で応答しなくなる、または高いレイテンシを経験するが、OOMキルされない。
- 原因:
memory.highが低すぎるため、時期尚早なスロットリングが発生している。これは、memory.requestが実際のワーキングセットよりも大幅に低く、memory.highがmemory.requestから派生している場合に発生する可能性があります。 - 修正: アプリケーションの典型的なメモリ使用量をよりよく反映するように
memory.requestを調整します。重要なアプリケーションの場合、memory.highをmemory.maxに近づけるか、アプリケーションがスロットリングに敏感な場合は無効にすることを検討します(ただし、これによりOOMのリスクが増加します)。containerdのようなコンテナランタイムには、memory.highの設定方法を調整するための設定オプションがある場合があります。
-
systemd-oomdによる予期しないプロセスのキル:- 症状: ユーザーワークロードではなく、重要なアプリケーションプロセスが
systemd-oomdによってキルされる。 - 原因:
systemd-oomdの設定が積極的すぎるか、重要なcgroupを適切に除外していない。 - 修正:
oomd.confを確認します。ProtectSystem=trueが設定されていることを確認します。特定の重要なアプリケーションがユーザーサービスとして実行されている場合、それらのcgroupが明示的に保護されているか、oomdのポリシーが重要度の低いワークロードのキルを優先するように設定されていることを確認します。oomctlを使用して、systemd-oomdの状態と決定を検査します。
- 症状: ユーザーワークロードではなく、重要なアプリケーションプロセスが
-
PSIメトリックの誤解釈:
- 症状: PSIメトリックでアラートが発生するが、実際のパフォーマンス低下は観察されない。
- 原因:
someとfullの意味を誤解しているか、アラートしきい値が低すぎる。someプレッシャーの短いスパイクは、しばしば正常です。 - 修正: 重要なサービスについては、持続的な高い
fullプレッシャーに焦点を当てます。someプレッシャーについては、傾向を調べ、他のメトリック(例: レイテンシ、エラー率)と相関させます。観察されたベースラインと許容可能なパフォーマンス低下に基づいてアラートしきい値を調整します。
-
カーネルOOMキラーが依然としてアクティブ:
- 症状:
systemd-oomdが有効になっているにもかかわらず、カーネルOOMキラーが介入する。 - 原因:
systemd-oomdのしきい値が十分に積極的でないか、メモリプレッシャーがoomdが反応するには速すぎる。カーネルOOMキラーは究極のフォールバックです。 - 修正:
systemd-oomdのMemoryPressureThresholdとMemoryPressureDurationSecをよりプロアクティブになるように調整します。oomdが正しいcgroupを監視していることを確認します。急速なメモリプレッシャーの根本原因を調査します。
- 症状:
よくある質問
-
なぜcgroups v2に移行すべきなのですか? Cgroups v2は、統一された階層を提供し、リソース管理を簡素化し、委譲を改善し、
memory.highによるより詳細なメモリアカウンティングとプロアクティブなスロットリングを提供します。これはLinuxリソース制御の未来であり、PSIやsystemd-oomdのような機能には必須です。最新のKubernetesバージョンとコンテナランタイムは、cgroups v2向けに最適化が進んでいます。 -
memory.highはmemory.maxとどう違いますか?memory.maxはハードリミットであり、これを超えるとカーネルOOMキラーがトリガーされます。memory.highはソフトリミットであり、これを超えるとcgroup内でプロアクティブなメモリ再利用とスロットリングがトリガーされ、memory.maxへの到達とOOMキルを防ぐことを目指します。memory.highは、メモリプレッシャー下でのより優雅な劣化を提供します。 -
cgroups v1と
systemd-oomdでKubernetesを実行できますか? いいえ。systemd-oomdはcgroups v2の統一された階層とPSIメトリックに大きく依存しており、これらはcgroups v1では完全に利用可能または一貫して公開されていません。プロアクティブなOOM防止のためにsystemd-oomdを活用するには、cgroups v2環境が必須です。 -
cgroups v2で
memory.requestとmemory.limitを設定するためのベストプラクティスは何ですか?memory.requestをアプリケーションの典型的なワーキングセットサイズに設定します。これはmemory.highに影響を与え、適切なスケジューリングを保証します。memory.limit(memory.maxとなる)を、アプリケーションが不安定になることなく消費できる絶対最大メモリに設定します。memory.limitを高く設定しすぎると、ノードのリソース枯渇につながる可能性があるため避けてください。一般的な戦略は、memory.requestをある程度のバーストを許容する値に設定し、memory.limitを暴走するメモリ使用を防ぐ値に設定することです。 -
KubernetesでPSIメトリックを監視するにはどうすればよいですか? Prometheus Node Exporterは、
/proc/pressure/およびcgroup v2パスからPSIメトリックを公開できます。Prometheusを設定してこれらのメトリックをスクレイピングし、node_pressure_cpu_some_total、node_pressure_memory_full_total、および特定のcgroupの同様のメトリックに基づいてGrafanaダッシュボードとアラートルールを設定できます。これにより、リソース競合に関する重要な洞察が得られます。
Free In-Browser Developer Tools
Clean AI CLI logs, build cron expressions, decode JWTs, and calculate chmod permissions offline.
Related Articles
本番環境におけるeBPF:低オーバーヘッドなLinuxオブザーバビリティ、トレーシング、カーネルプロファイリング
eBPFを使用して、オーバーヘッドを最小限に抑えたLinuxカーネルのオブザーバビリティを実装します。システムコールのレイテンシ測定、メモリ割り当ての追跡、サイドカーなしでのネットワークソケット監視を解説します。
Read more
Rustでの高スループットLinux I/O: io_uring、Tokio、ゼロコピーネットワーキング
Rustにおける高スループットLinux I/Oを網羅したガイド。io_uring、Tokio、ゼロコピーネットワーキングを本番環境レベルのアーキテクチャとコード例で解説します。
Read more
Kubernetes OperatorsとCustom Resources: あらゆるものを自動化する
KubernetesのコントロールプレーンをOperatorとCustom Resource Definition (CRD) で拡張し、複雑なステートフルアプリケーションのライフサイクル管理を自動化する方法を学び、reconciliationループ、RBAC、テスト、本番環境パターンについて解説します。
Read more