Kubernetes HPAとカスタムPrometheusメトリクス:CPUスケーリングを超えて (2026)

Table of Contents
長らくの間、KubernetesのPodは標準的な方法でスケールしていました。CPUまたはメモリが80%に達すると、レプリカを追加していました。CPU使用率が40%程度で推移しているにもかかわらず、リクエストのバックログが原因でAPIがタイムアウトしていることに気づくまでは、この方法で問題ありませんでした。
標準的なノードリソースのメトリクスだけでは、全体像を把握できないことがよくあります。CPU使用率が完全に正常に見えても、アプリケーションがワーカーのスレッド不足に陥っていたり、メッセージキューで溢れかえっていたりする可能性があります。この問題を解決するには、Kubernetes Horizontal Pod Autoscaler (HPA) をPrometheusのアプリケーションメトリクスに直接接続し、HTTPリクエスト/秒のような「実際の」トラフィック需要に基づいてスケールできるようにすることです。
カスタムメトリクスによるオートスケーリングの仕組み
カスタムメトリクスによるスケーリングは、最初は魔法のように聞こえますが、単なる配管です。HPAはCustom Metrics API集約レイヤーにクエリを送信し、このレイヤーがリクエストをアダプター(Prometheus Adapterなど)にルーティングします。このアダプターは、生のPrometheus時系列データをKubernetesメトリクスオブジェクトに変換します。
HPAは15秒ごとに起動し、custom.metrics.k8s.ioにクエリを送信します。アダプターはPromQLクエリを実行し、現在の値を返します。HPAは、新しいPodを起動する必要があるかどうかを計算します。
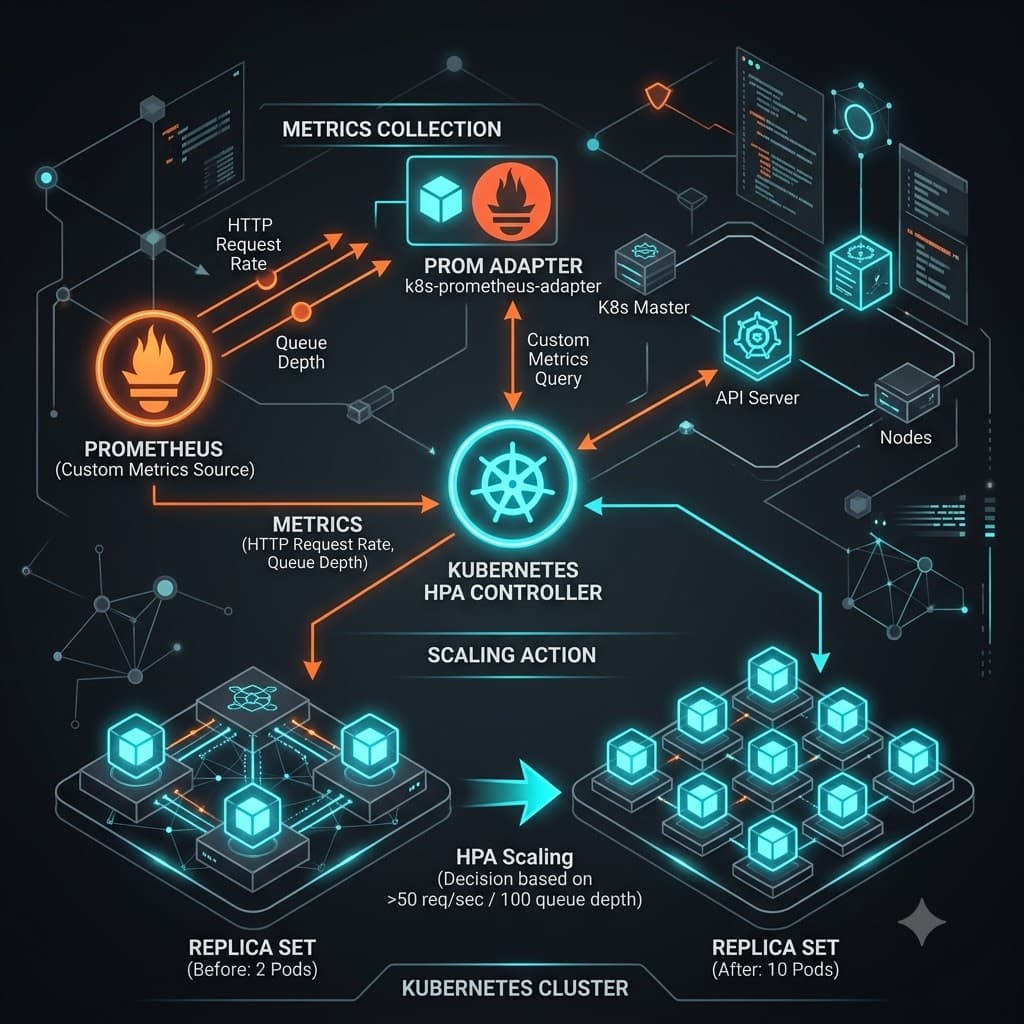
内部の制御フローを理解することで、クラスター設定時の一般的なアーキテクチャ上の間違いを防ぐことができます。Kubernetesコントロールプレーンは、アプリケーションのエンドポイントを直接スクレイピングしません。代わりに、アプリケーションは/metricsのようなHTTPエンドポイントでPrometheus形式のメトリクスを公開します。Prometheusはこれらのエンドポイントを継続的にスクレイピングし、時系列レコードをローカルストレージデータベースに保存し、クエリできるようにします。Prometheus Adapterは、custom.metrics.k8s.io/v1beta1インターフェースを実装するAPI拡張サーバーとして機能します。Prometheusサーバーに対して登録されたPromQLクエリを定期的に実行し、計算結果をキャッシュし、Horizontal Pod Autoscalerコントローラーによって開始されたAPIリクエストに応答します。
決定論的なスケーリング動作を保証するために、カスタムメトリクス値はPod、Namespace、Serviceなどの特定のKubernetesリソースに関連付けられている必要があります。APIサーバーは、メトリクス定義とターゲットワークロードセレクター間の厳密なラベルマッチングを強制します。アプリケーションメトリクスにPod名ラベルやNamespace識別子がない場合、アダプターはスカラー値を個々のPodインスタンスにマッピングできません。この分離により、クラスター制御ループが特定の監視ベンダーから隔離され、プラットフォームオペレーターは洗練されたPromQLクエリを記述する完全な柔軟性を得ることができます。
スケーリングの決定中にテレメトリメトリクスがコントロールプレーンコンポーネントをどのように流れるかについてのアーキテクチャの概要を以下に示します。
+------------------+         Scrapes         +--------------------+
| Application Pod  | <---------------------- | Prometheus Server  |
|  (/metrics)      |                         |  (TSDB Storage)    |
+------------------+                         +--------------------+
         ^                                             ^
         |                                             | PromQL Queries
         | Managed By                                  v
+------------------+     Queries API         +--------------------+
| HPA Controller   | ----------------------> | Prometheus Adapter |
| (Control Loop)   |  custom.metrics.k8s.io  | (API Extension)    |
+------------------+                         +--------------------+
カスタムメトリクス用のPrometheus Adapterルールを構成する方法
カスタムメトリクス用のPrometheus Adapterルールは、アダプター設定マップを編集して、シリーズマッチング正規表現パターン、リソース関連付け、メトリクス命名テンプレート、および明示的なPromQL集約クエリを定義することで構成します。設定ファイルは、生のPrometheusメトリクスシリーズがクエリ可能なKubernetes APIエンドポイントにどのように変換されるかを管理します。明示的なアダプタールールがない場合、APIサーバーはカスタムアプリケーションメトリクスをHorizontal Pod Autoscalerコントローラーに公開しません。
設定ファイルは、各ルールブロックに対してseriesQuery、resources、name、metricsQueryの4つの主要セクションで構成されています。seriesQueryは、特定のメトリクス名パターンとラベルキーの存在に一致するPrometheusからの候補時系列を選択します。resourcesブロックは、kubernetes_pod_nameやnamespaceのようなPrometheusメトリクスラベルを、podやnamespaceのようなKubernetes APIリソースタイプにマッピングします。nameブロックは、生のPrometheusメトリクスをカスタムメトリクスAPIによって提示されるクリーンなメトリクス名に名前変更します。最後に、metricsQueryは、オートスケーラーがスカラー値を要求するときにメトリクスを集約するために使用される正確なPromQL式を定義します。
生のHTTPリクエストレートをPodレベルのメトリクスに変換する、本番環境対応のPrometheus Adapter用Helm values.yaml設定ブロックの完全な例を以下に示します。
rules:
  default: false
  custom:
    - seriesQuery: 'http_requests_total{kubernetes_pod_name!="",kubernetes_namespace!=""}'
      resources:
        overrides:
          kubernetes_namespace: {resource: "namespace"}
          kubernetes_pod_name: {resource: "pod"}
      name:
        matches: "^(.*)_total"
        as: "${1}_per_second"
      metricsQuery: 'sum(rate(<<.Series>>{<<.LabelMatchers>>}[2m])) by (<<.GroupBy>>)'
    - seriesQuery: 'queue_depth_messages{kubernetes_pod_name!="",kubernetes_namespace!=""}'
      resources:
        overrides:
          kubernetes_namespace: {resource: "namespace"}
          kubernetes_pod_name: {resource: "pod"}
      name:
        matches: "^(.*)"
        as: "queue_depth_messages"
      metricsQuery: 'sum(<<.Series>>{<<.LabelMatchers>>}) by (<<.GroupBy>>)'
<<.Series>>、<<.LabelMatchers>>、<<.GroupBy>>のようなテンプレート変数がクエリ評価をどのように動的にしているかに注目してください。HPAがdefault名前空間のPodに対してメトリクスhttp_requests_per_secondを要求すると、Prometheus Adapterは<<.Series>>をhttp_requests_totalに置き換え、<<.LabelMatchers>>にPod名フィルターを設定し、<<.GroupBy>>をkubernetes_pod_nameに設定します。この自動パラメーター置換により、単一のルールパターンで、クラスター全体で実行されている数百の異なるマイクロサービスに対応でき、アプリケーションごとに定型的なクエリを記述する必要がありません。
metricsQueryを定義する際は、カウンターメトリクスに対しては、瞬間的なゲージ値ではなく、2分間のような短い時間枠でのレート関数を常に使用する必要があります。生のカウンター値は時間とともに継続的に増加するため、直接的なターゲットしきい値には適していません。rate()を適用すると、生のカウンターがリアルタイムのワークロードスループットを反映する秒間レートに変換されます。さらに、Helm設定でdefault: falseを設定すると、アダプターが何千もの未使用のクラスターメトリクスを自動的に検出するのを防ぎ、アダプターPodのCPUオーバーヘッドとメモリ消費を劇的に削減します。
カスタムPrometheusメトリクスを使用してHPAマニフェストを定義する方法
カスタムPrometheusメトリクスを使用してHPAマニフェストを定義するには、v2をapiVersionとして指定し、メトリクスソースタイプとしてPodsまたはObjectを選択し、metrics配列でターゲットメトリクスしきい値を設定します。Kubernetes autoscaling/v2 API仕様は、リソース、カスタムPod、オブジェクト、外部メトリクスなど、複数のメトリクスタイプをネイティブにサポートしています。Podレベルのカスタムメトリクスをターゲットにする場合は、type: Podsを選択し、Prometheus Adapterルールによって公開される正確な名前に一致するようにmetric.nameを設定する必要があります。
HPAマニフェストのspecでは、type: Podsは、メトリクス値がターゲットワークロード内のすべてのアクティブなPodで平均化する必要があるPodごとのメトリクスであることをコントローラーに伝えます。メトリクスターゲットは、50や500m(0.5リクエスト/秒を表す)のような数量を持つtype: AverageValueを使用する必要があります。オートスケーラーは、実行中のすべてのPodのメトリクス値を合計し、現在のレプリカ数で割り、その結果を指定されたターゲット平均値と比較して、スケールアウトまたはスケールインするかどうかを決定します。
以下は、PodごとのHTTPリクエストスループットに基づいてAPIデプロイメントをスケールする本番マニフェストです。
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: api-service-hpa
  namespace: production
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: api-service
  minReplicas: 3
  maxReplicas: 30
  metrics:
    - type: Pods
      pods:
        metric:
          name: http_requests_per_second
        target:
          type: AverageValue
          averageValue: "35"
名前空間に属さないリソースや、AWS SQSキューやRedisリストの深さのような外部システムに基づいてデプロイメントをスケールする必要がある場合は、type: Podsの代わりにtype: Externalまたはtype: Objectを使用する必要があります。例えば、バックグラウンドキューワーカーのデプロイメントをスケールする場合、メトリクス値は個々のワーカーPod内で測定される値ではなく、キューの合計長さを反映します。このシナリオでは、ObjectまたはExternalターゲットの下にtype: Valueを設定することで、HPAは合計キュー長をPodあたりの必要なワークロード処理能力で割ることができます。
単一のHPAマニフェストで複数のメトリクスソースを組み合わせることで、ミッションクリティカルなデプロイメントに対して信頼性の高いフェイルセーフスケーリング保証を提供できます。metrics配列に複数のメトリクスが設定されている場合、Horizontal Pod Autoscalerは各メトリクスに対して提案されるレプリカ数を個別に計算し、計算されたレプリカ数の最大値を選択します。これは、リクエストレートが低いままでも、高価なガベージコレクションサイクルによってCPU使用率が突然急増した場合、HPAはサービス可用性を保護するためにPodをスケールアップすることを意味します。
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 75
    - type: Pods
      pods:
        metric:
          name: http_requests_per_second
        target:
          type: AverageValue
          averageValue: "35"
カスタムメトリクスAPIエラーとHPA障害モードのトラブルシューティング方法
カスタムメトリクスAPIエラーのトラブルシューティングは、kubectl get --rawで生のカスタムメトリクスREST APIエンドポイントにクエリを実行し、Prometheus AdapterログでPromQL実行の失敗を確認し、HPAリソースを記述してステータス条件を検査することで行います。HPAがunable to fetch metricまたはinvalid metric valueを報告する場合、問題はほとんどの場合、ラベルマッチングの不一致またはアダプター設定エラーにあります。直接APIクエリを実行することで、障害がPrometheusデータ取り込み、アダプタークエリ変換、またはKubernetes RBAC権限のいずれに起因するかを特定できます。
カスタムメトリクス障害を診断する最初のステップは、拡張APIサーバーがKubernetesコントロールプレーン内で登録され、正常であることを確認することです。kubectl get apiservices v1beta1.custom.metrics.k8s.ioを実行すると、AVAILABLE: Trueが表示されるはずです。ステータスがfalseまたはdegradedと表示される場合は、Prometheus Adapterデプロイメントが実行中、正常、およびポート6443でTLS経由でアクセス可能であることを確認してください。APIアグリゲーターとアダプター間の証明書検証が失敗すると、カスタムメトリクスクエリは接続拒否エラーで即座に失敗します。
APIサービスの健全性を確認したら、kubectlを使用して生のカスタムメトリクスエンドポイントに直接クエリを実行し、メトリクスが公開されていることを確認します。
kubectl get --raw "/apis/custom.metrics.k8s.io/v1beta1/namespaces/production/pods/*/http_requests_per_second" | jq .
このコマンドが空のアイテムリストを返す場合、Prometheus Adapterは、ルールのseriesQueryとラベル基準を満たすPrometheus内のメトリクスシリーズを見つけることができません。アプリケーションPodがkubernetes_pod_nameやpodのような正確なラベルキーでメトリクスをエクスポートしていることを確認してください。ServiceMonitorを使用する一般的なPrometheusスクレイピング設定では、Podラベルをpod_nameまたはinstanceに名前変更することがよくあります。ラベルキーがアダプターのルールオーバーライドと一致しない場合、アダプターは時系列データをKubernetes Podリソースに関連付けることができず、APIクエリ応答が空になります。
kubectl describe hpa api-service-hpa -n productionを使用してHPAリソースのステータス条件セクションを検査します。コマンド出力には、詳細なイベントログとAbleToScale、ScalingActive、ScalingLimitedなどのアクティブな条件が含まれます。ScalingActiveがFalseと理由FailedGetResourceMetricを表示している場合は、kubectl logs -n monitoring -l app.kubernetes.io/name=prometheus-adapterを使用してPrometheus Adapter Podログを確認してください。明示的なPromQL構文エラー、Prometheusへの接続時のHTTPタイムアウト警告、または標準認証の失敗を探してください。
一般的な運用上の障害モードとその根本原因の解決策は次のとおりです。
| 観測されたHPAエラーメッセージ | 根本原因メカニズム | 修正ステップ |
|---|---|---|
unable to fetch metric: no metrics returned | アダプタールールとPrometheus TSDB間のラベルキーの不一致 | スクレイピングされたPodラベルと一致するようにseriesQueryラベルオーバーライドを更新する |
selector missing from metric | Prometheus AdapterルールにPodリソースマッピングがない | resources.overridesがPrometheusラベルをpodにマッピングしていることを確認する |
API server request timeout | Prometheusサーバーが重いPromQLクエリ負荷に苦しんでいる | アダプターのmetricsQueryを最適化するか、Prometheusリソースを増やす |
invalid metric value: scalar expected | PromQLクエリがPodラベルグループ化なしでベクトルを返している | アダプタールールPromQLにby (<<.GroupBy>>)集約を追加する |
HPAスケーリング動作と安定化ウィンドウを調整する方法
HPAのスケーリング動作は、autoscaling/v2仕様内のbehaviorフィールドを設定して、明示的なスケールアップおよびスケールダウンの安定化ウィンドウ、レート制限、およびステップサイズポリシーを設定することで調整します。デフォルトでは、HPAコントローラーはメトリクスしきい値が破られたときに迅速にスケールアップしますが、急激な変動を防ぐためにスケールダウンアクションを実行する前に5分間待機します。これらの安定化ウィンドウをカスタマイズすることで、突然のトラフィックスパイク時に迅速なスケーリング応答を確保しつつ、一時的なトラフィックの減少時の時期尚早なPod終了を防ぎます。
behaviorセクションでは、システムエンジニアがscaleUpとscaleDownポリシーブロックを使用して、両方向のスケーリング速度をきめ細かく制御できます。各ブロックは、明示的なpoliciesの配列とともにstabilizationWindowSeconds設定をサポートしています。stabilizationWindowSecondsは、オートスケーラーが過去に計算された推奨事項を一定期間保持し、スケールアップ操作では最高の推奨事項を、スケールダウン操作では最低の推奨事項を選択するようにします。このアルゴリズムは、バースト的なバックグラウンドタスクや短期間のトラフィックスパイクによって引き起こされるメトリクスノイズを平滑化します。
以下は、積極的なスケールアップを可能にしつつ、保守的なスケールダウンを適用する高度な動作設定です。
spec:
  behavior:
    scaleUp:
      stabilizationWindowSeconds: 0
      selectPolicy: Max
      policies:
        - type: Percent
          value: 100
          periodSeconds: 15
        - type: Pods
          value: 4
          periodSeconds: 15
    scaleDown:
      stabilizationWindowSeconds: 300
      selectPolicy: Min
      policies:
        - type: Percent
          value: 10
          periodSeconds: 60
この本番環境設定では、scaleUpに対してstabilizationWindowSeconds: 0を設定することで、オートスケーラーはメトリクス平滑化を待たずにメトリクススパイクに即座に対応するように指示されます。selectPolicy: Maxディレクティブは、両方のポリシーが評価された場合、より高いPod数を生成するポリシーが適用されることを保証します。HPAは、レプリカ数を2倍にする(100%増加)か、15秒ごとに最大4個のPodを追加することができます。これにより、予期しないクライアントトラフィックが本番エンドポイントに到達した際のPod容量の枯渇を防ぎます。
逆に、scaleDown設定はstabilizationWindowSeconds: 300(5分)を設定し、Podを終了する前にトラフィック量が継続的に低い状態を保証します。スケールダウン速度は、既存のレプリカ数の10%(periodSeconds: 60)に厳密に制限されます。Podの終了を遅らせることで、Podの終了が残りのPodに過剰なトラフィックを処理させ、即座に再スケールサイクルを引き起こす連鎖的な過負荷シナリオを防ぎます。
スケーリング動作を調整する際には、Prometheusのスクレイピング間隔をHPAの評価ループと合わせる必要もあります。Prometheusが30秒ごとにメトリクスをスクレイピングしているのに、アダプターが2分間のレート平均を計算している場合、30秒未満の短いトラフィックバーストではスケーリングアクションがトリガーされない可能性があります。高頻度スケーリングワークロードでは、アプリケーションスクレイパーが10〜15秒ごとに実行されるようにし、アダプターのPromQLレートウィンドウを少なくとも4つのスクレイピング間隔をカバーするように設定して、一時的なメトリクス欠落を防ぐようにしてください。
本番GrafanaダッシュボードでHPAパフォーマンスメトリクスを監視する方法
本番GrafanaダッシュボードでHPAパフォーマンスメトリクスを監視するには、kube_horizontalpodautoscaler_status_current_replicas、kube_horizontalpodautoscaler_status_desired_replicas、およびカスタムメトリクスターゲットの飽和レベルを時系列で追跡します。HPAテレメトリを集中ダッシュボードに統合することで、プラットフォームエンジニアは誤って設定されたスケーリングしきい値を特定し、スケーリングの振動を検出し、ワークロードの容量計画を評価できます。専用のダッシュボードの可視性がないと、スケーリングの非効率性がアプリケーションの応答遅延を静かに悪化させたり、クラウドインフラストラクチャの費用を膨らませたりする可能性があります。
Prometheusは、kube-state-metricsを通じてKubernetes HPAテレメトリをエクスポートし、オートスケーラーの制御ループの決定をリアルタイムで可視化します。主要なメトリクスには、kube_horizontalpodautoscaler_spec_min_replicas、kube_horizontalpodautoscaler_spec_max_replicas、kube_horizontalpodautoscaler_status_desired_replicasがあります。必要なレプリカと実際に実行されているPodレプリカをプロットすることで、スケーリングの遅延を測定し、コンテナの起動時間がワークロード容量の拡張を遅らせているかどうかを特定できます。
以下は、クラスター全体のHPAスケーリングヘッドルーム飽和度を計算するための本番PromQL式です。
sum(kube_horizontalpodautoscaler_status_current_replicas{namespace="production"}) by (horizontalpodautoscaler)
/
sum(kube_horizontalpodautoscaler_spec_max_replicas{namespace="production"}) by (horizontalpodautoscaler) * 100
この飽和度クエリが100%に近づくと、デプロイメントは最大レプリカ上限に達しており、受信トラフィックスパイクに対応するためにそれ以上拡張できません。高いHPA飽和度でGrafanaアラートを設定すると、アプリケーションのリクエスト遅延がSLA境界を超える前に、オンコールSREチームにmaxReplicas制限を増やすよう通知します。
はい、ベンダー提供のメトリクスアダプター(Datadog Cluster AgentやKEDA(Kubernetes Event-driven Autoscaling)など)をデプロイすることで、外部SaaSプロバイダーからのメトリクスを使用してKubernetesデプロイメントをスケールできます。HPAマニフェストでtype: Externalを設定し、ベンダーアダプターによって定義されたメトリクス名を指定します。
カスタムメトリクス(custom.metrics.k8s.io)は、PodやServiceのようなKubernetesクラスターオブジェクトに直接アタッチされます。外部メトリクス(external.metrics.k8s.io)は、AWS SQSキューの長さや外部データベースのレイテンシーなど、特定のクラスターオブジェクトとは独立して存在するグローバルメトリクスを表します。
kubectl get --raw "/apis/custom.metrics.k8s.io/v1beta1"を実行してルールがロードされていることを確認します。これにより、アダプターによってクラスター名前空間全体で公開されているすべてのカスタムメトリクスの完全なJSONリストが返されます。
これは、PrometheusがターゲットPodのスクレイピングされたメトリクスを欠いている場合、アダプタールールでラベルマッチャーが誤って設定されている場合、またはPodが最近デプロイされた場合に発生します。Prometheusがターゲットメトリクスをアクティブにスクレイピングしており、シリーズラベル名がアダプター設定と一致していることを確認してください。
こちらもおすすめ
- Prometheus Grafanaアラートとバーンレート設計
- k6 Grafana分散負荷テストとパフォーマンスプロファイリング
- PactとNode.jsによるマイクロサービス契約テスト
- Playwright E2Eテスト:ゼロフレークテストのための4つのルール
よくある質問
Kubernetes HPAとは何ですか?
Kubernetes Horizontal Pod Autoscaler (HPA) は、観測されたメトリクスに基づいてDeploymentまたはStatefulSet内のPodレプリカ数を自動的にスケールします。デフォルトではCPUとメモリ使用率に基づいてスケールしますが、カスタムメトリクスAPIを使用すると、HTTPリクエストレート、キューの深さ、レイテンシーパーセンタイル、またはビジネスレベルのシグナルなど、任意のPrometheusメトリクスに基づいてスケールできます。
Kubernetes HPAはCPUの代わりにカスタムメトリクスでスケールできますか?
はい。HPA v2は3つのメトリクスソースをサポートしています。リソースメトリクス(CPU/メモリ)、カスタムメトリクスAPIを介した独自のPodからのカスタムメトリクス、およびクラスター外のシステムからの外部メトリクスです。Prometheus Adapterをインストールすることで、Prometheus PromQLクエリをKubernetesカスタムメトリクスAPIにブリッジし、HPAがそれらをスケーリングシグナルとして直接使用できるようにします。
Prometheus Adapterとは何ですか?なぜ必要ですか?
Prometheus Adapterは、PrometheusのメトリクスクエリをKubernetesカスタムメトリクスAPIが期待する形式に変換するKubernetes APIサーバー拡張です。これがないと、HPAはPrometheusメトリクスを読み取ることができません。Helm経由でインストールし、PromQL式をKubernetesメトリクス名にマッピングするルールを定義し、HPAマニフェストでそれらのメトリクス名を参照します。
カスタムメトリクス用のKubernetes HPA v2マニフェストはどのように記述しますか?
apiVersion: autoscaling/v2を設定し、spec.metricsの下で、Prometheus Adapterで定義したルールと一致するpods.metric.nameを持つtype: Podsを使用します。pods.target.averageValueをPodごとのしきい値に設定します。HPAコントローラーは、デフォルトで15秒ごとにカスタムメトリクスAPIをポーリングし、すべてのPodでメトリクスがターゲット平均に保たれるようにレプリカを調整します。
カスタムメトリクスでHPAがスケールしない場合のトラブルシューティング方法を教えてください。
kubectl describe hpa <name>を実行して、現在のメトリクス値とエラー条件を確認します。一般的な失敗原因としては、Prometheus Adapterがインストールされていないか誤って設定されている、HPA specのメトリクス名がアダプターのルール名と一致しない、PrometheusがターゲットPodをスクレイピングしていない、またはRBAC権限が不足しているなどが挙げられます。kubectl get --raw "/apis/custom.metrics.k8s.io/v1beta1"を使用して、メトリクスAPIに到達可能であり、メトリクスがリストされていることを確認します。
Free In-Browser Developer Tools
Clean AI CLI logs, build cron expressions, decode JWTs, and calculate chmod permissions offline.
Related Articles
Kubernetesにおけるゼロダウンタイムデプロイメント: Pod Disruption Budget、preStopフック、グレースフルシャットダウン
Kubernetesで真のゼロダウンタイムデプロイメントを実現する方法。Pod Disruption Budget、terminationGracePeriodSeconds、preStopフック、Ingressのコネクションドレイニングを適切に設定します。
Read more
ArgoCD GitOpsマルチクラスタデプロイメントパターン
ArgoCD ApplicationSets、Hub-and-Spokeクラスタアーキテクチャ、sync waves、環境値オーバーレイを活用したマルチクラスタGitOpsを習得しましょう。
Read more
GitHubActionsセルフホストランナーのセキュリティ強化
ActionsRunnerController(ARC)、ネットワーク分離、rootlessコンテナ、短命OIDCトークンを使用して、セルフホスト型GitHubActionsランナーを強化します。
Read more