Mở rộng tìm kiếm vector với pgvector
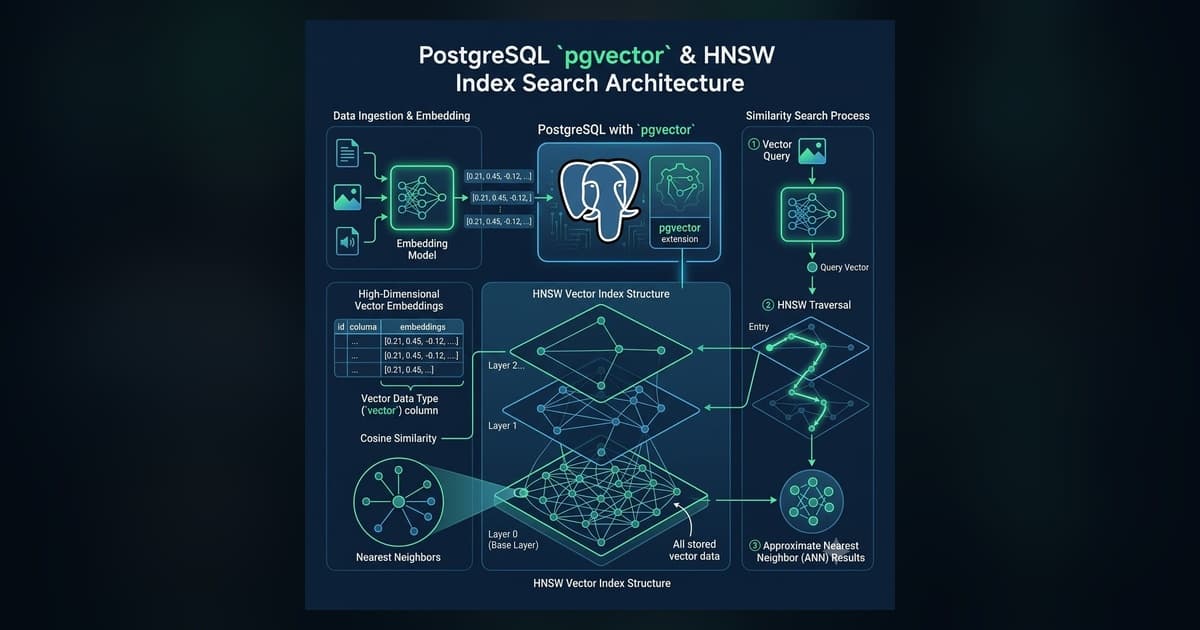

Table of Contents
Trước khi bạn ký hợp đồng với một cơ sở dữ liệu vector chuyên biệt như Pinecone, Weaviate, hoặc Qdrant cho pipeline RAG của mình, hãy xem xét kỹ cơ sở dữ liệu chính của bạn. Nếu hệ thống của bạn đã chạy PostgreSQL, có lẽ bạn không cần một cơ sở dữ liệu vector chuyên dụng.
Việc triển khai một cơ sở dữ liệu vector độc lập có nghĩa là phải quản lý hai nguồn dữ liệu đáng tin cậy, viết các script đồng bộ hóa ghi kép, và đối phó với những cơn ác mộng về tính nhất quán cuối cùng mỗi khi người dùng xóa hoặc cập nhật bản ghi.
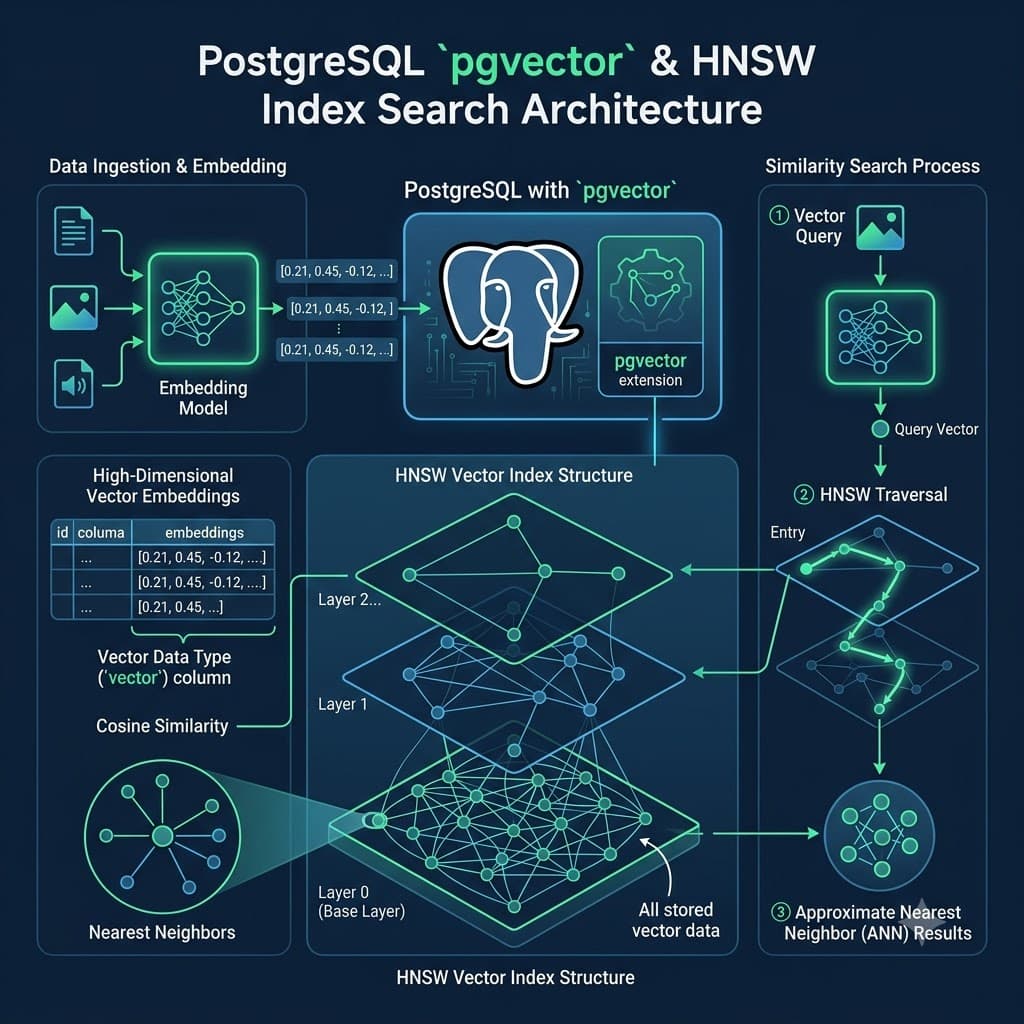
Với tiện ích mở rộng pgvector, các embedding của bạn nằm trực tiếp bên cạnh các bảng quan hệ: chia sẻ cùng các đảm bảo ACID, sao lưu tự động và các phép nối SQL lai liền mạch.
Đây là cách tìm kiếm vector hoạt động trong các pipeline RAG, cách cấu hình pgvector, xây dựng các chỉ mục HNSW có thể mở rộng vượt quá một triệu embedding, và thực hiện các tìm kiếm tương đồng cosine nhanh chóng mà không cần rời khỏi Postgres.
Những điểm yếu của cơ sở dữ liệu vector độc lập
Các cơ sở dữ liệu vector chuyên dụng như Pinecone, Milvus, hoặc Qdrant là những công cụ vững chắc, nhưng việc đưa một trong số chúng vào hệ thống của bạn có nghĩa là:
- Bạn phải duy trì một cơ sở dữ liệu thứ cấp và viết các pipeline đồng bộ hóa kép.
- Nếu người dùng xóa một tài khoản hoặc chỉnh sửa một bài viết trong Postgres, bạn phải điều phối việc xóa/cập nhật phân tán trong kho vector.
- Kiểm tra quyền (
WHERE org_id = $1) trở thành một bước lọc trước hoặc một quy trình truy vấn hai bước khó xử.
Với pgvector, các embedding của bạn nằm ngay trong cơ sở dữ liệu chính của bạn. Một thao tác chèn là một giao dịch ACID. Một thao tác xóa sẽ dọn dẹp cả hàng và vector của nó cùng lúc.
Thiết lập pgvector
Bắt đầu với pgvector rất đơn giản. Nếu bạn đang sử dụng một nhà cung cấp PostgreSQL được quản lý hiện đại (như AWS RDS, Supabase, Google Cloud SQL, hoặc Neon), pgvector gần như chắc chắn đã được hỗ trợ và chỉ cần được kích hoạt.
Nếu bạn đang chạy PostgreSQL cục bộ hoặc trên một máy chủ tùy chỉnh, bạn có thể biên dịch và cài đặt nó từ mã nguồn. Sau khi binary được cài đặt trên máy chủ của bạn, hãy kích hoạt tiện ích mở rộng trong cơ sở dữ liệu của bạn bằng cách chạy lệnh SQL sau:
-- Enable the pgvector extension in your database
CREATE EXTENSION IF NOT EXISTS vector;
Sau khi tiện ích mở rộng được kích hoạt thành công, bạn có thể sử dụng kiểu dữ liệu vector mới. Hãy tạo một bảng để lưu trữ các đoạn tài liệu văn bản và các embedding tương ứng của chúng. Ví dụ, nếu chúng ta đang sử dụng các embedding tiêu chuẩn của OpenAI, kích thước thường là 1536.
-- Create a table to store documents, metadata, and their vector embeddings
CREATE TABLE documents (
    id bigserial PRIMARY KEY,
    content text NOT NULL,
    metadata jsonb,
    -- Store a vector array with precisely 1536 dimensions
    embedding vector(1536)
);
Chèn dữ liệu vào bảng này cũng đơn giản như chèn vào bất kỳ bảng Postgres nào khác. Bạn chỉ cần cung cấp vector dưới dạng một chuỗi được định dạng hoặc một mảng tiêu chuẩn từ mã ứng dụng của bạn:
-- Insert a sample document and its semantic embedding
INSERT INTO documents (content, metadata, embedding)
VALUES (
    'Vector search enables semantic matching based on meaning, rather than keywords.',
    '{"author": "Jane Doe", "category": "AI", "tenant_id": 101}',
    '[0.012, -0.045, 0.088, ..., 0.011]'
);
Thực hiện tìm kiếm tương đồng Cosine
Để tìm các tài liệu liên quan nhất cho một truy vấn nhất định, trước tiên chúng ta phải chuyển đổi truy vấn văn bản thuần túy của người dùng thành một embedding bằng cách sử dụng cùng một mô hình embedding, sau đó tìm kiếm trong cơ sở dữ liệu các vector gần nhất. pgvector hỗ trợ một số độ đo khoảng cách gốc, bao gồm khoảng cách Euclidean (<->), tích vô hướng (<#>), và khoảng cách cosine (<=>).
Đối với hầu hết các embedding LLM hiện đại (thường được chuẩn hóa bởi nhà cung cấp), khoảng cách cosine là độ đo tiêu chuẩn và được khuyến nghị. Đây là cách bạn có thể thực hiện tìm kiếm K-Nearest Neighbors (KNN) để nhanh chóng tìm 5 tài liệu có ý nghĩa tương đồng nhất:
-- Find the 5 most semantically similar documents to a user's query vector
SELECT
    id,
    content,
    -- Calculate cosine similarity by subtracting distance from 1
    1 - (embedding <=> '[0.015, -0.042, 0.091, ..., 0.021]') AS similarity_score
FROM documents
ORDER BY embedding <=> '[0.015, -0.042, 0.091, ..., 0.021]'
LIMIT 5;
Lưu ý rằng toán tử tùy chỉnh <=> tính toán khoảng cách cosine. Bởi vì độ tương đồng cosine được định nghĩa toán học là 1 - cosine_distance, chúng ta chỉ cần trừ khoảng cách từ 1 trong mệnh đề SELECT của mình để lấy một điểm số tương đồng trực quan.
Mở rộng với chỉ mục HNSW
Một truy vấn KNN tiêu chuẩn như trên thực hiện quét tuần tự, kiểm tra từng hàng trong bảng để tính toán khoảng cách chính xác. Mặc dù phương pháp Exact Nearest Neighbor (ENN) này đảm bảo độ chính xác hoàn hảo, nhưng nó trở nên cực kỳ chậm khi tập dữ liệu của bạn tăng lên hàng trăm nghìn hoặc hàng triệu hàng.
Để mở rộng tìm kiếm vector lên cấp độ doanh nghiệp, chúng ta phải sử dụng các thuật toán Approximate Nearest Neighbor (ANN). Các thuật toán này đánh đổi một chút độ chính xác nhỏ, thường không thể nhận thấy (recall) để đạt được hiệu suất tăng đáng kể theo cấp số nhân. Bắt đầu từ phiên bản 0.5.0, pgvector đã giới thiệu hỗ trợ mạnh mẽ cho các chỉ mục HNSW (Hierarchical Navigable Small World): được coi là thuật toán tiêu chuẩn vàng cho tìm kiếm vector hiện nay.
HNSW xây dựng một đồ thị đa lớp trong đó mỗi nút đại diện cho một vector. Các tìm kiếm bắt đầu ở lớp cao nhất, thưa thớt nhất, thực hiện các bước nhảy lớn qua không gian vector để nhanh chóng thu hẹp khu vực lân cận, và dần dần đi sâu vào các lớp thấp hơn, dày đặc hơn để điều hướng chi tiết.
Đây là cách bạn tạo một chỉ mục HNSW trong pgvector, được tối ưu hóa rõ ràng cho khoảng cách cosine:
-- Create an HNSW index optimized for cosine distance calculations
CREATE INDEX documents_embedding_hnsw_idx
ON documents
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);
Tinh chỉnh hiệu suất: m và ef_construction
Lệnh tạo chỉ mục HNSW chấp nhận hai tham số quan trọng cho phép bạn tinh chỉnh chính xác sự đánh đổi giữa thời gian xây dựng, mức sử dụng bộ nhớ và recall tìm kiếm:
m: Số lượng liên kết hai chiều tối đa được tạo cho mỗi phần tử trong quá trình xây dựng đồ thị. Mộtmcao hơn (ví dụ: 32, 64, hoặc thậm chí 96) cải thiện recall cho dữ liệu có chiều cao (như vector 1536 chiều) nhưng làm tăng đáng kể kích thước chỉ mục trên đĩa và RAM, cũng như thời gian xây dựng. Mặc định là 16, nhưng 64 thường được khuyến nghị cho các khối lượng công việc sản xuất nặng.ef_construction: Kích thước của danh sách ứng cử viên động được sử dụng khi xây dựng chỉ mục. Tăng giá trị này (ví dụ: lên 128, 256, hoặc 512) dẫn đến một đồ thị được xây dựng tỉ mỉ, chất lượng cao hơn và recall tốt hơn, với chi phí rõ ràng là thời gian tạo chỉ mục lâu hơn đáng kể. Nó chỉ ảnh hưởng đến thời gian xây dựng chỉ mục, không ảnh hưởng đến thời gian truy vấn.
Ngoài ra, trong quá trình thực thi truy vấn, bạn có thể điều chỉnh động ef_search cho giao dịch hoặc phiên hiện tại để kiểm soát số lượng ứng cử viên được xem xét trong giai đoạn tìm kiếm. Giá trị cao hơn làm tăng recall nhưng giảm nhẹ tốc độ tìm kiếm.
-- Adjust ef_search for the current session to prioritize recall (default is 40)
SET hnsw.ef_search = 100;
Tìm kiếm lai: Lợi thế tối thượng của Postgres
Một trong những lý do hấp dẫn nhất để sử dụng pgvector thay vì một cơ sở dữ liệu vector độc lập là khả năng thực hiện các tìm kiếm lai phức tạp. Bạn có thể kết hợp liền mạch và giao dịch sự tương đồng vector với các bộ lọc và phép nối SQL truyền thống. Ví dụ, bạn có thể dễ dàng lọc tài liệu theo một tác giả cụ thể, ID người thuê, hoặc một phạm vi ngày nghiêm ngặt trước khi xếp hạng tập hợp con còn lại theo mức độ liên quan ngữ nghĩa.
SELECT
    content,
    metadata->>'author' AS author,
    1 - (embedding <=> '[0.015, -0.042, 0.091, ..., 0.021]') AS similarity
FROM documents
WHERE metadata->>'category' = 'AI'
  AND (metadata->>'tenant_id')::int = 101
ORDER BY embedding <=> '[0.015, -0.042, 0.091, ..., 0.021]'
LIMIT 5;
Nếu các cột tiêu chuẩn của bạn được lập chỉ mục đúng cách (ví dụ: sử dụng chỉ mục B-Tree hoặc GIN trên cột JSONB metadata), bộ lập kế hoạch truy vấn tinh vi của PostgreSQL có thể lọc dữ liệu một cách mạnh mẽ trước tiên, chỉ áp dụng tìm kiếm vector tốn kém cho tập hợp con có liên quan, được nhắm mục tiêu cao. Điều này nổi tiếng là khó khăn, có độ trễ cao và dễ xảy ra lỗi để đạt được hiệu quả trong các kiến trúc phân tách nơi siêu dữ liệu quan hệ nằm trong Postgres và các vector hoàn toàn bị cô lập trong một hệ thống cơ sở dữ liệu riêng biệt.
Các quy tắc vận hành trước khi bạn mở rộng
pgvector với HNSW xử lý hàng triệu vector dễ dàng, nhưng hãy ghi nhớ những giới hạn thực tế này:
- Hạn chế RAM: Chỉ mục HNSW phải nằm trong bộ nhớ. 1 triệu vector 1536 chiều với
m = 32sẽ tiêu thụ khoảng 2.5GB đến 3GB RAM chỉ riêng cho chỉ mục. Nếu chỉ mục của bạn tràn ra đĩa, độ trễ truy vấn sẽ tăng từ 8ms lên 200ms+. Hãy điều chỉnhshared_buffersvà RAM của bạn cho phù hợp. - Bản sao đọc: Tìm kiếm vector tốn nhiều CPU và bộ nhớ. Khi lưu lượng tìm kiếm tăng lên, hãy tạo một bản sao đọc Postgres chuyên dụng chỉ dành cho các truy vấn vector để bạn không bao giờ làm cạn kiệt nhóm kết nối OLTP chính của mình.
- Recall ANN được lọc: Nếu bạn chạy các bộ lọc đa người thuê nặng (
WHERE tenant_id = $1), hãy xem xét các chỉ mục HNSW một phần cho mỗi người thuê hoặc các lần quét chỉ mục lặp lại của pgvector 0.7 để ngăn chặn sự suy giảm recall.
Nếu bạn có dưới 10 triệu vector, hãy bắt đầu với Postgres. Nó giữ cho hệ thống của bạn đơn giản và chi phí vận hành gần như bằng không.
Bạn cũng có thể thích
- Trợ lý mã hóa AI: Các phương pháp hay nhất cho năm 2026
- Cursor vs Claude Code: Công cụ mã hóa AI nào thực sự thắng thế vào năm 2026?
- Cách tôi thực sự sử dụng ChatGPT, Claude và Gemini cho công việc phát triển
- Các tính năng nâng cao của Cursor IDE dành cho kỹ sư thực dụng: MCP, Rules và Agents vào năm 2026
Free In-Browser Developer Tools
Clean AI CLI logs, build cron expressions, decode JWTs, and calculate chmod permissions offline.
Related Articles

Kho dữ liệu phân tích Serverless với BigQuery & Cloud Run: Từ luồng GA4 đến cảnh báo SEO tự động
Tìm hiểu cách xây dựng kho dữ liệu phân tích serverless tự động với BigQuery, Google Analytics 4 và Cloud Run: mô hình hóa lược đồ, chuyển đổi SQL theo lịch trình, chi phí không tải và cảnh báo truy vấn SEO tự động.
Read more
Kubernetes HPA với Custom Metrics: Tự động điều chỉnh quy mô thực tế với Prometheus
Hướng dẫn toàn diện về Kubernetes HPA với custom metrics: tự động điều chỉnh quy mô thực tế với Prometheus cùng các ví dụ thực tế đã được kiểm chứng trong môi trường sản xuất.
Read more
Các lựa chọn thay thế Playwright hàng đầu năm 2026: So sánh Cypress, WebdriverIO, Vitest & Puppeteer
Hướng dẫn toàn diện về các lựa chọn thay thế Playwright hàng đầu năm 2026: so sánh Cypress, WebdriverIO, Vitest & Puppeteer với các ví dụ thực tế đã được kiểm chứng.
Read more