•22 phút đọc
Linux cgroups v2 trong Kubernetes: PSI Pressure Stall Information, Memory Throttling & OOM Shields

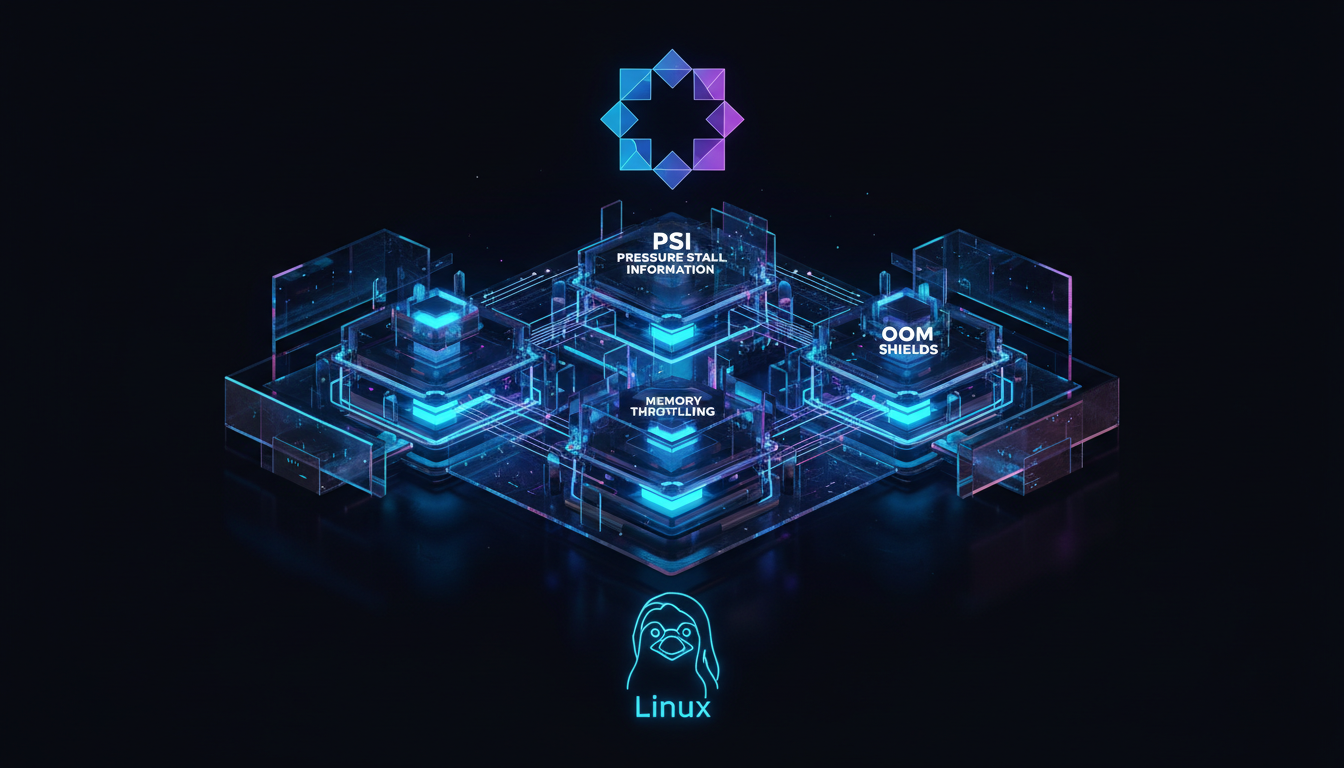
Cgroups v2 của Linux đại diện cho một sự thay đổi kiến trúc cơ bản trong quản lý tài nguyên, chuyển từ hệ thống phân cấp rời rạc của v1 sang một cấu trúc thống nhất, dạng cây. Sự phát triển này rất quan trọng đối với các nền tảng điều phối container hiện đại như Kubernetes, cho phép cách ly tài nguyên chính xác và dễ dự đoán hơn. Hướng dẫn này trình bày chi tiết các tác động vận hành của cgroups v2, tập trung vào quản lý bộ nhớ, Thông tin tắc nghẽn áp lực (PSI) và các chiến lược bảo vệ OOM trong Kubernetes.
Audio Briefing• Voice: Google Cloud vi-VN-Neural2-A
0:00 / --:--
Cgroups v1 so với v2: Thay đổi mô hình kiến trúc
Cgroups v1 gặp phải vấn đề phân cấp rời rạc. Mỗi bộ điều khiển (ví dụ: cpu, memory, blkio) có thể có hệ thống phân cấp độc lập của riêng mình, dẫn đến việc gán tài nguyên phức tạp và thường xuyên xung đột cho một tiến trình duy nhất. Một tiến trình có thể thuộc về các cgroup khác nhau cho các loại tài nguyên khác nhau, khiến việc quản lý tài nguyên nhất quán trở nên khó khăn.
Cgroups v2 giới thiệu một hệ thống phân cấp thống nhất. Tất cả các bộ điều khiển được gắn vào một hệ thống phân cấp duy nhất, dạng cây. Một tiến trình thuộc về chính xác một cgroup trong hệ thống phân cấp này, và tất cả các bộ điều khiển tài nguyên áp dụng cho cgroup đó đều áp dụng cho tiến trình. Sự đơn giản hóa này cung cấp một mô hình quản lý tài nguyên mạch lạc và mạnh mẽ hơn.
Sự khác biệt kiến trúc chính
| Tính năng | Cgroups v1 | Cgroups v2 |
|---|---|---|
| Hệ thống phân cấp | Nhiều, độc lập | Đơn nhất, thống nhất |
| Thành viên tiến trình | Nhiều cgroup (một cho mỗi bộ điều khiển) | Một cgroup duy nhất |
| Gắn bộ điều khiển | Bất kỳ cgroup nào | Chỉ các nút lá (có ngoại lệ) |
| Ủy quyền | Phức tạp, dễ gây lỗi | Đơn giản hóa, rõ ràng |
| Tệp tài nguyên | Đặt tên không nhất quán | Đặt tên chuẩn hóa (cgroup.<controller>.<metric>) |
| Kế toán bộ nhớ | Kém chính xác | Chi tiết hơn, memory.stat |
| PSI | Không có sẵn | Tích hợp |
Hệ thống phân cấp thống nhất trong v2 đơn giản hóa việc ủy quyền và kế toán tài nguyên. Một cgroup cha có thể ủy quyền một cây con cho một cgroup con, cấp cho cgroup con toàn quyền kiểm soát việc quản lý tài nguyên trong cây con đó mà không ảnh hưởng đến các phần khác của hệ thống phân cấp. Điều này rất quan trọng đối với các runtime container như containerd và CRI-O, vốn quản lý cgroup cho từng pod và container.
Quản lý bộ nhớ trong Cgroups v2
Cgroups v2 cải thiện đáng kể khả năng quản lý bộ nhớ, giới thiệu memory.high để điều tiết dần dần và tinh chỉnh hành vi OOM.
memory.max: Giới hạn cứng
memory.max định nghĩa giới hạn bộ nhớ tuyệt đối cho một cgroup. Khi mức sử dụng bộ nhớ của một cgroup vượt quá giá trị này, trình diệt OOM của kernel sẽ được gọi để chấm dứt các tiến trình trong cgroup đó. Điều này tương tự như memory.limit_in_bytes trong cgroups v1.
memory.high: Giới hạn mềm và cơ chế điều tiết
memory.high là một bổ sung quan trọng trong cgroups v2. Nó hoạt động như một giới hạn bộ nhớ mềm. Khi mức sử dụng bộ nhớ của một cgroup vượt quá memory.high, kernel sẽ cố gắng thu hồi bộ nhớ từ cgroup đó trước khi đạt đến memory.max. Điều này đạt được bằng cách:
- Giải phóng bộ đệm trang (page cache eviction): Chủ động loại bỏ các trang bộ đệm trang sạch.
- Hoán đổi (swap out): Hoán đổi các trang bộ nhớ ẩn danh sang đĩa (nếu bật hoán đổi).
- Thu hồi trực tiếp (direct reclaim): Buộc các tiến trình trong cgroup thu hồi bộ nhớ một cách đồng bộ.
Cơ chế điều tiết dần dần này nhằm mục đích ngăn chặn các sự cố OOM bằng cách làm chậm các tiến trình sử dụng nhiều bộ nhớ, cho chúng cơ hội giảm mức sử dụng hoặc cho phép các tiến trình khác giải phóng tài nguyên. Nó cung cấp một sự suy giảm hiệu suất nhẹ nhàng hơn dưới áp lực bộ nhớ so với việc bị OOM kill đột ngột được kích hoạt bởi memory.max.
Ví dụ thực tế: Cấu hình giới hạn bộ nhớ
Hãy xem xét một Pod Kubernetes với yêu cầu và giới hạn bộ nhớ. Kubernetes dịch những điều này thành cài đặt cgroup v2.
yaml
apiVersion: v1
kind: Pod
metadata:
  name: memory-intensive-app
spec:
  containers:
  - name: app
    image: busybox
    command: ["sh", "-c", "while true; do sleep 1; done"]
    resources:
      requests:
        memory: "256Mi"
      limits:
        memory: "512Mi"
Giả sử một hệ thống hỗ trợ cgroup v2 và kubelet được cấu hình để sử dụng cgroup v2, runtime container (ví dụ: containerd) sẽ tạo một cgroup cho pod này. memory.max cho cgroup của container sẽ được đặt thành 512Mi. Giá trị memory.high thường được lấy từ memory.request hoặc một phần trăm của memory.max, tùy thuộc vào cấu hình của runtime container. Đối với containerd, memory.high thường được đặt thành memory.max theo mặc định trừ khi được cấu hình rõ ràng khác hoặc nếu memory.request được chỉ định.
Hãy kiểm tra thủ công cài đặt cgroup v2 cho một container đang chạy.
bash
# Find the cgroup path for a container (e.g., from a pod named 'memory-intensive-app')
# First, get the container ID
CONTAINER_ID=$(kubectl get pod memory-intensive-app -o jsonpath='{.status.containerStatuses[0].containerID}' | cut -d'/' -f2)

# Assuming containerd, the cgroup path is typically under /sys/fs/cgroup/system.slice/containerd.service/
# and then a path derived from the container ID.
# A more robust way is to use systemd-cgls or findmnt
CGROUP_PATH=$(find /sys/fs/cgroup -name "*${CONTAINER_ID}*" -type d | head -n 1)

echo "Cgroup path: $CGROUP_PATH"

# Read memory limits
cat "${CGROUP_PATH}/memory.max"
cat "${CGROUP_PATH}/memory.high"
cat "${CGROUP_PATH}/memory.current"
cat "${CGROUP_PATH}/memory.stat"
Tệp memory.stat cung cấp thông tin kế toán bộ nhớ chi tiết, bao gồm anon (bộ nhớ ẩn danh), file (bộ đệm trang), kernel_stack, slab và nhiều số liệu khác. Dữ liệu chi tiết này rất có giá trị để gỡ lỗi các vấn đề về bộ nhớ.
Advertisement
Thông tin tắc nghẽn áp lực (PSI)
PSI là một tính năng kernel được giới thiệu trong Linux 4.20, cung cấp các số liệu tổng hợp về thời gian các tác vụ phải chờ tài nguyên CPU, bộ nhớ hoặc I/O. Không giống như các số liệu truyền thống hiển thị mức sử dụng tài nguyên (ví dụ: mức sử dụng CPU), PSI định lượng sự tranh chấp tài nguyên và sự thiếu hụt. Nó trả lời câu hỏi: "Các tiến trình của tôi bị tắc nghẽn bao nhiêu thời gian vì tài nguyên không có sẵn?"
Các số liệu PSI được hiển thị thông qua /proc/pressure/ và trong các thư mục cgroup v2.
Giải thích các số liệu PSI
Đối với mỗi tài nguyên (CPU, Bộ nhớ, I/O), PSI cung cấp ba số liệu:
some: Phần trăm thời gian ít nhất một tác vụ bị tắc nghẽn chờ tài nguyên này.full: Phần trăm thời gian tất cả các tác vụ bị tắc nghẽn chờ tài nguyên này. Điều này cho thấy một nút thắt cổ chai hoàn toàn trên toàn hệ thống hoặc toàn cgroup.total: Tổng thời gian tích lũy (tính bằng micro giây) mà các tác vụ bị tắc nghẽn.
Ví dụ đầu ra từ /proc/pressure/memory:
some avg10=0.00 avg60=0.00 avg300=0.00 total=0
full avg10=0.00 avg60=0.00 avg300=0.00 total=0
Ở đây, avg10, avg60, avg300 đại diện cho phần trăm tắc nghẽn trung bình trong 10, 60 và 300 giây tương ứng.
PSI trong Cgroups v2
Mỗi thư mục cgroup v2 chứa các tệp cpu.pressure, memory.pressure và io.pressure. Các tệp này báo cáo các số liệu PSI cụ thể cho các tác vụ trong cgroup đó và các hậu duệ của nó. Điều này cho phép giám sát chi tiết sự tranh chấp tài nguyên trong từng pod hoặc ứng dụng.
bash
# Example: Read memory pressure for a specific cgroup
cat "${CGROUP_PATH}/memory.pressure"
Sử dụng PSI để quan sát
PSI là một tín hiệu mạnh mẽ để phát hiện các nút thắt cổ chai tài nguyên trước khi chúng dẫn đến các lỗi nghiêm trọng như OOM kill hoặc ứng dụng không phản hồi.
memory.pressure somecao: Cho thấy một số tiến trình trong cgroup đang gặp phải tranh chấp bộ nhớ. Đây có thể là dấu hiệu báo trước của việc điều tiếtmemory.highhoặc thậm chí là OOM kill.memory.pressure fullcao: Cho thấy toàn bộ cgroup đang bị thiếu bộ nhớ nghiêm trọng, có khả năng dẫn đến đóng băng ứng dụng.cpu.pressure somecao: Một số tác vụ đang chờ CPU. Có thể cho thấy việc điều tiết CPU hoặc CPU quá tải.io.pressure fullcao: Tất cả các tác vụ đang chờ I/O. Một dấu hiệu rõ ràng của nút thắt cổ chai I/O.
Giám sát các số liệu PSI trong Kubernetes có thể cung cấp cảnh báo sớm về tình trạng bão hòa tài nguyên, cho phép mở rộng quy mô hoặc điều chỉnh tài nguyên chủ động. Các exporter của Prometheus có thể thu thập các số liệu này từ các đường dẫn cgroup để giám sát tập trung.
OOM Shields và systemd-oomd
Mặc dù memory.high cung cấp cơ chế điều tiết, áp lực bộ nhớ nghiêm trọng vẫn có thể dẫn đến OOM kill. Trong một cụm Kubernetes, các daemon hệ thống quan trọng (ví dụ: kubelet, containerd, kube-proxy, node-exporter) phải được bảo vệ khỏi bị OOM-killed bởi các workload của người dùng.
Node Allocatable và Critical Pods
Kubernetes sử dụng tính năng "Node Allocatable" để dành tài nguyên cho các daemon hệ thống. Điều này được cấu hình thông qua các cờ kubelet:
--kube-reserved: Tài nguyên dành cho các daemon hệ thống Kubernetes (ví dụ:kubelet,kube-proxy).--system-reserved: Tài nguyên dành cho các daemon hệ thống OS (ví dụ:sshd,journald).--eviction-hard: Định nghĩa ngưỡng để trục xuất.
Các đặt chỗ này đảm bảo rằng tổng các yêu cầu của pod không vượt quá dung lượng có thể cấp phát, để lại khoảng trống cho các thành phần quan trọng. Tuy nhiên, đây là một cơ chế lập lịch, không phải là một biện pháp bảo vệ OOM nghiêm ngặt. Nếu một pod người dùng tiêu thụ nhiều hơn giới hạn của nó hoặc nếu các daemon hệ thống tự có rò rỉ bộ nhớ, OOM vẫn có thể xảy ra.
systemd-oomd: Ngăn chặn OOM chủ động
systemd-oomd là một trình diệt OOM trong không gian người dùng hoạt động cùng với cgroups v2 và PSI. Thay vì chờ trình diệt OOM của kernel (vốn phản ứng và thường giết tiến trình "sai"), systemd-oomd giám sát các cgroup để tìm áp lực bộ nhớ bằng cách sử dụng các số liệu PSI và các sự kiện memory.high. Khi nó phát hiện áp lực bộ nhớ kéo dài, nó chủ động chấm dứt các tiến trình hoặc cgroup đang đóng góp nhiều nhất vào áp lực, dựa trên các chính sách có thể cấu hình.
systemd-oomd có thể được cấu hình để:
- Giám sát các cgroup cụ thể: Bảo vệ các cgroup hệ thống quan trọng.
- Xác định ngưỡng OOM: Dựa trên phần trăm
somehoặcfullcủa PSI, hoặc các sự kiệnmemory.high. - Chỉ định chính sách tiêu diệt: Tiến trình nào sẽ bị tiêu diệt trước (ví dụ: tiến trình tiêu thụ bộ nhớ lớn nhất, tiến trình cũ nhất).
Ví dụ cấu hình systemd-oomd (/etc/systemd/oomd.conf)
ini
[OOM]
# Enable oomd
Enable=true

# Global memory pressure thresholds
# If memory.pressure.some reaches 20% for 30s, consider action
MemoryPressureDurationSec=30s
MemoryPressureThreshold=20%

# Action to take when pressure is detected
# Can be 'kill', 'warn', 'none'
DefaultMemoryPressureAction=kill

# Protect system services from being killed by oomd
# This is crucial for Kubernetes nodes
ProtectSystem=true

# Protect specific cgroups (e.g., kubelet)
# This is typically handled by ProtectSystem=true if kubelet is a systemd service
# or by configuring specific cgroup paths.
# Example: Protect the cgroup for kubelet.service
# CGroup=/system.slice/kubelet.service
Đối với Kubernetes, systemd-oomd có thể được cấu hình để bảo vệ các cgroup của kubelet.service, containerd.service và các thành phần quan trọng khác. Điều này đảm bảo rằng ngay cả dưới áp lực bộ nhớ nghiêm trọng từ các workload của người dùng, mặt phẳng điều khiển và cơ sở hạ tầng nút vẫn ổn định.
Tích hợp systemd-oomd với Kubernetes
- Bật cgroups v2: Đảm bảo bản phân phối Linux và kernel của bạn hỗ trợ và được cấu hình cho cgroups v2. Hầu hết các bản phân phối hiện đại (ví dụ: Fedora 31+, Ubuntu 20.04+, RHEL 8+) mặc định hoặc hỗ trợ cgroups v2.
- Xác minh:
stat -f /sys/fs/cgroupsẽ hiển thịType: cgroup2fs. - Xác minh
kubeletđang chạy ở chế độ cgroup v2: Kiểm tra nhật kýkubeletđể tìm trình điều khiểncgroupfsvà trình điều khiển cgroupsystemd.
- Xác minh:
- Cài đặt và cấu hình
systemd-oomd: Cài đặt góisystemd-oomd. Cấu hình/etc/systemd/oomd.confđể bảo vệ các dịch vụ hệ thống. - Giám sát PSI: Tích hợp các số liệu PSI vào ngăn xếp giám sát của bạn (ví dụ: Prometheus Node Exporter). Cảnh báo khi giá trị
memory.pressurecao. - Node Allocatable: Cấu hình đúng
--kube-reservedvà--system-reservedtrongkubeletđể dành tài nguyên cho các thành phần quan trọng.
Những vấn đề và cách khắc phục trong môi trường sản xuất
-
Không khớp Cgroups v1 so với v2:
- Triệu chứng:
kubeletkhông khởi động được hoặc các container không khởi chạy được với lỗi cgroup.kubectl describe nodehiển thị cảnh báo trình điều khiển cgroup. - Nguyên nhân: Hệ điều hành máy chủ đang chạy cgroups v1, nhưng
kubeletđược cấu hình cho v2, hoặc ngược lại. Hoặc, kernel là v2 nhưngkubeletđược cấu hình cho trình điều khiểncgroupfsthay vìsystemd. - Cách khắc phục: Đảm bảo hệ điều hành máy chủ đang chạy cgroups v2 (kernel 5.x+). Cấu hình
kubeletđể sử dụng trình điều khiển cgroupsystemd, được khuyến nghị cho cgroups v2.Khởi động lại nút sau khi thay đổi chế độ cgroup nếu cần.yaml# /etc/kubernetes/kubelet.conf (or similar kubelet config file) apiVersion: kubelet.config.k8s.io/v1beta1 kind: KubeletConfiguration cgroupDriver: systemd
- Triệu chứng:
-
Điều tiết
memory.highquá mức:- Triệu chứng: Các ứng dụng trở nên không phản hồi hoặc gặp độ trễ cao dưới tải bộ nhớ vừa phải, nhưng không bị OOM-killed.
- Nguyên nhân:
memory.highđược đặt quá thấp, gây ra việc điều tiết sớm. Điều này có thể xảy ra nếumemory.requestthấp hơn đáng kể so với tập làm việc thực tế, vàmemory.highđược lấy từmemory.request. - Cách khắc phục: Điều chỉnh
memory.requestđể phản ánh tốt hơn mức sử dụng bộ nhớ điển hình của ứng dụng. Đối với các ứng dụng quan trọng, hãy cân nhắc đặtmemory.highgần vớimemory.maxhoặc tắt nó nếu ứng dụng nhạy cảm với việc điều tiết (mặc dù điều này làm tăng rủi ro OOM). Các runtime container như containerd có thể có các tùy chọn cấu hình để điều chỉnh cách đặtmemory.high.
-
systemd-oomdgiết các tiến trình không mong muốn:- Triệu chứng: Các tiến trình ứng dụng quan trọng bị
systemd-oomdgiết thay vì các workload của người dùng. - Nguyên nhân: Cấu hình
systemd-oomdquá mạnh hoặc không loại trừ đúng các cgroup quan trọng. - Cách khắc phục: Xem lại
oomd.conf. Đảm bảoProtectSystem=trueđược đặt. Nếu các ứng dụng quan trọng cụ thể đang chạy dưới dạng dịch vụ người dùng, hãy đảm bảo các cgroup của chúng được bảo vệ rõ ràng hoặc các chính sách củaoomdưu tiên giết các workload ít quan trọng hơn. Sử dụngoomctlđể kiểm tra trạng thái và quyết định củasystemd-oomd.
- Triệu chứng: Các tiến trình ứng dụng quan trọng bị
-
Hiểu sai các số liệu PSI:
- Triệu chứng: Cảnh báo được kích hoạt trên các số liệu PSI, nhưng không quan sát thấy sự suy giảm hiệu suất thực tế.
- Nguyên nhân: Hiểu sai ý nghĩa của
someso vớifullhoặc đặt ngưỡng cảnh báo quá thấp. Các đợt tăng áp lựcsomengắn thường là bình thường. - Cách khắc phục: Tập trung vào áp lực
fullcao kéo dài đối với các dịch vụ quan trọng. Đối với áp lựcsome, hãy tìm các xu hướng và tương quan với các số liệu khác (ví dụ: độ trễ, tỷ lệ lỗi). Điều chỉnh ngưỡng cảnh báo dựa trên đường cơ sở quan sát được và mức suy giảm hiệu suất chấp nhận được.
-
Trình diệt OOM của Kernel vẫn hoạt động:
- Triệu chứng: Mặc dù
systemd-oomdđược bật, trình diệt OOM của kernel vẫn can thiệp. - Nguyên nhân: Ngưỡng của
systemd-oomdkhông đủ mạnh, hoặc áp lực bộ nhớ tăng quá nhanh khiếnoomdkhông kịp phản ứng. Trình diệt OOM của kernel là phương án dự phòng cuối cùng. - Cách khắc phục: Điều chỉnh
systemd-oomd'sMemoryPressureThresholdvàMemoryPressureDurationSecđể chủ động hơn. Đảm bảooomdđang giám sát đúng các cgroup. Điều tra nguyên nhân gốc rễ của áp lực bộ nhớ nhanh chóng.
- Triệu chứng: Mặc dù
Bạn cũng có thể thích
- NVMe-over-TCP trong Sản xuất: Kiến trúc Kernel Linux, SPDK & Lưu trữ Kubernetes Hiệu suất cao
- Kiến trúc Kafka Tiered Storage: Giảm chi phí lưu trữ EBS với AWS S3 & Google Cloud Storage
- Định dạng bảng mở vào năm 2026: Apache Iceberg v2 so với Delta Lake 3.0 trên Cloud Object Storage
- Mở rộng DuckDB: Phân tích không gian, tích hợp Parquet & Iceberg từ xa qua HTTPFS
Các câu hỏi thường gặp
-
Tại sao tôi nên di chuyển sang cgroups v2? Cgroups v2 cung cấp một hệ thống phân cấp thống nhất, đơn giản hóa việc quản lý tài nguyên, cải thiện việc ủy quyền và cung cấp kế toán bộ nhớ chi tiết hơn cũng như điều tiết chủ động với
memory.high. Đây là tương lai của kiểm soát tài nguyên Linux và được yêu cầu cho các tính năng như PSI vàsystemd-oomd. Các phiên bản Kubernetes và runtime container hiện đại ngày càng được tối ưu hóa cho cgroups v2. -
memory.highkhác vớimemory.maxnhư thế nào?memory.maxlà một giới hạn cứng; vượt quá nó sẽ kích hoạt trình diệt OOM của kernel.memory.highlà một giới hạn mềm; vượt quá nó sẽ kích hoạt việc thu hồi bộ nhớ chủ động và điều tiết trong cgroup, nhằm mục đích ngăn chặn việc đạt đếnmemory.maxvà một sự cố OOM kill.memory.highcung cấp một sự suy giảm hiệu suất nhẹ nhàng hơn dưới áp lực bộ nhớ. -
Tôi có thể chạy Kubernetes với cgroups v1 và
systemd-oomdkhông? Không.systemd-oomdphụ thuộc rất nhiều vào hệ thống phân cấp thống nhất của cgroups v2 và các số liệu PSI, vốn không hoàn toàn có sẵn hoặc được hiển thị nhất quán trong cgroups v1. Để tận dụngsystemd-oomdđể ngăn chặn OOM chủ động, môi trường cgroups v2 là bắt buộc. -
Các phương pháp hay nhất để đặt
memory.requestvàmemory.limitvới cgroups v2 là gì? Đặtmemory.requestthành kích thước tập làm việc điển hình của ứng dụng của bạn. Điều này ảnh hưởng đếnmemory.highvà đảm bảo lập lịch đầy đủ. Đặtmemory.limit(trở thànhmemory.max) thành bộ nhớ tối đa tuyệt đối mà ứng dụng của bạn có thể tiêu thụ mà không gây mất ổn định. Tránh đặtmemory.limitquá cao, vì nó có thể dẫn đến cạn kiệt tài nguyên trên nút. Một chiến lược phổ biến là đặtmemory.requestthành một giá trị cho phép một số đột biến, vàmemory.limitthành một giá trị ngăn chặn việc sử dụng bộ nhớ vượt tầm kiểm soát. -
Làm cách nào để giám sát các số liệu PSI trong Kubernetes? Prometheus Node Exporter có thể hiển thị các số liệu PSI từ
/proc/pressure/và các đường dẫn cgroup v2. Bạn có thể cấu hình Prometheus để thu thập các số liệu này và thiết lập các bảng điều khiển Grafana và các quy tắc cảnh báo dựa trênnode_pressure_cpu_some_total,node_pressure_memory_full_totalvà các số liệu tương tự cho các cgroup cụ thể. Điều này cung cấp những hiểu biết quan trọng về sự tranh chấp tài nguyên.
Kiểm tra kiến thức
Interactive Quiz
Question 1 of 2
Trong một Kubernetes cluster chạy trên cgroups v2, một pod microservice quan trọng thường xuyên gặp OOMKills mặc dù có giới hạn `memory.max` được đặt cao hơn đáng kể so với tập làm việc điển hình của nó. Phân tích cho thấy mức sử dụng bộ nhớ của pod thường tăng đột biến tạm thời nhưng hiếm khi đạt đến `memory.max` trước khi bị kill. Đâu là nguyên nhân có khả năng nhất gây ra các OOMKills này và chiến lược giảm thiểu hiệu quả nhất dành riêng cho cgroups v2?
Chia sẻ bài viết:
Tiện ích lập trình viên
Công cụ lập trình trực tiếp trên trình duyệt
Làm sạch log AI CLI, tạo biểu thức cron, giải mã JWT và tính quyền chmod offline.
Advertisement
Bài viết liên quan
ebpf
eBPF trong Môi Trường Production: Quan Sát Hệ Thống Linux Với Overhead Cực Thấp, Tracing và Profiling Nhân Hệ Điều Hành
Triển khai quan sát nhân Linux (kernel observability) với overhead gần như bằng không bằng eBPF. Đo độ trễ system call, theo dõi cấp phát bộ nhớ và giám sát socket mạng mà không cần sidecar.
Đọc tiếp
rust
I/O Linux thông lượng cao trong Rust: io_uring, Tokio & Zero-Copy Networking
Hướng dẫn toàn diện về I/O Linux thông lượng cao trong Rust: io_uring, Tokio & zero-copy networking với kiến trúc và ví dụ code cấp độ sản xuất.
Đọc tiếp
kubernetes
Kubernetes Operators: Xây dựng Custom Controller với Operator SDK
Hướng dẫn thực tế để xây dựng các Kubernetes Operator sẵn sàng cho môi trường production bằng Operator SDK và Kubebuilder trong Go: scaffolding CRD, vòng lặp reconcile bất biến, finalizer và bộ tích hợp envtest.
Đọc tiếp