Kubernetes HPA với Custom Prometheus Metrics: Vượt xa CPU Scaling (2026)

Table of Contents
Trong một thời gian dài, chúng tôi đã mở rộng quy mô các pod Kubernetes của mình theo cách tiêu chuẩn: khi CPU hoặc bộ nhớ đạt 80%, chúng tôi sẽ thêm nhiều bản sao hơn. Cách này hoạt động tốt cho đến khi chúng tôi nhận thấy các API của mình bị hết thời gian chờ do tồn đọng yêu cầu, mặc dù mức sử dụng CPU chỉ ở khoảng 40%.
Các số liệu tài nguyên nút tiêu chuẩn thường không thể hiện đầy đủ bức tranh. Ứng dụng của bạn có thể bị thiếu luồng worker hoặc bị quá tải trong hàng đợi tin nhắn trong khi CPU trông hoàn toàn khỏe mạnh. Giải pháp là gì? Kết nối Kubernetes Horizontal Pod Autoscaler (HPA) trực tiếp với các số liệu ứng dụng Prometheus của chúng tôi để chúng tôi có thể mở rộng quy mô dựa trên nhu cầu lưu lượng thực tế, như số lượng yêu cầu HTTP mỗi giây.
Cách hoạt động của tính năng tự động điều chỉnh theo số liệu tùy chỉnh
Việc điều chỉnh theo số liệu tùy chỉnh thoạt nghe có vẻ như là phép thuật đen, nhưng thực chất nó chỉ là một hệ thống đường ống. HPA truy vấn lớp tổng hợp Custom Metrics API, lớp này định tuyến các yêu cầu đến một bộ điều hợp (như Prometheus Adapter). Bộ điều hợp này dịch dữ liệu chuỗi thời gian Prometheus thô thành các đối tượng số liệu Kubernetes.
Khi HPA thức dậy sau mỗi 15 giây, nó sẽ truy vấn custom.metrics.k8s.io. Bộ điều hợp chạy truy vấn PromQL của bạn, trả về giá trị hiện tại và HPA tính toán xem có cần khởi tạo các pod mới hay không.
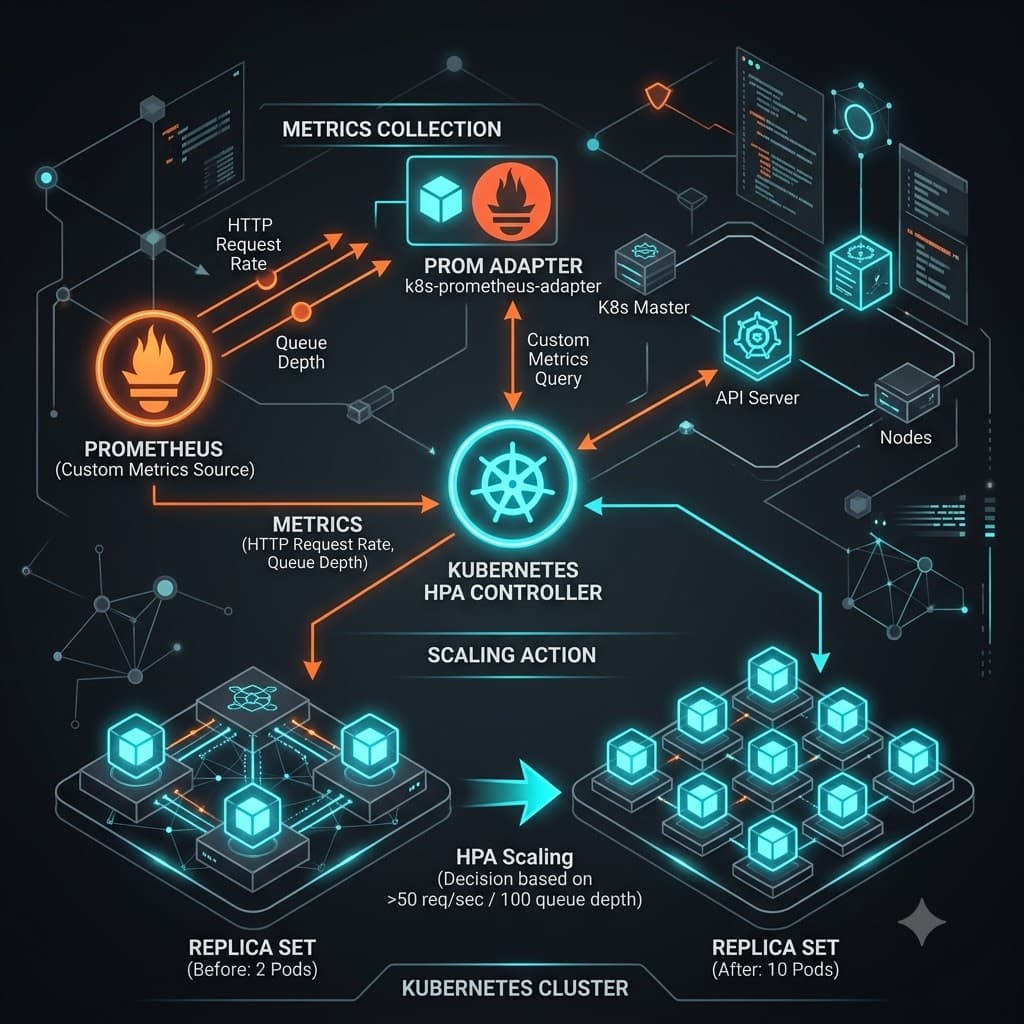
Hiểu rõ luồng điều khiển nội bộ sẽ ngăn chặn các lỗi kiến trúc phổ biến trong quá trình thiết lập cluster. Mặt phẳng điều khiển Kubernetes không trực tiếp lấy dữ liệu từ các endpoint ứng dụng. Thay vào đó, ứng dụng của bạn hiển thị các số liệu định dạng Prometheus tại một endpoint HTTP như /metrics. Prometheus liên tục lấy dữ liệu từ các endpoint này, lưu trữ các bản ghi chuỗi thời gian trong cơ sở dữ liệu lưu trữ cục bộ của nó và cung cấp chúng để truy vấn. Prometheus Adapter hoạt động như một máy chủ mở rộng API triển khai giao diện custom.metrics.k8s.io/v1beta1. Nó thường xuyên thực thi các truy vấn PromQL đã đăng ký đối với máy chủ Prometheus của bạn, lưu trữ kết quả tính toán và phản hồi các yêu cầu API được khởi tạo bởi bộ điều khiển Horizontal Pod Autoscaler.
Để đảm bảo hành vi điều chỉnh có tính xác định, các giá trị số liệu tùy chỉnh phải được liên kết với các tài nguyên Kubernetes cụ thể như Pods, Namespaces hoặc Services. Máy chủ API thực thi việc khớp nhãn nghiêm ngặt giữa định nghĩa số liệu và bộ chọn khối lượng công việc mục tiêu. Nếu số liệu ứng dụng của bạn thiếu nhãn tên pod hoặc nhận dạng namespace, bộ điều hợp không thể ánh xạ giá trị vô hướng trở lại các phiên bản pod riêng lẻ. Việc tách rời này đảm bảo rằng các vòng lặp điều khiển cluster vẫn được cách ly khỏi các nhà cung cấp giám sát cụ thể trong khi vẫn mang lại cho các nhà điều hành nền tảng sự linh hoạt hoàn toàn để viết các truy vấn PromQL phức tạp.
+------------------+         Scrapes         +--------------------+
| Application Pod  | <---------------------- | Prometheus Server  |
|  (/metrics)      |                         |  (TSDB Storage)    |
+------------------+                         +--------------------+
         ^                                             ^
         |                                             | PromQL Queries
         | Managed By                                  v
+------------------+     Queries API         +--------------------+
| HPA Controller   | ----------------------> | Prometheus Adapter |
| (Control Loop)   |  custom.metrics.k8s.io  | (API Extension)    |
+------------------+                         +--------------------+
Làm thế nào để cấu hình các quy tắc Prometheus Adapter cho các số liệu tùy chỉnh?
Bạn cấu hình các quy tắc Prometheus Adapter cho các số liệu tùy chỉnh bằng cách chỉnh sửa Map cấu hình bộ điều hợp để định nghĩa các mẫu regex khớp chuỗi, liên kết tài nguyên, mẫu đặt tên số liệu và các truy vấn tổng hợp PromQL rõ ràng. Tệp cấu hình điều chỉnh cách các chuỗi số liệu Prometheus thô được dịch thành các endpoint API Kubernetes có thể truy vấn. Nếu không có các quy tắc bộ điều hợp rõ ràng, máy chủ API sẽ không hiển thị các số liệu ứng dụng tùy chỉnh của bạn cho bộ điều khiển Horizontal Pod Autoscaler.
Tệp cấu hình bao gồm bốn phần chính cho mỗi khối quy tắc: seriesQuery, resources, name và metricsQuery. seriesQuery chọn các chuỗi thời gian ứng cử viên từ Prometheus khớp với các mẫu tên số liệu và sự hiện diện của khóa nhãn cụ thể. Khối resources ánh xạ các nhãn số liệu Prometheus như kubernetes_pod_name hoặc namespace đến các loại tài nguyên API Kubernetes như pod và namespace. Khối name đổi tên số liệu Prometheus thô thành một tên số liệu rõ ràng được trình bày bởi API số liệu tùy chỉnh. Cuối cùng, metricsQuery định nghĩa biểu thức PromQL chính xác được sử dụng để tổng hợp các số liệu khi autoscaler yêu cầu các giá trị vô hướng.
Hãy để tôi chỉ cho bạn một khối cấu hình Helm values.yaml hoàn chỉnh, sẵn sàng cho sản xuất cho Prometheus Adapter, biến đổi tốc độ yêu cầu HTTP thô thành một số liệu cấp pod:
rules:
  default: false
  custom:
    - seriesQuery: 'http_requests_total{kubernetes_pod_name!="",kubernetes_namespace!=""}'
      resources:
        overrides:
          kubernetes_namespace: {resource: "namespace"}
          kubernetes_pod_name: {resource: "pod"}
      name:
        matches: "^(.*)_total"
        as: "${1}_per_second"
      metricsQuery: 'sum(rate(<<.Series>>{<<.LabelMatchers>>}[2m])) by (<<.GroupBy>>)'
    - seriesQuery: 'queue_depth_messages{kubernetes_pod_name!="",kubernetes_namespace!=""}'
      resources:
        overrides:
          kubernetes_namespace: {resource: "namespace"}
          kubernetes_pod_name: {resource: "pod"}
      name:
        matches: "^(.*)"
        as: "queue_depth_messages"
      metricsQuery: 'sum(<<.Series>>{<<.LabelMatchers>>}) by (<<.GroupBy>>)'
Hãy chú ý cách các biến mẫu như <<.Series>>, <<.LabelMatchers>> và <<.GroupBy>> làm cho việc đánh giá truy vấn trở nên động. Khi HPA yêu cầu số liệu http_requests_per_second cho các pod trong namespace default, Prometheus Adapter sẽ thay thế <<.Series>> bằng http_requests_total, điền <<.LabelMatchers>> bằng các bộ lọc tên pod và đặt <<.GroupBy>> thành kubernetes_pod_name. Việc thay thế tham số tự động này cho phép một mẫu quy tắc duy nhất phục vụ hàng trăm microservice riêng biệt chạy trên cluster của bạn mà không cần viết các truy vấn lặp lại cho mỗi ứng dụng.
Khi định nghĩa metricsQuery, bạn nên luôn sử dụng các hàm rate trong các khoảng thời gian ngắn như hai phút thay vì các giá trị gauge tức thời cho các số liệu counter. Các giá trị counter thô liên tục tăng theo thời gian, khiến chúng không phù hợp cho các ngưỡng mục tiêu trực tiếp. Áp dụng rate() chuyển đổi các counter thô thành tốc độ mỗi giây phản ánh thông lượng khối lượng công việc theo thời gian thực. Hơn nữa, việc đặt default: false trong cấu hình Helm của bạn ngăn bộ điều hợp tự động phát hiện hàng nghìn số liệu cluster không sử dụng, điều này làm giảm đáng kể chi phí CPU và mức tiêu thụ bộ nhớ trên các pod bộ điều hợp.
Làm thế nào để định nghĩa một HPA Manifest sử dụng các số liệu Prometheus tùy chỉnh?
Bạn định nghĩa một HPA manifest sử dụng các số liệu Prometheus tùy chỉnh bằng cách chỉ định v2 là apiVersion, chọn Pods hoặc Object làm loại nguồn số liệu và đặt ngưỡng số liệu mục tiêu trong mảng metrics. Đặc tả API Kubernetes autoscaling/v2 cung cấp hỗ trợ gốc cho nhiều loại số liệu bao gồm tài nguyên, pod tùy chỉnh, đối tượng và số liệu bên ngoài. Khi nhắm mục tiêu các số liệu tùy chỉnh cấp pod, bạn phải chọn type: Pods và đặt metric.name để khớp với tên chính xác được hiển thị bởi quy tắc Prometheus Adapter của bạn.
Trong đặc tả manifest HPA, type: Pods cho bộ điều khiển biết rằng giá trị số liệu đại diện cho một số liệu trên mỗi pod phải được tính trung bình trên tất cả các pod đang hoạt động trong khối lượng công việc mục tiêu. Mục tiêu số liệu phải sử dụng type: AverageValue với một lượng như 50 hoặc 500m (đại diện cho 0,5 yêu cầu mỗi giây). Bộ tự động điều chỉnh tổng hợp các giá trị số liệu trên tất cả các pod đang chạy, chia cho số lượng bản sao hiện tại và so sánh kết quả với giá trị trung bình mục tiêu đã chỉ định của bạn để quyết định có nên mở rộng quy mô hay thu nhỏ quy mô.
Dưới đây là một manifest sản xuất mở rộng quy mô một triển khai API dựa trên thông lượng yêu cầu HTTP trên mỗi pod:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: api-service-hpa
  namespace: production
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: api-service
  minReplicas: 3
  maxReplicas: 30
  metrics:
    - type: Pods
      pods:
        metric:
          name: http_requests_per_second
        target:
          type: AverageValue
          averageValue: "35"
Nếu bạn cần mở rộng quy mô triển khai của mình dựa trên một tài nguyên không có namespace hoặc một hệ thống bên ngoài như hàng đợi AWS SQS hoặc độ sâu danh sách Redis, bạn nên sử dụng type: External hoặc type: Object thay vì type: Pods. Ví dụ, khi mở rộng quy mô một triển khai worker hàng đợi nền, giá trị số liệu phản ánh tổng độ dài của hàng đợi thay vì một giá trị được đo bên trong các pod worker riêng lẻ. Trong trường hợp đó, việc đặt type: Value dưới một mục tiêu Object hoặc External cho phép HPA chia tổng độ dài hàng đợi cho dung lượng xử lý khối lượng công việc mong muốn trên mỗi pod.
Kết hợp nhiều nguồn số liệu trong một manifest HPA duy nhất cung cấp các đảm bảo mở rộng quy mô an toàn đáng tin cậy cho các triển khai quan trọng. Khi nhiều số liệu được cấu hình trong mảng metrics, Horizontal Pod Autoscaler tính toán số lượng bản sao được đề xuất cho từng số liệu một cách độc lập và chọn số lượng bản sao được tính toán cao nhất. Điều này có nghĩa là nếu mức sử dụng CPU đột ngột tăng vọt do một chu kỳ thu gom rác tốn kém trong khi tốc độ yêu cầu vẫn thấp, HPA vẫn sẽ mở rộng quy mô các pod để bảo vệ tính khả dụng của dịch vụ.
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 75
    - type: Pods
      pods:
        metric:
          name: http_requests_per_second
        target:
          type: AverageValue
          averageValue: "35"
Làm thế nào để khắc phục lỗi API số liệu tùy chỉnh và các chế độ lỗi HPA?
Bạn khắc phục lỗi API số liệu tùy chỉnh bằng cách truy vấn điểm cuối REST API số liệu tùy chỉnh thô với kubectl get --raw, kiểm tra nhật ký Prometheus Adapter để tìm lỗi thực thi PromQL và mô tả tài nguyên HPA để kiểm tra các điều kiện trạng thái. Khi HPA báo cáo unable to fetch metric hoặc invalid metric value, vấn đề hầu như luôn nằm ở sự không khớp nhãn hoặc lỗi cấu hình bộ điều hợp. Các truy vấn API trực tiếp cho phép bạn cô lập xem lỗi bắt nguồn từ việc nhập dữ liệu Prometheus, dịch truy vấn bộ điều hợp hay quyền RBAC của Kubernetes.
Bước đầu tiên trong việc chẩn đoán lỗi số liệu tùy chỉnh là xác minh rằng máy chủ API mở rộng đã được đăng ký và hoạt động tốt trong mặt phẳng điều khiển Kubernetes. Chạy kubectl get apiservices v1beta1.custom.metrics.k8s.io sẽ hiển thị AVAILABLE: True. Nếu trạng thái hiển thị false hoặc degraded, hãy kiểm tra xem triển khai Prometheus Adapter có đang chạy, hoạt động tốt và có thể truy cập qua TLS trên cổng 6443 hay không. Nếu xác minh chứng chỉ không thành công giữa bộ tổng hợp API và bộ điều hợp, các truy vấn số liệu tùy chỉnh sẽ ngay lập tức thất bại với lỗi từ chối kết nối.
Sau khi bạn xác nhận tình trạng dịch vụ API, hãy truy vấn trực tiếp điểm cuối số liệu tùy chỉnh thô bằng kubectl để xác minh việc hiển thị số liệu:
kubectl get --raw "/apis/custom.metrics.k8s.io/v1beta1/namespaces/production/pods/*/http_requests_per_second" | jq .
Nếu lệnh này trả về một danh sách mục trống, Prometheus Adapter không thể tìm thấy các chuỗi số liệu khớp trong Prometheus thỏa mãn seriesQuery và tiêu chí nhãn của quy tắc của bạn. Xác minh rằng các pod ứng dụng của bạn xuất số liệu với các khóa nhãn chính xác như kubernetes_pod_name hoặc pod. Các thiết lập lấy dữ liệu Prometheus phổ biến sử dụng ServiceMonitors thường đổi tên các nhãn pod thành pod_name hoặc instance. Nếu các khóa nhãn không khớp với các ghi đè quy tắc bộ điều hợp của bạn, bộ điều hợp không thể liên kết dữ liệu chuỗi thời gian với các tài nguyên pod Kubernetes, gây ra các phản hồi truy vấn API trống.
Kiểm tra phần điều kiện trạng thái của tài nguyên HPA của bạn bằng cách sử dụng kubectl describe hpa api-service-hpa -n production. Đầu ra lệnh bao gồm nhật ký sự kiện chi tiết và các điều kiện hoạt động như AbleToScale, ScalingActive và ScalingLimited. Nếu ScalingActive hiển thị False với lý do FailedGetResourceMetric, hãy xem lại nhật ký pod Prometheus Adapter của bạn bằng cách sử dụng kubectl logs -n monitoring -l app.kubernetes.io/name=prometheus-adapter. Tìm kiếm các lỗi cú pháp PromQL rõ ràng, cảnh báo hết thời gian chờ HTTP khi kết nối với Prometheus hoặc lỗi xác thực tiêu chuẩn.
Các chế độ lỗi hoạt động phổ biến và giải pháp nguyên nhân gốc của chúng bao gồm:
| Thông báo lỗi HPA quan sát được | Cơ chế nguyên nhân gốc | Bước khắc phục |
|---|---|---|
unable to fetch metric: no metrics returned | Không khớp khóa nhãn giữa quy tắc bộ điều hợp và Prometheus TSDB | Cập nhật ghi đè nhãn seriesQuery để khớp với các nhãn pod đã được lấy dữ liệu |
selector missing from metric | Thiếu ánh xạ tài nguyên pod trong quy tắc Prometheus Adapter | Đảm bảo resources.overrides ánh xạ nhãn Prometheus tới pod |
API server request timeout | Máy chủ Prometheus gặp khó khăn dưới tải truy vấn PromQL nặng | Tối ưu hóa metricsQuery của bộ điều hợp hoặc tăng tài nguyên Prometheus |
invalid metric value: scalar expected | Truy vấn PromQL trả về vector không có nhóm nhãn pod | Thêm tổng hợp by (<<.GroupBy>>) vào PromQL quy tắc bộ điều hợp |
Làm thế nào để điều chỉnh hành vi mở rộng quy mô HPA và các cửa sổ ổn định?
Bạn điều chỉnh hành vi mở rộng quy mô HPA bằng cách cấu hình trường behavior bên trong đặc tả autoscaling/v2 để đặt các cửa sổ ổn định mở rộng quy mô và thu nhỏ quy mô rõ ràng, giới hạn tốc độ và chính sách kích thước bước. Theo mặc định, bộ điều khiển HPA mở rộng quy mô nhanh chóng khi các ngưỡng số liệu bị vi phạm nhưng đợi năm phút trước khi thực hiện các hành động thu nhỏ quy mô để ngăn chặn sự dao động nhanh chóng. Tùy chỉnh các cửa sổ ổn định này đảm bảo phản ứng mở rộng quy mô nhanh chóng trong các đợt tăng lưu lượng đột ngột trong khi ngăn chặn việc chấm dứt pod sớm trong các đợt lưu lượng tạm thời thấp.
Phần behavior cung cấp cho các kỹ sư hệ thống quyền kiểm soát chi tiết về tốc độ mở rộng quy mô theo cả hai hướng bằng cách sử dụng các khối chính sách scaleUp và scaleDown. Mỗi khối hỗ trợ cài đặt stabilizationWindowSeconds cùng với một mảng policies rõ ràng. stabilizationWindowSeconds khiến bộ tự động điều chỉnh giữ lại các khuyến nghị đã tính toán trước đó trong một khoảng thời gian nhất định, chọn khuyến nghị cao nhất cho các hoạt động mở rộng quy mô và khuyến nghị thấp nhất cho các hoạt động thu nhỏ quy mô. Thuật toán này làm mượt nhiễu số liệu do các tác vụ nền đột ngột hoặc các đợt tăng lưu lượng ngắn hạn.
Dưới đây là cấu hình hành vi nâng cao cho phép mở rộng quy mô mạnh mẽ trong khi áp dụng thu nhỏ quy mô thận trọng:
spec:
  behavior:
    scaleUp:
      stabilizationWindowSeconds: 0
      selectPolicy: Max
      policies:
        - type: Percent
          value: 100
          periodSeconds: 15
        - type: Pods
          value: 4
          periodSeconds: 15
    scaleDown:
      stabilizationWindowSeconds: 300
      selectPolicy: Min
      policies:
        - type: Percent
          value: 10
          periodSeconds: 60
Trong cấu hình sản xuất này, việc đặt stabilizationWindowSeconds: 0 cho scaleUp hướng dẫn bộ tự động điều chỉnh phản ứng ngay lập tức với các đợt tăng đột biến số liệu mà không cần chờ làm mượt số liệu. Chỉ thị selectPolicy: Max đảm bảo rằng nếu cả hai chính sách được đánh giá, chính sách tạo ra số lượng pod cao hơn sẽ có hiệu lực. HPA có thể tăng gấp đôi số lượng bản sao (tăng 100%) hoặc thêm tối đa 4 pod sau mỗi 15 giây, tùy theo giá trị nào lớn hơn. Điều này ngăn chặn tình trạng cạn kiệt dung lượng pod khi lưu lượng truy cập khách hàng không mong muốn tấn công các điểm cuối sản xuất của bạn.
Ngược lại, cấu hình scaleDown đặt stabilizationWindowSeconds: 300 (năm phút) để đảm bảo rằng khối lượng lưu lượng truy cập vẫn ổn định thấp trước khi chấm dứt các pod. Tốc độ thu nhỏ quy mô bị giới hạn nghiêm ngặt ở 10% của số lượng bản sao hiện có mỗi phút (periodSeconds: 60). Việc làm chậm quá trình chấm dứt pod ngăn chặn các kịch bản quá tải theo tầng, nơi việc chấm dứt pod buộc các pod còn lại phải xử lý lưu lượng truy cập quá mức, gây ra các chu kỳ mở rộng quy mô lại ngay lập tức.
Khi điều chỉnh hành vi mở rộng quy mô, bạn cũng phải căn chỉnh khoảng thời gian lấy dữ liệu Prometheus với vòng lặp đánh giá HPA của bạn. Nếu Prometheus lấy dữ liệu số liệu mỗi ba mươi giây nhưng bộ điều hợp của bạn tính toán mức trung bình hai phút, các đợt tăng lưu lượng ngắn dưới ba mươi giây có thể không kích hoạt các hành động mở rộng quy mô. Đảm bảo các bộ lấy dữ liệu ứng dụng của bạn chạy mỗi mười đến mười lăm giây cho các khối lượng công việc mở rộng quy mô tần số cao và cấu hình các cửa sổ tốc độ PromQL của bộ điều hợp của bạn để bao gồm ít nhất bốn khoảng thời gian lấy dữ liệu để ngăn chặn các sự cố số liệu tạm thời.
Làm thế nào để giám sát các số liệu hiệu suất HPA trong các bảng điều khiển Grafana sản xuất?
Bạn giám sát các số liệu hiệu suất HPA trong các bảng điều khiển Grafana sản xuất bằng cách theo dõi kube_horizontalpodautoscaler_status_current_replicas, kube_horizontalpodautoscaler_status_desired_replicas và mức độ bão hòa mục tiêu số liệu tùy chỉnh theo thời gian. Việc tích hợp dữ liệu đo từ xa HPA vào các bảng điều khiển tập trung cho phép các kỹ sư nền tảng xác định các ngưỡng mở rộng quy mô bị cấu hình sai, phát hiện các dao động mở rộng quy mô và đánh giá kế hoạch dung lượng khối lượng công việc. Nếu không có khả năng hiển thị bảng điều khiển chuyên dụng, các sự kém hiệu quả trong việc mở rộng quy mô có thể âm thầm làm giảm độ trễ phản hồi của ứng dụng hoặc làm tăng chi phí cơ sở hạ tầng đám mây.
Prometheus xuất dữ liệu đo từ xa HPA của Kubernetes thông qua kube-state-metrics, cung cấp khả năng hiển thị theo thời gian thực về các quyết định vòng lặp điều khiển của bộ tự động điều chỉnh. Các số liệu chính bao gồm kube_horizontalpodautoscaler_spec_min_replicas, kube_horizontalpodautoscaler_spec_max_replicas và kube_horizontalpodautoscaler_status_desired_replicas. Bằng cách vẽ biểu đồ số lượng bản sao mong muốn so với số lượng bản sao pod đang chạy thực tế, bạn có thể đo độ trễ mở rộng quy mô và xác định xem thời gian khởi động container có làm chậm việc mở rộng dung lượng khối lượng công việc hay không.
Dưới đây là một biểu thức PromQL sản xuất để tính toán độ bão hòa khoảng trống mở rộng quy mô HPA trên cluster của bạn:
sum(kube_horizontalpodautoscaler_status_current_replicas{namespace="production"}) by (horizontalpodautoscaler)
/
sum(kube_horizontalpodautoscaler_spec_max_replicas{namespace="production"}) by (horizontalpodautoscaler) * 100
Khi truy vấn độ bão hòa này đạt gần một trăm phần trăm, triển khai của bạn đã đạt đến giới hạn bản sao tối đa và không thể mở rộng thêm để đáp ứng các đợt tăng lưu lượng truy cập. Thiết lập cảnh báo Grafana về độ bão hòa HPA cao sẽ thông báo cho các nhóm SRE trực ban tăng giới hạn maxReplicas trước khi độ trễ yêu cầu ứng dụng vi phạm các giới hạn SLA.
Có, bạn có thể mở rộng quy mô các triển khai Kubernetes bằng cách sử dụng các số liệu từ các nhà cung cấp SaaS bên ngoài bằng cách triển khai các bộ điều hợp số liệu do nhà cung cấp cung cấp như Datadog Cluster Agent hoặc KEDA (Kubernetes Event-driven Autoscaling). Trong manifest HPA của bạn, hãy đặt type: External và chỉ định tên số liệu được định nghĩa bởi bộ điều hợp của nhà cung cấp của bạn.
Custom Metrics (custom.metrics.k8s.io) được gắn trực tiếp vào các đối tượng cluster Kubernetes như Pods hoặc Services. External Metrics (external.metrics.k8s.io) đại diện cho các số liệu toàn cầu tồn tại độc lập với các đối tượng cluster cụ thể, chẳng hạn như độ dài hàng đợi AWS SQS hoặc độ trễ cơ sở dữ liệu bên ngoài.
Xác minh rằng các quy tắc đã được tải bằng cách chạy kubectl get --raw "/apis/custom.metrics.k8s.io/v1beta1". Lệnh này trả về một danh sách JSON đầy đủ tất cả các số liệu tùy chỉnh được hiển thị bởi bộ điều hợp trên các namespace của cluster.
Điều này xảy ra khi Prometheus thiếu các số liệu đã được lấy dữ liệu cho các pod mục tiêu, các bộ so khớp nhãn bị cấu hình sai trong các quy tắc bộ điều hợp hoặc các pod mới được triển khai. Xác minh rằng Prometheus đang tích cực lấy dữ liệu các số liệu mục tiêu và tên nhãn chuỗi khớp với cấu hình bộ điều hợp của bạn.
Bạn cũng có thể thích
- Thiết kế cảnh báo và tỷ lệ đốt Prometheus Grafana
- Kiểm tra tải phân tán và phân tích hiệu suất k6 Grafana
- Kiểm thử hợp đồng Microservices với Pact & Node.js
- Kiểm thử E2E Playwright: 4 quy tắc cho các bài kiểm thử không lỗi
Câu hỏi thường gặp
Kubernetes HPA là gì?
Kubernetes Horizontal Pod Autoscaler (HPA) tự động điều chỉnh số lượng bản sao pod trong một Deployment hoặc StatefulSet dựa trên các số liệu quan sát được. Theo mặc định, nó điều chỉnh dựa trên mức sử dụng CPU và bộ nhớ, nhưng với API số liệu tùy chỉnh, nó có thể điều chỉnh dựa trên bất kỳ số liệu Prometheus nào — tốc độ yêu cầu HTTP, độ sâu hàng đợi, phần trăm độ trễ hoặc bất kỳ tín hiệu cấp doanh nghiệp nào.
Kubernetes HPA có thể điều chỉnh dựa trên các số liệu tùy chỉnh thay vì CPU không?
Có. HPA v2 hỗ trợ ba nguồn số liệu: Số liệu tài nguyên (CPU/bộ nhớ), Số liệu tùy chỉnh từ các pod của riêng bạn thông qua API số liệu tùy chỉnh và Số liệu bên ngoài từ các hệ thống bên ngoài cluster. Bằng cách cài đặt Prometheus Adapter, bạn kết nối các truy vấn PromQL của Prometheus vào API số liệu tùy chỉnh của Kubernetes để HPA có thể sử dụng chúng trực tiếp làm tín hiệu điều chỉnh.
Prometheus Adapter là gì và tại sao tôi cần nó?
Prometheus Adapter là một tiện ích mở rộng máy chủ API Kubernetes dịch các truy vấn số liệu Prometheus sang định dạng mà API số liệu tùy chỉnh của Kubernetes mong đợi. Nếu không có nó, HPA không thể đọc các số liệu Prometheus. Bạn cài đặt nó qua Helm, định nghĩa các quy tắc ánh xạ các biểu thức PromQL tới các tên số liệu Kubernetes và tham chiếu các tên số liệu đó trong manifest HPA của bạn.
Làm thế nào để viết một manifest Kubernetes HPA v2 cho các số liệu tùy chỉnh?
Đặt apiVersion: autoscaling/v2 và dưới spec.metrics sử dụng type: Pods với pods.metric.name khớp với quy tắc bạn đã định nghĩa trong Prometheus Adapter. Đặt pods.target.averageValue thành ngưỡng trên mỗi pod. Bộ điều khiển HPA thăm dò API số liệu tùy chỉnh cứ sau 15 giây theo mặc định và điều chỉnh các bản sao để giữ số liệu ở mức trung bình mục tiêu trên tất cả các pod.
Làm thế nào để khắc phục sự cố HPA không điều chỉnh dựa trên các số liệu tùy chỉnh?
Chạy kubectl describe hpa <name> để xem giá trị số liệu hiện tại và bất kỳ điều kiện lỗi nào. Các nguyên nhân gây lỗi phổ biến: Prometheus Adapter chưa được cài đặt hoặc cấu hình sai, tên số liệu trong đặc tả HPA không khớp với tên quy tắc bộ điều hợp, Prometheus không lấy dữ liệu pod mục tiêu hoặc thiếu quyền RBAC. Sử dụng kubectl get --raw "/apis/custom.metrics.k8s.io/v1beta1" để xác minh API số liệu có thể truy cập được và số liệu của bạn được liệt kê.
Free In-Browser Developer Tools
Clean AI CLI logs, build cron expressions, decode JWTs, and calculate chmod permissions offline.
Related Articles
Triển khai Zero-Downtime trên Kubernetes: Pod Disruption Budgets, PreStop Hooks và Graceful Shutdown
Đạt được triển khai thực sự không gián đoạn (zero-downtime) trên Kubernetes. Cấu hình Pod Disruption Budgets, terminationGracePeriodSeconds, preStop hooks và cơ chế connection draining của ingress.
Read more
ArgoCD GitOps: Các mô hình triển khai đa cụm
Nắm vững GitOps đa cụm bằng cách sử dụng ArgoCD ApplicationSets, kiến trúc cụm Hub-and-Spoke, sync waves và environment value overlays.
Read more
Tăng cường bảo mật cho GitHub Actions Self-Hosted Runner
Tăng cường bảo mật cho GitHub Actions runner tự host bằng Actions Runner Controller (ARC), cô lập mạng, container không root và OIDC token có thời hạn ngắn.
Read more